Стратегия, процессы, сайты/дизайн под ключ, реклама/SMM, тексты
- Город
- Москва
- Опыт работы
- 16 лет
- На сайте с
- 2024 года
- Юридический статус
- ИП
Часть аудитории перестала доходить до сайта: человек задаёт вопрос ассистенту и получает готовый ответ со ссылками на два-три источника. В обычной поисковой выдаче компания была видна, в ответах ассистентов — нет.
При этом непонятно было главное: за счёт чего туда вообще попадают и как проверить, стало лучше или нет. Задача — сделать видимость в ответах управляемой и измеримой, а не предметом догадок.
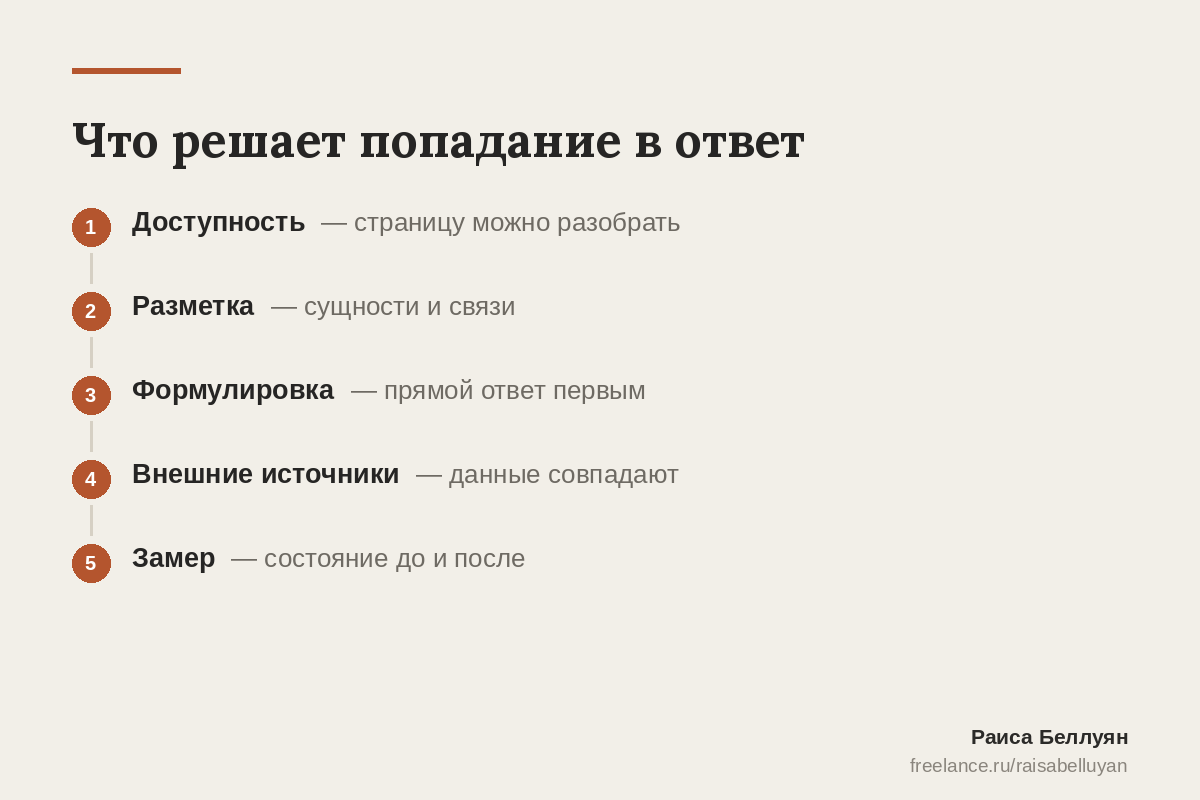
Начала с разведения двух вещей, которые обычно путают. Машиночитаемый сайт и сайт, который цитируют, — не одно и то же. Разметка, чистый код, карта сайта и машиночитаемое описание делают страницу разбираемой. Но в ответ попадает та, у которой есть удобная для цитаты формулировка: короткий прямой ответ с числом, условием и датой, а не мысль, размазанная по трём абзацам.
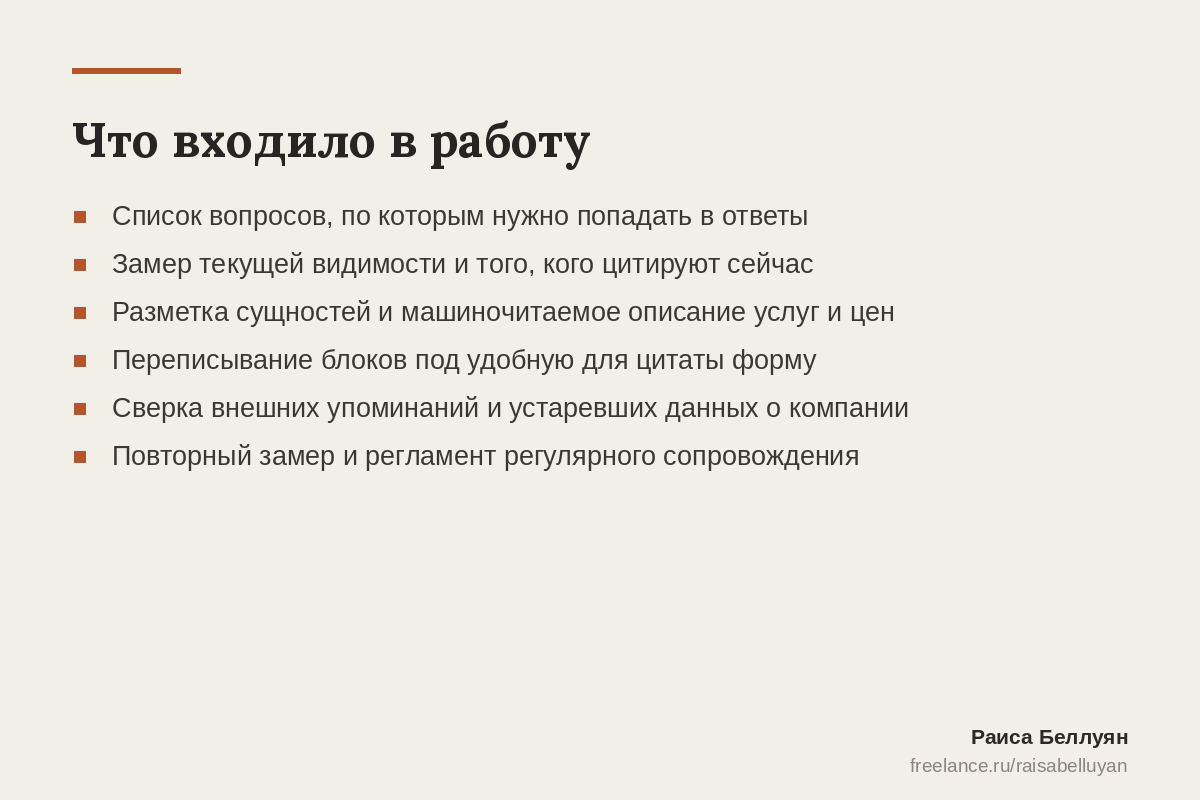
Поэтому работа шла в два слоя. Технический: разметка сущностей, структура заголовков, машиночитаемое описание услуг и цен, доступность страниц для разбора. Содержательный: переписывание ключевых блоков так, чтобы ответ на вопрос стоял первым, а обоснование — после него.
Третий слой — внешний. Ответ собирается не из одной страницы: модель подтягивает каталоги, справочники и отзывы, и устаревшая цена на стороннем ресурсе перебивает свежую страницу на сайте. Поэтому в работу входит сверка внешних упоминаний.
И отдельно — замер. Без него услуга превращается в набор действий, за которые непонятно, сколько платить. Фиксируется список вопросов, по которым компания хочет попадать в ответы, и регулярно снимается, что отвечают ассистенты и кого они при этом цитируют.
Список целевых вопросов, замер «до» и «после» по каждому, внедрённая разметка, переписанные блоки на ключевых страницах, приведённые в порядок внешние упоминания.
Понятно, какая страница отвечает за какой вопрос, и видно, кого ассистенты цитируют вместо компании и почему именно его.
Дальше работа идёт циклом: замер, правка формулировок, повторный замер. Видимость проверяется числом, а не ощущением, и по ней можно принимать решение о продолжении.