Сервисы российского онлайн-кинотеатра с лицензионными фильмами и сериалами переехали с вручную собранных виртуальных машин в облачный кластер. Сделал это Евгений Росляков: управляемый Kubernetes, инфраструктура на Terraform, серверы вне кластера через Ansible, наблюдение через Prometheus и Kibana. Он занимается серверами и сайтами с 2016 года, оформлен самозанятым, подписывает договор и даёт организациям закрывающие документы. Москва, остальные города — удалённо.
Нагрузка у кинотеатра скачет: днём тихо, вечером и в выходные зрителей в разы больше. Сервисы работали на десятке виртуальных машин, настроенных руками разных людей в разное время. Чем одна машина отличается от другой, никто не мог сказать уверенно.
По вечерам API каталога и авторизации не справлялись. Страницы открывались медленно, вход через раз отдавал ошибку. Новый сервер поднимали руками, уходило полдня: создать машину, поставить пакеты, перенести настройки, ничего не забыть.
Логи лежали на самих машинах. Чтобы понять, что случилось у конкретного зрителя, инженер по очереди заходил на несколько серверов и искал нужную строку.
Нужно было, чтобы сервисы сами растягивались под пик, выкладка шла без простоя, а в любой момент было видно, что творится.
Решение
Взял российского облачного провайдера с управляемым Kubernetes: управляющими узлами кластера занимается провайдер, а мне и инженерам кинотеатра остаются сервисы. Когда за кластером некому следить круглосуточно, это важно.
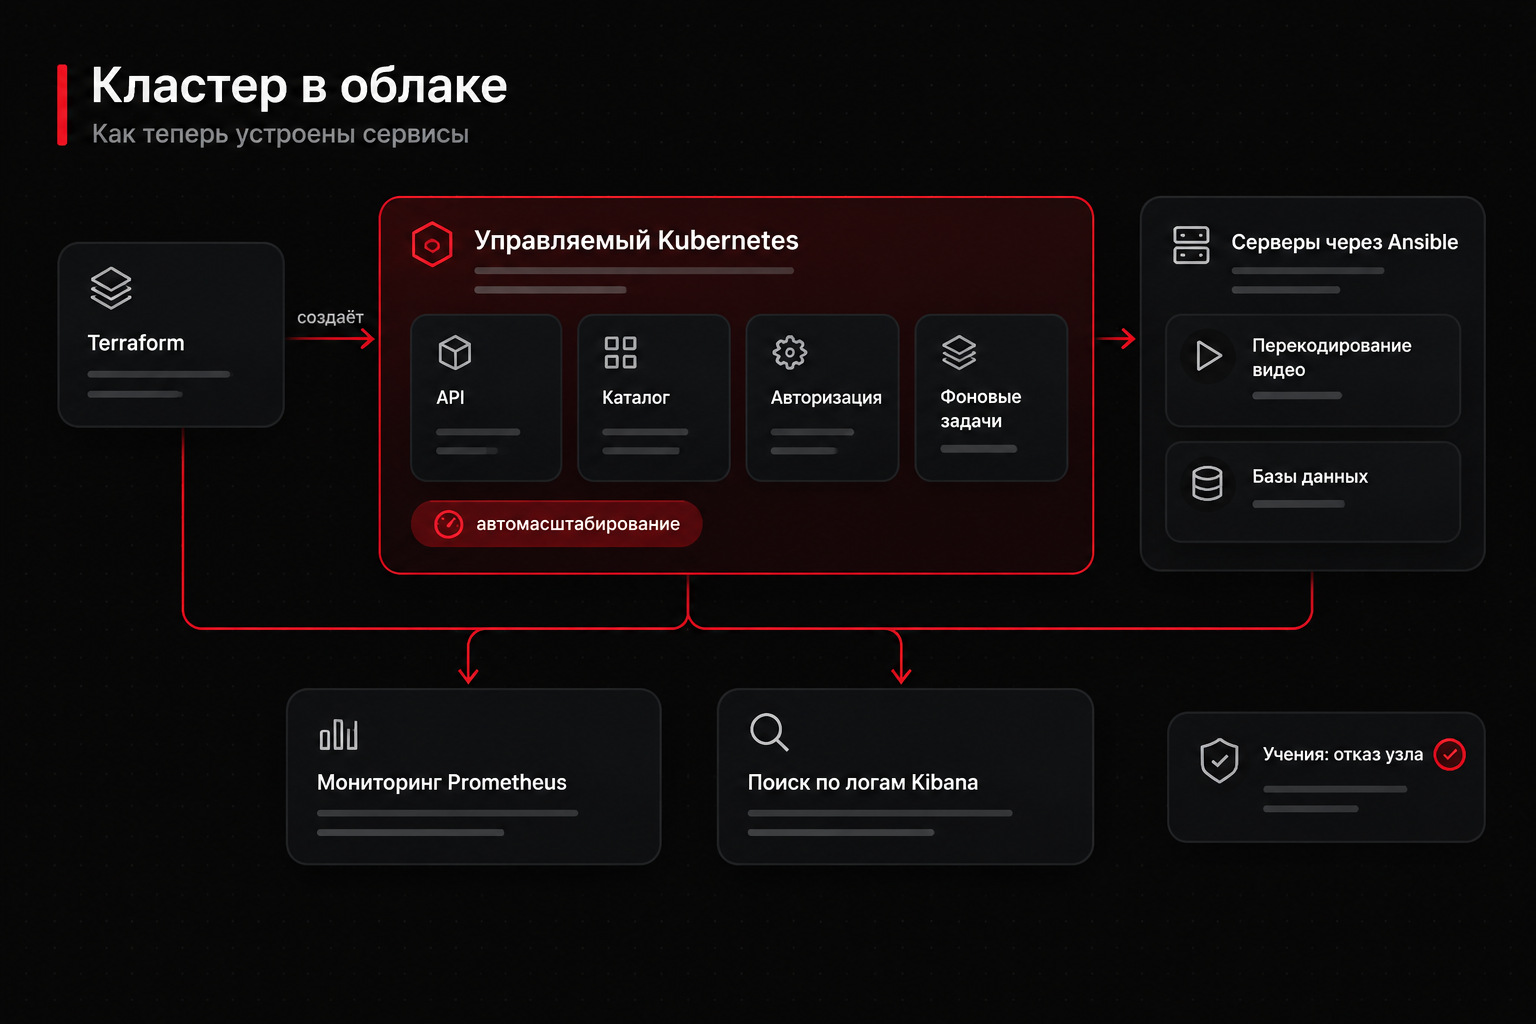
Всю инфраструктуру описал в Terraform: сети, кластер, базы данных, объектное хранилище. Провайдеры Terraform подтягиваются через зеркало облачного провайдера, а не из зарубежного реестра, поэтому установка не зависит от доступа к внешним сайтам. Тестовое окружение поднимается той же командой, что и боевое, и любое изменение сначала видно в плане.
В Kubernetes переехали API, каталог, авторизация и фоновые задачи. Каждый сервис упакован в контейнер, для каждого заданы запросы ресурсов и проверки здоровья. Автоматическое масштабирование смотрит на нагрузку: вечером подов и узлов становится больше, ночью меньше. Выкладка идёт постепенно, новая версия заменяет старую по частям, и если что-то не так, откат занимает несколько минут.
В кластер подходило не всё. Серверы перекодирования видео работают на видеокартах, а базы данных хранят состояние. Их оставил вне Kubernetes и настроил через Ansible. Роль описывает пакеты, драйверы, пользователей и службы, поэтому новый сервер получается таким же, как предыдущий.
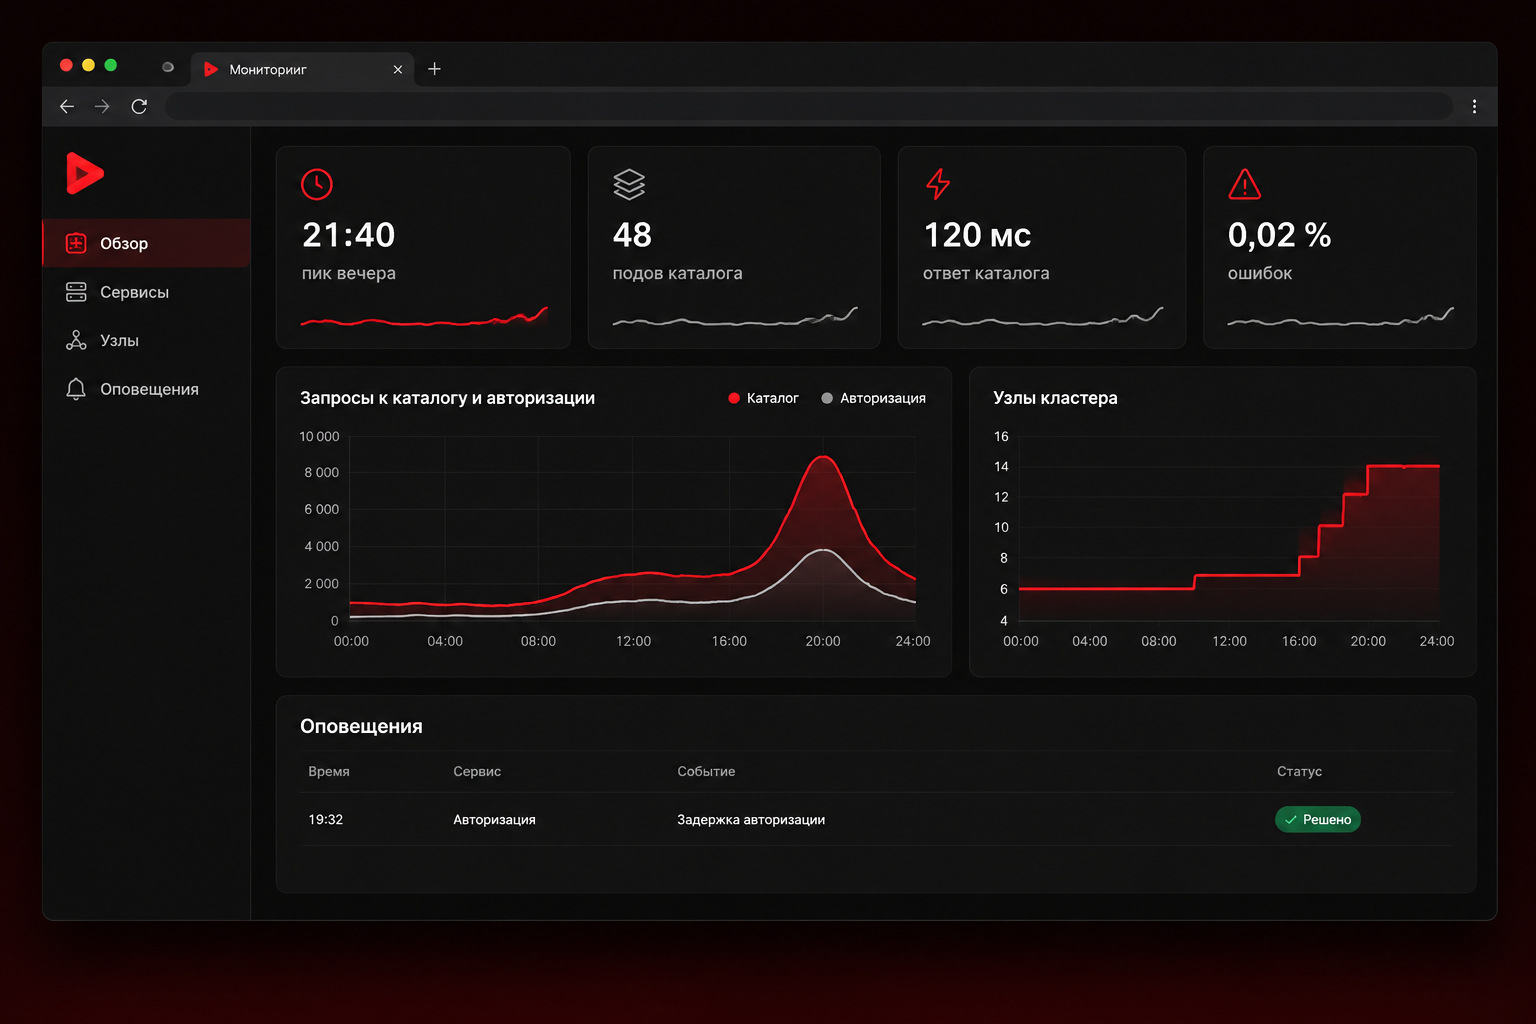
Мониторинг Prometheus собирает метрики сервисов и узлов: задержки, ошибки, загрузку. Оповещения приходят в чат дежурных, когда время ответа растёт или ошибок больше нормы. Дашборды показывают вечерний пик так, как его видят зрители.
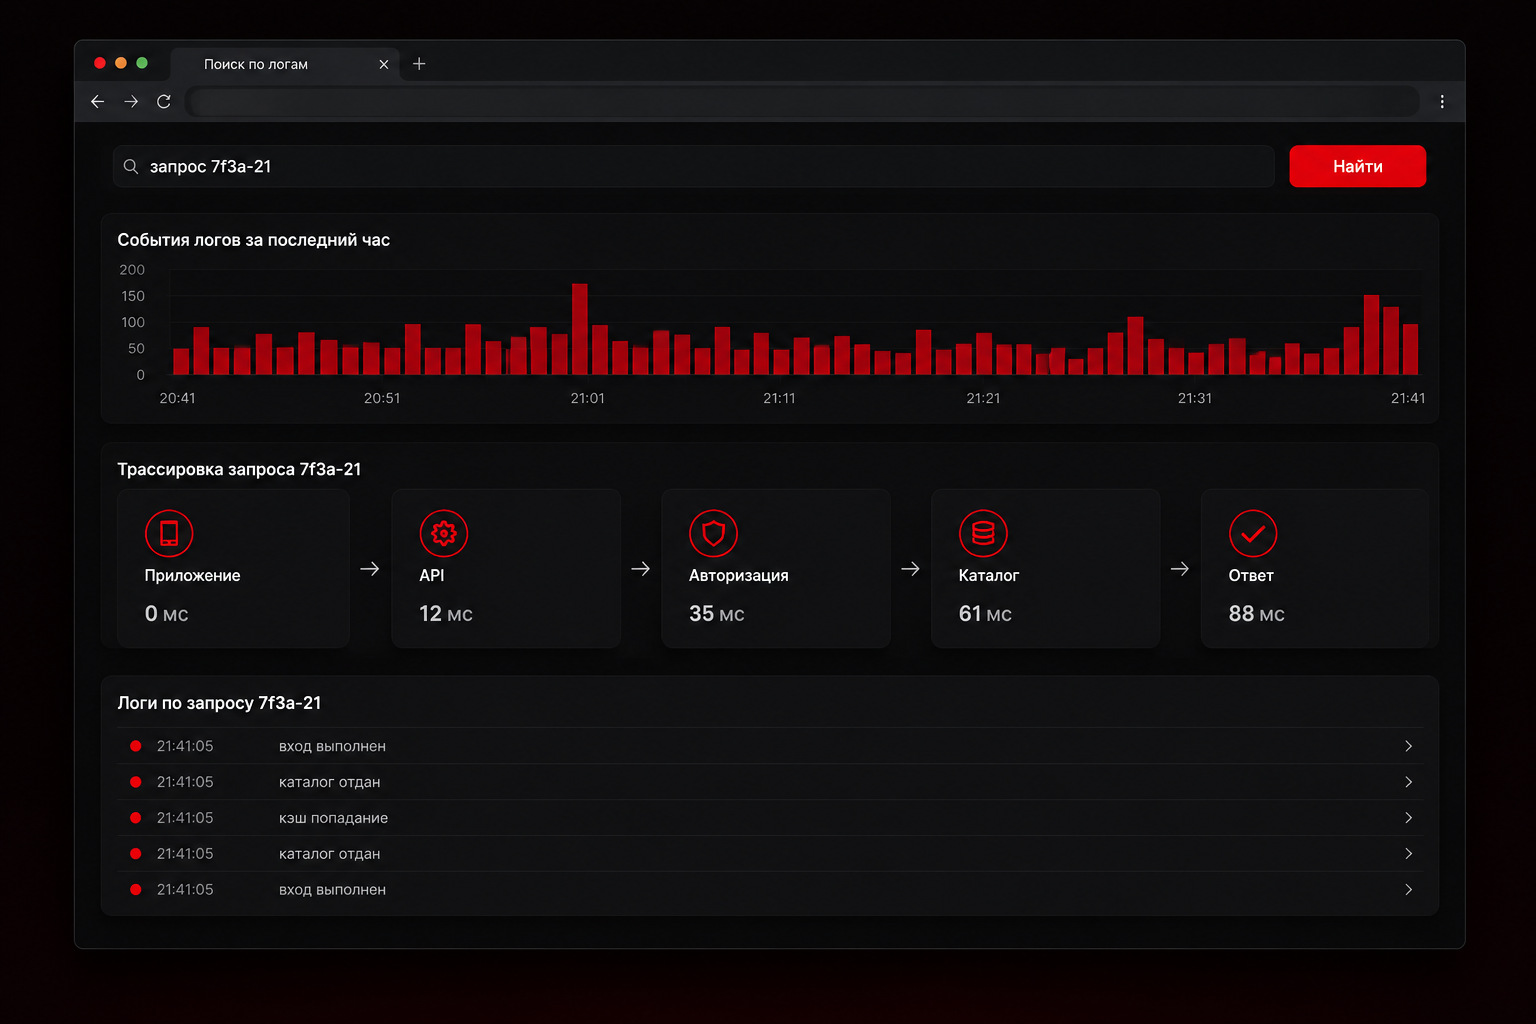
Логи всех сервисов стекаются в одно хранилище, поиск идёт в Kibana. Ввёл идентификатор запроса — увидел его путь через все сервисы.
Напоследок вместе с инженерами кинотеатра провёл учения. Посреди вечера выключили узел кластера и посмотрели, как справится система. Сервисы перезапустились на других узлах, зрители почти ничего не заметили.
Результат
Вечерние пики перестали быть проблемой. Каталог и авторизация держат нагрузку, а лишние узлы освобождаются, когда зрители расходятся. Платить за мощности под вечерний максимум круглые сутки больше не приходится.
Новое окружение появляется по описанию, а не по памяти. Раньше подъём сервера занимал полдня и зависел от того, кто его делал. Теперь это команда и проверенный план.
Выкладки перестали пугать. Разработчики выпускают версию днём, а не ждут ночи. Если новая сборка ведёт себя плохо, её откатывают, пока зрители не успели заметить.
Поиск причин сократился с обхода серверов до одного запроса в Kibana. Дежурные получают сообщение раньше, чем зритель напишет в поддержку.
Остались ограничения. Серверы перекодирования пока вне кластера: их настраивают одинаково, но масштабирование по-прежнему требует ручного решения. Доставка видео зрителям через сеть доставки в эту работу не входила, её решают отдельно. Кластер сам по себе не чинит медленный код сервисов: если запрос тяжёлый, он останется тяжёлым, только упрётся позже.
Дальше инженеры кинотеатра хотят перевести под управление Terraform оставшиеся мелкие сервисы и повторять учения по отказу раз в сезон.
Когда сервис падает по вечерам, а серверы настроены руками, начинать лучше с описания того, что есть. Напишите мне на freelance.ru, как всё устроено сейчас, и я скажу, что переносить первым.
Презентация проекта
Оценили проект:
Оценили проект
Авторизация
Для того чтобы оценивать проекты, вам нужно войти на сайт