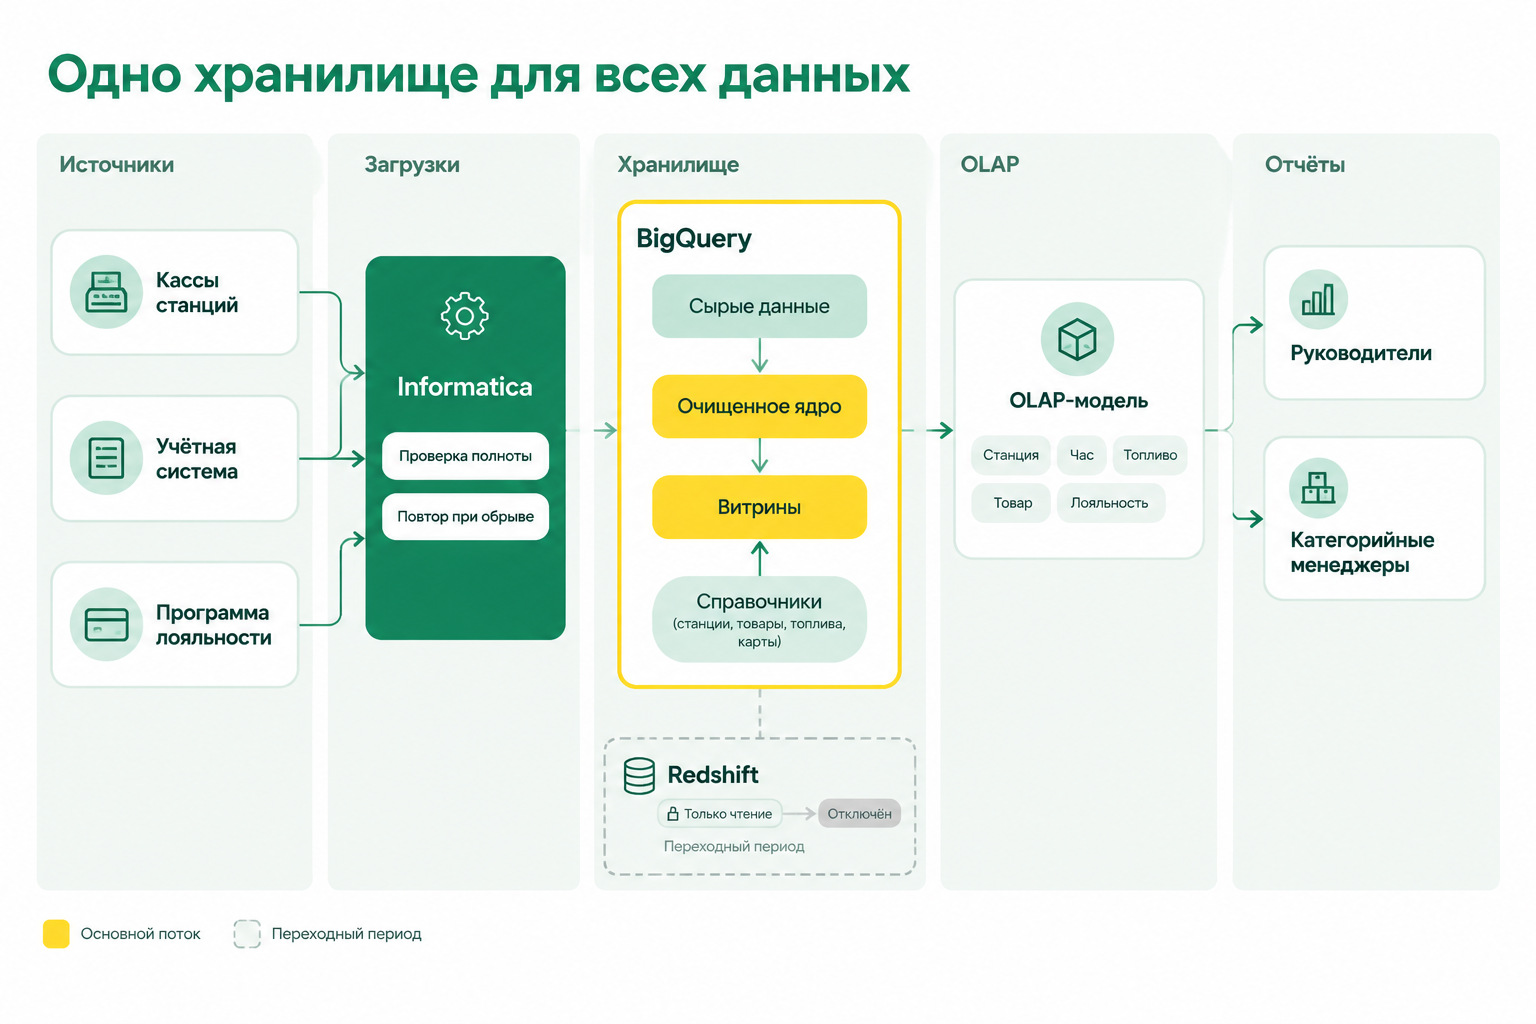
Для сети АЗС с магазинами и кафе в Армении Евгений Росляков свёл продажи с касс, данные учётной системы и программу лояльности в одно хранилище на BigQuery и собрал для руководителей OLAP-отчёты. Он делает сайты, работает с данными и учётными системами с 2016 года; самозанятый, договор подписывает до старта, закрывающие документы для юрлиц оформляет. Находится в Москве, с клиентами из других стран общается удалённо.
Сеть работает в Ереване и на трассах. Цены в драмах, станций много, магазины и кафе добавляют свой поток чеков. Прежний подрядчик построил хранилище в Amazon Redshift. Данные мобильного приложения и карт лояльности копились отдельно, в BigQuery. Загрузки из касс и учётной системы шли через Informatica.
В итоге у финансистов и маркетологов выручка за один и тот же день не сходилась. Каждый считал по своему источнику и со своими справочниками: одну станцию в трёх системах называли по-разному. Отчёты по часам и станциям строились долго, а категорийные менеджеры просили выгрузки у аналитика.
Задача: оставить одну платформу, один набор справочников и одни цифры, не останавливая ежедневные загрузки. Заодно подготовить почву для моделей прогноза спроса: на разрозненных данных они всё равно не заработают.
Решение
Начал с инвентаризации: какие таблицы есть в Redshift и BigQuery, откуда они наполняются, кто ими пользуется. Заметная часть оказалась копиями друг друга.
Data Warehousing построил по слоям. Первый слой — сырые данные в том виде, в каком их прислали кассы и учётная система. Второй — очищенное ядро, где чеки, позиции, смены и платежи приведены к одному виду. Третий — витрины под вопросы бизнеса. Справочники станций, товаров, видов топлива и карт лояльности ведутся в одном месте: открылась новая станция, и она сразу видна во всех отчётах.
Платформу оставил одну — BigQuery. Аналитика приложения лежала там уже, оплата идёт за объём прочитанных данных, а таблицы разбиты на разделы по дате, так что отчёт за неделю не читает архив за годы. Клиенту, который считает расходы в драмах, это важно.
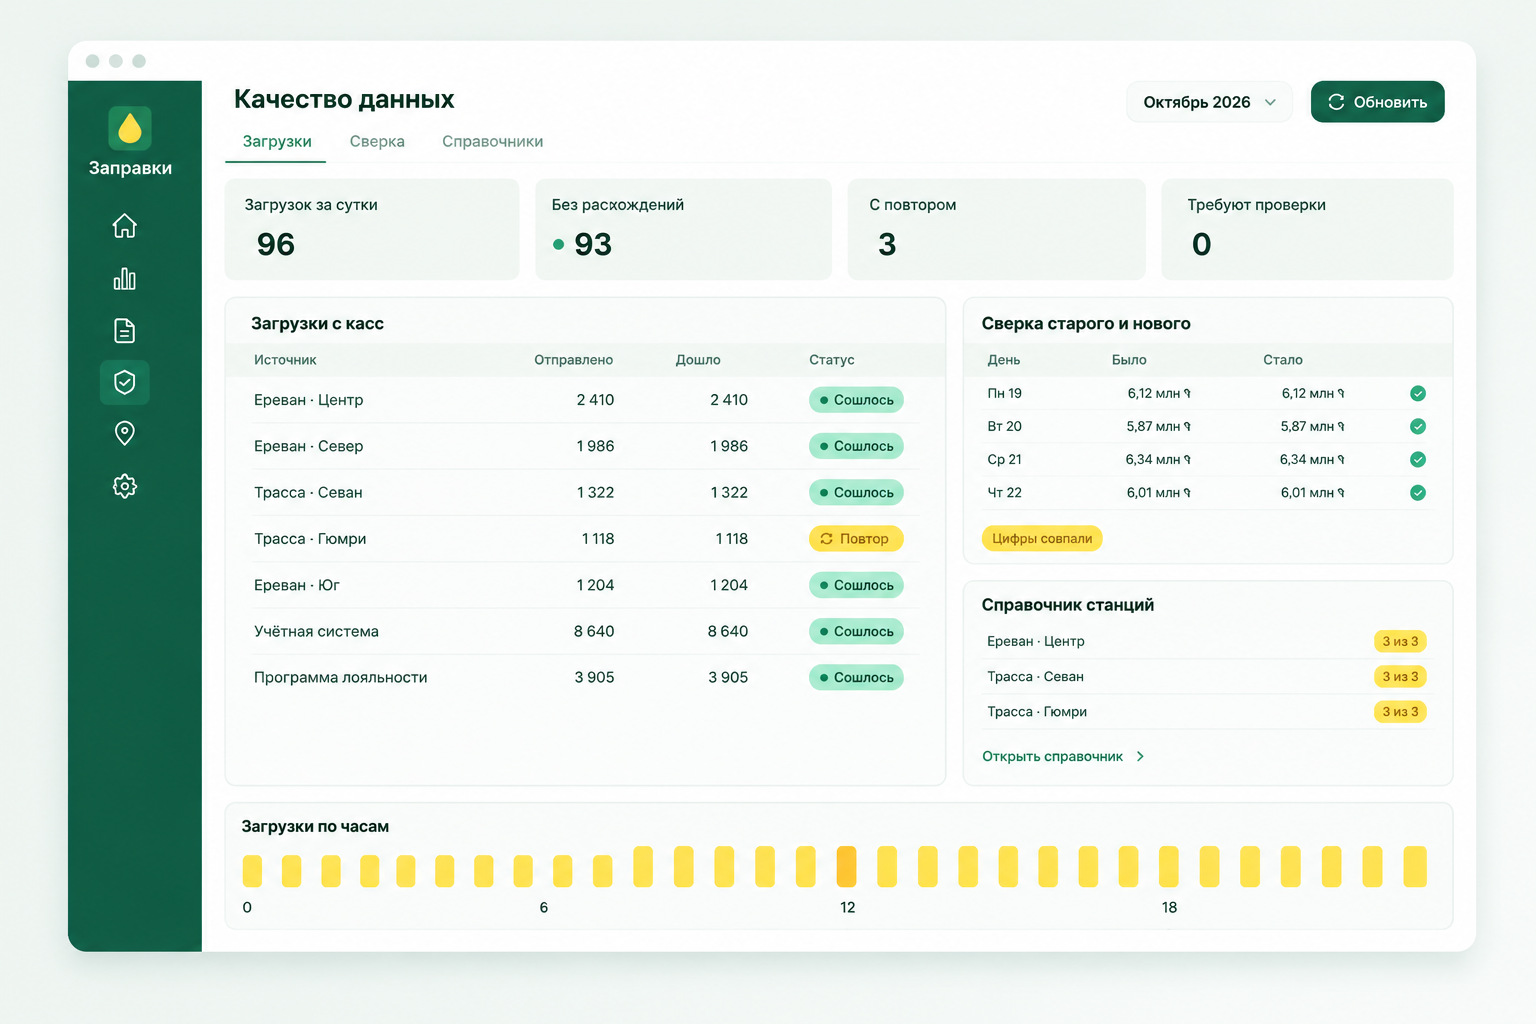
Загрузки на Informatica переделал под новое хранилище. Каждая проверяет полноту: сколько чеков ушло с кассы и сколько дошло. Оборвалась связь, загрузка повторяется сама, а расхождение попадает в журнал, который читает администратор данных.
Redshift на переходный период оставил только для чтения, чтобы аналитики сверяли старые отчёты. Когда сверка закончилась, кластер отключили.
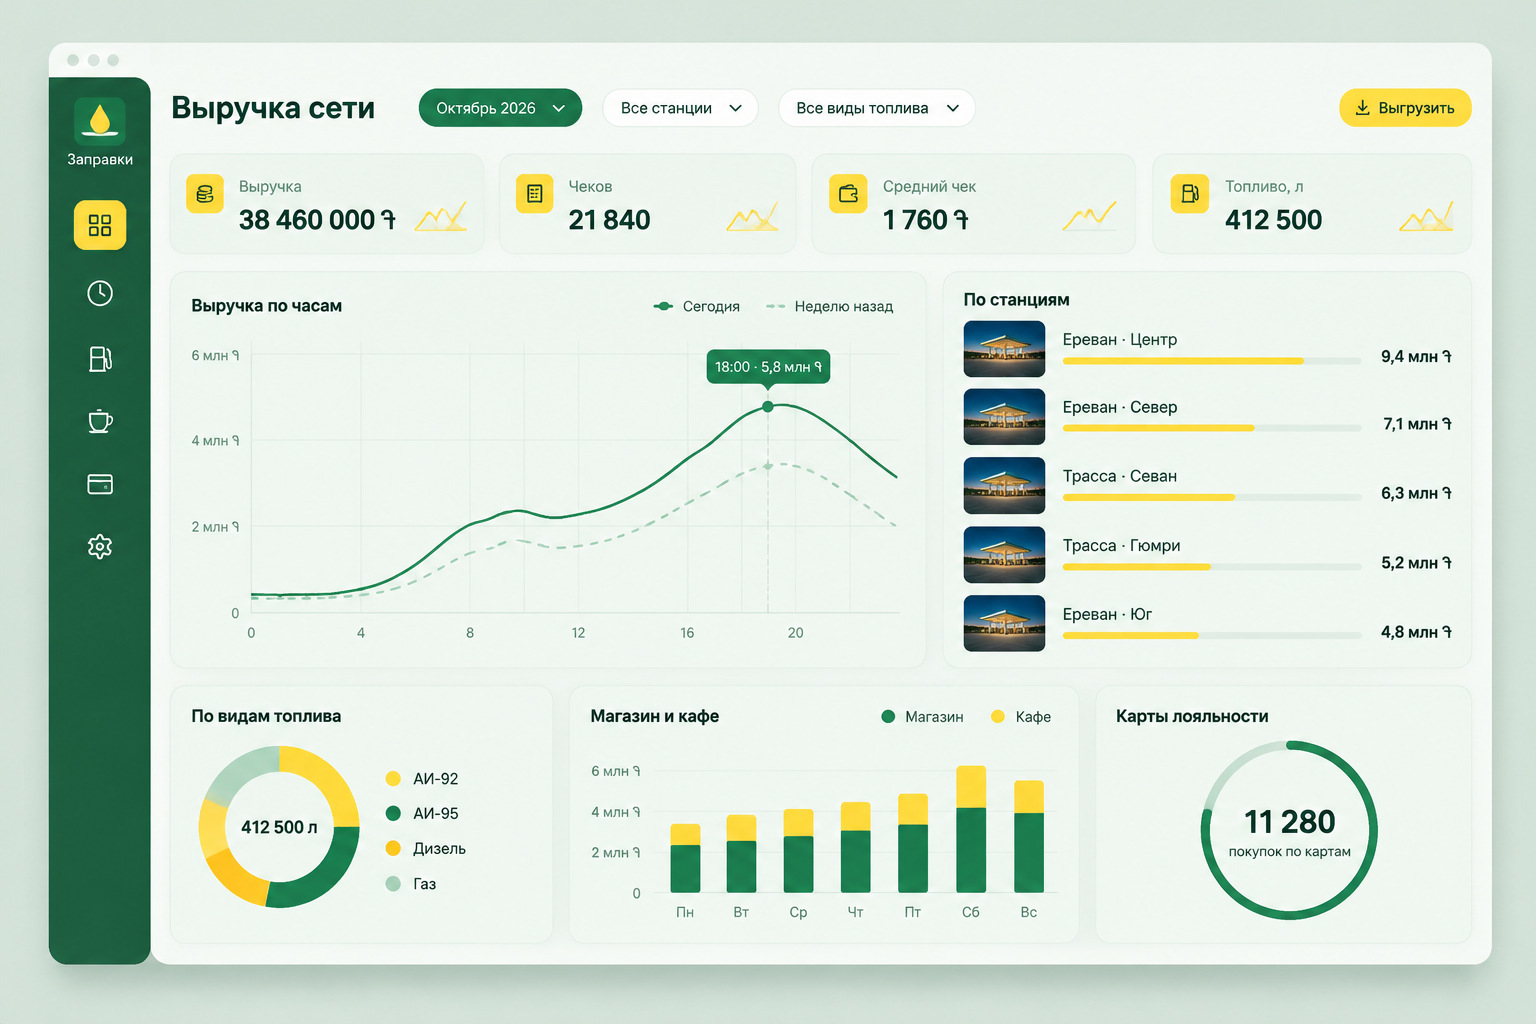
Для руководителей и категорийных менеджеров собрал OLAP-модель: выручка по станции, часу, виду топлива, товару и сегменту лояльности. Под срезами лежат заранее посчитанные агрегаты, поэтому отчёт перестраивается за пару кликов и не гоняет по всей истории чеков. Цифры сверяли вместе с финансистами день за днём, пока старые и новые отчёты не совпали.
Результат
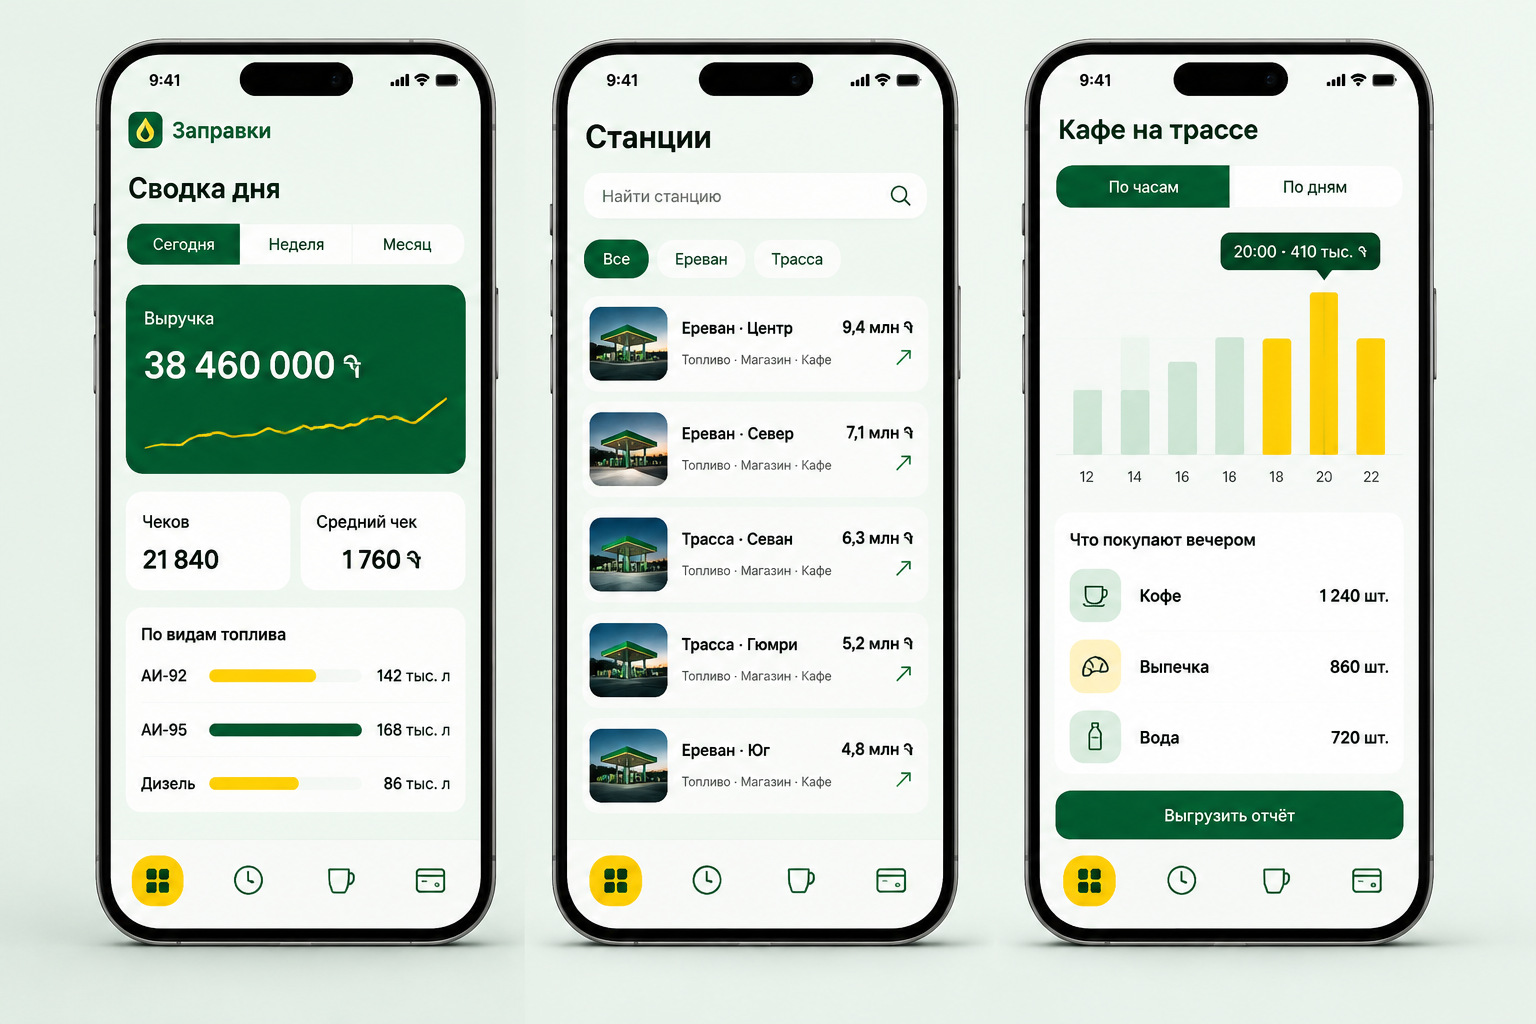
Финансисты и маркетологи открывают одни и те же цифры. Споры о том, какая выручка настоящая, сменились разговорами о том, что с ней делать. Отчёт по часам и станциям открывается быстро, утреннюю сводку больше не нужно склеивать руками.
Категорийные менеджеры сами смотрят, что покупают в кафе по вечерам на трассе и как ведут себя владельцы карт. Раньше такой вопрос уходил в очередь к аналитику.
Загрузки теперь на виду: если с кассы дошла лишь часть чеков, об этом знают наутро, а не в конце месяца. Лишняя платформа отключена, одной статьи расходов стало меньше.
Хранилище отвечает на вопрос «что было» и само ничего не прогнозирует. Модель спроса на топливо и товары можно строить следующим шагом, данные для неё уже подготовлены. Качество данных по-прежнему зависит от касс: если на станции товар заведён с ошибкой, ядро исправит это не всегда, поэтому справочники остаются под присмотром.
Если данные лежат в нескольких облачных хранилищах, а выручка у отделов не сходится, напишите мне через freelance.ru, какие системы подключены, и я прикину порядок переезда.
Презентация проекта
Оценили проект:
Оценили проект
Авторизация
Для того чтобы оценивать проекты, вам нужно войти на сайт