Делаю сложные задачи простыми решениями
- Город
- Москва
- Опыт работы
- 5 лет
- На сайте с
- 2025 года
- Юридический статус
- Самозанятый
Голосовые сообщения неудобно слушать на ходу, на совещании или когда их десяток подряд, а длинный текст иногда удобнее прослушать. Облачные сервисы распознавания берут деньги за минуты и требуют отправлять записи на чужие серверы — для переписки с клиентами это не всегда допустимо.
За основу взял открытый бот tochilkinva/tg_bot_stt_tts (68 звёзд на GitHub), заброшенный в 2022 году. Он работал только под Windows на старой версии aiogram, требовал вручную скачать модели и положить ffmpeg.exe в две папки, а при одновременных запросах путал ответы разных людей. Задача — вернуть проект к жизни и сделать бота, который ставится одной командой.
Переписал бота на Python и aiogram 3 и заменил движки: распознавание — на faster-whisper (модель Whisper, ставит пунктуацию и сама читает любые форматы), озвучку — на Piper вместо тяжёлого torch. Внешний ffmpeg больше не нужен, модели скачиваются сами при первом запуске.
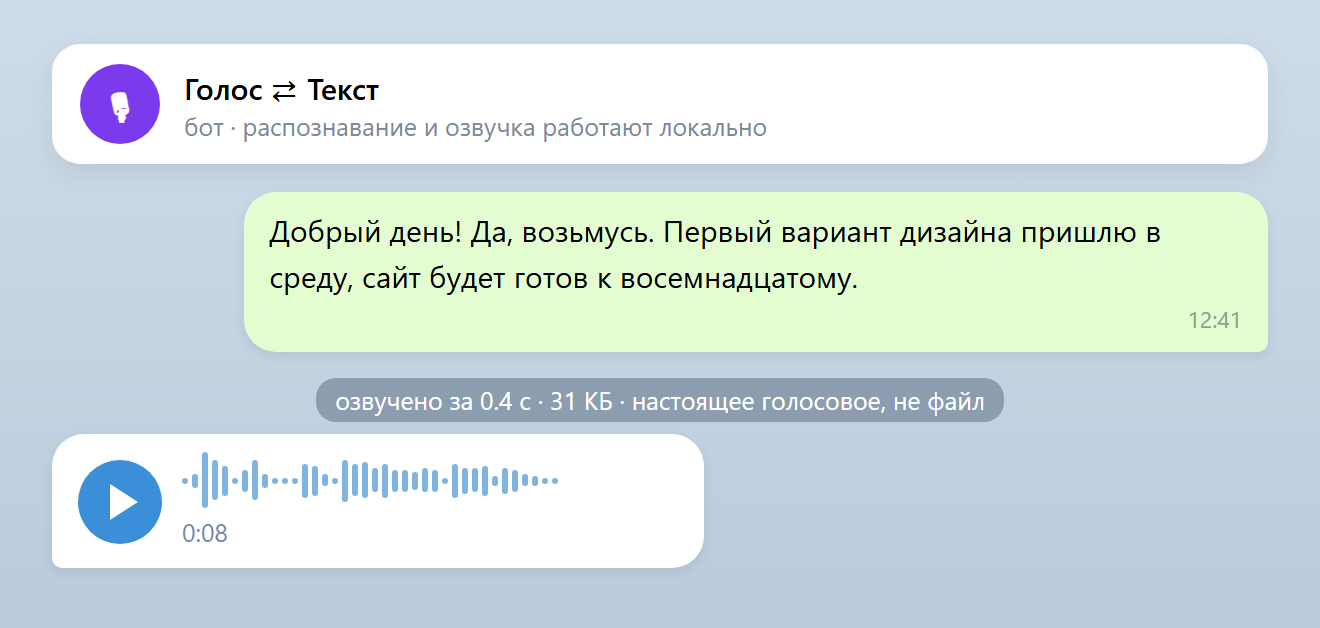
Исправил ошибки оригинала: временные файлы с одинаковыми именами — двое пользователей перезаписывали ответы друг друга; озвучка уходила в формате, который Telegram не считает голосовым; длинный текст резался посреди слова; бот замирал целиком, пока шло распознавание; ответ уходил в личку, а не в чат, откуда пришло сообщение.
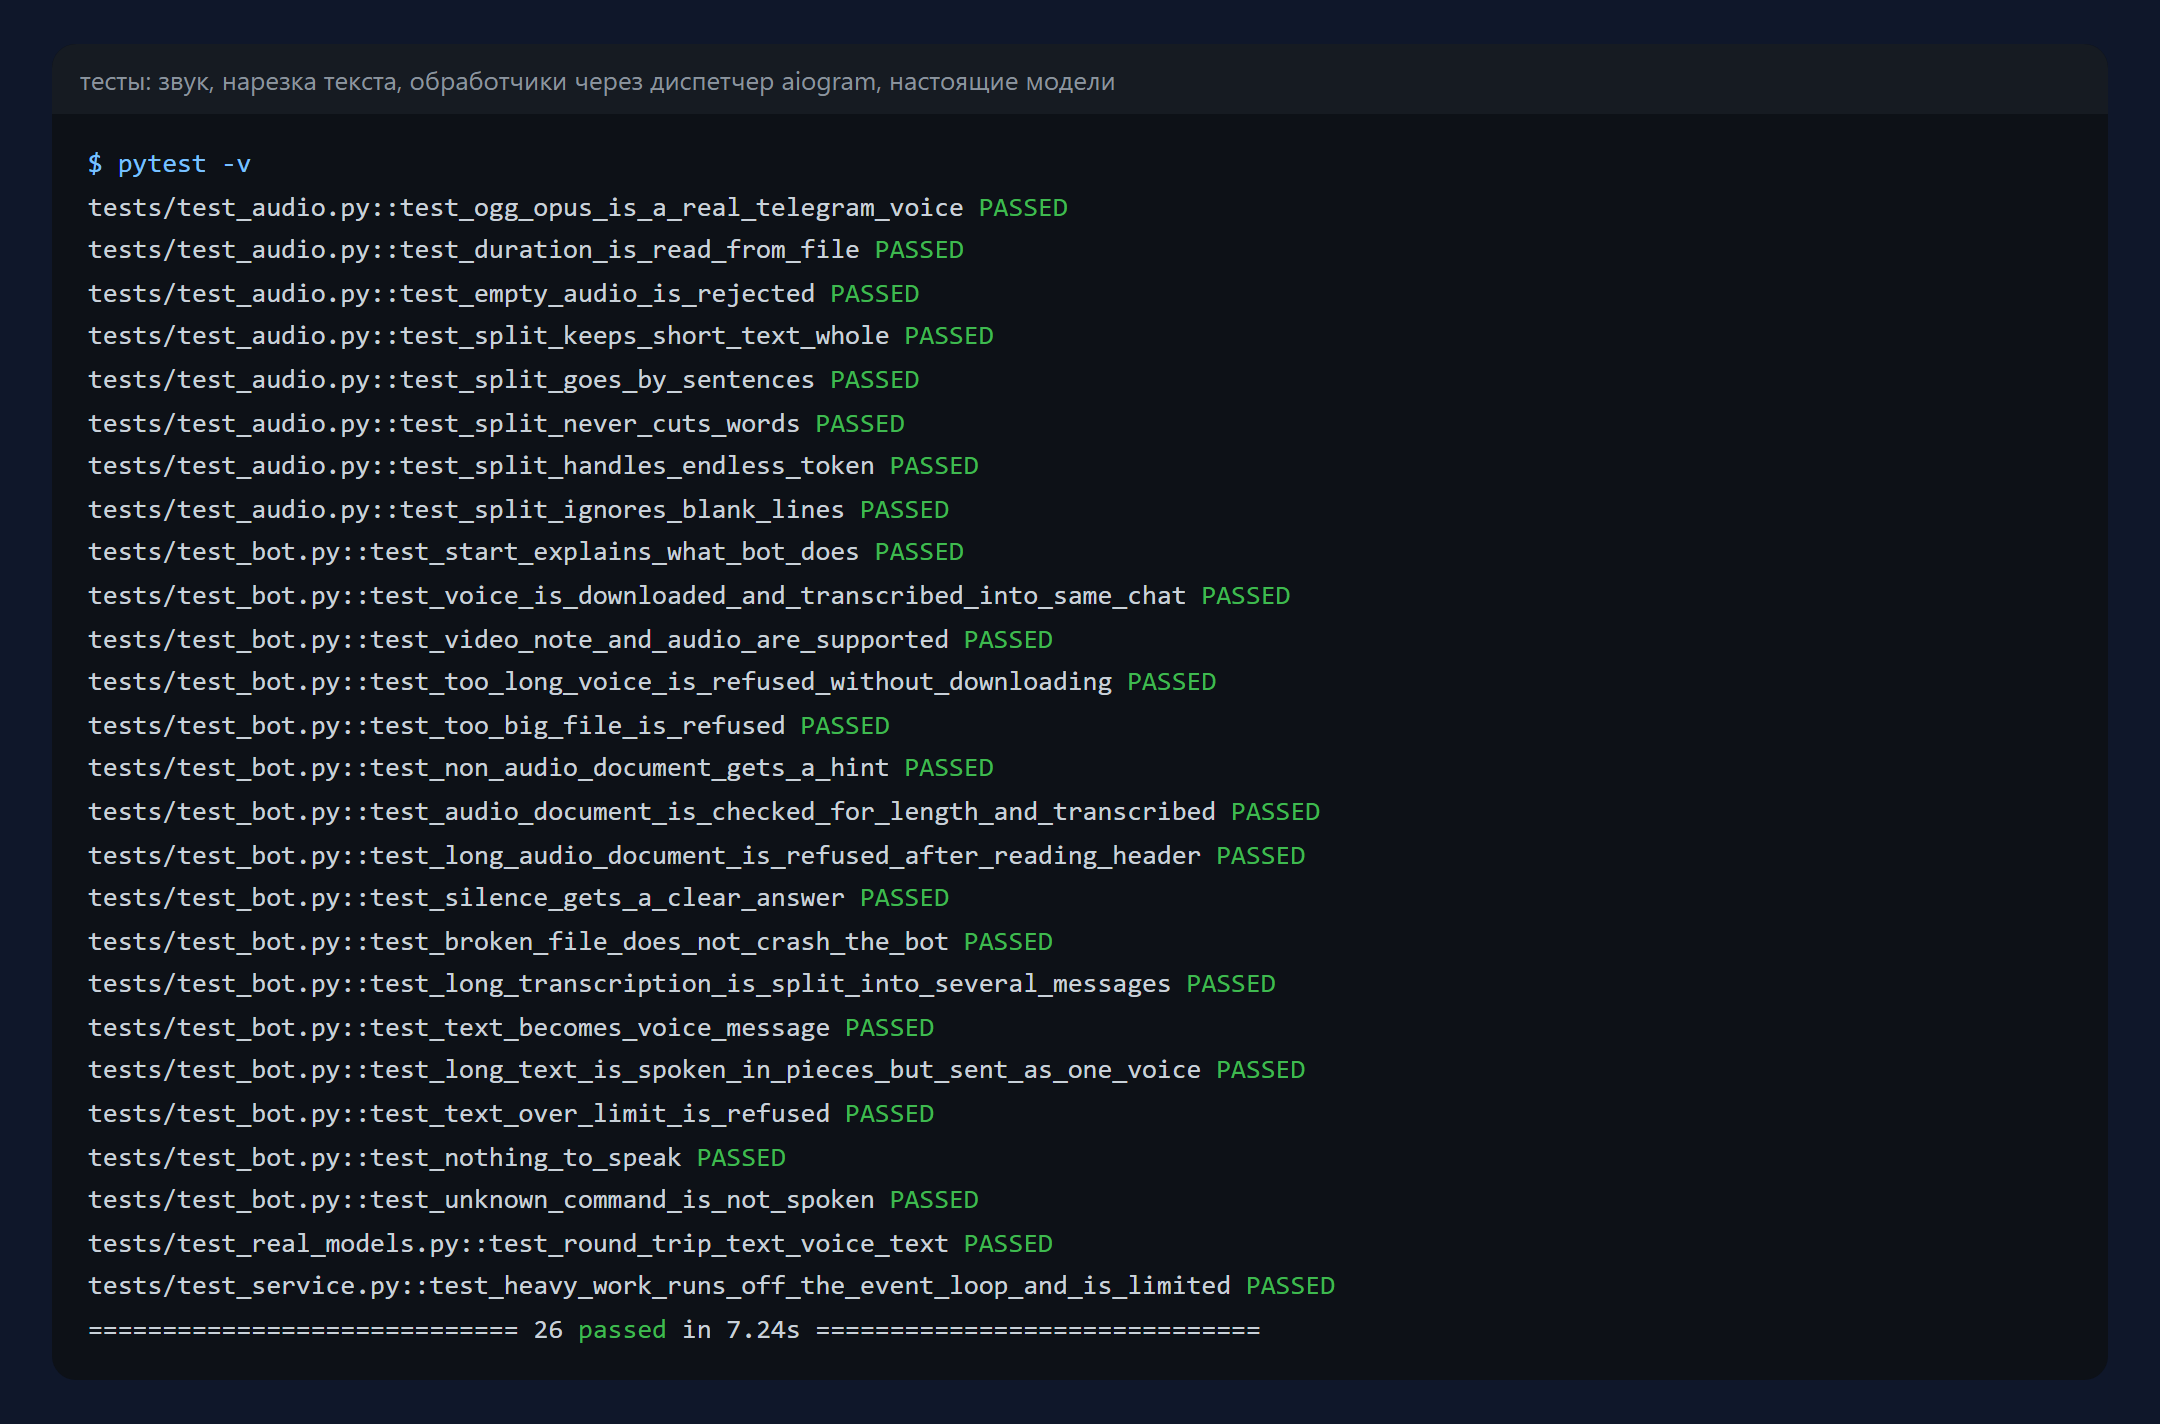
Добавил кружки и видео, проверку длительности и размера файла, понятные ответы на тишину, битый файл или PDF вместо аудио, работу в фоне с ограничением нагрузки, настройки через .env и Docker. 26 автотестов, включая сквозной на настоящих моделях: текст → голос → снова текст.
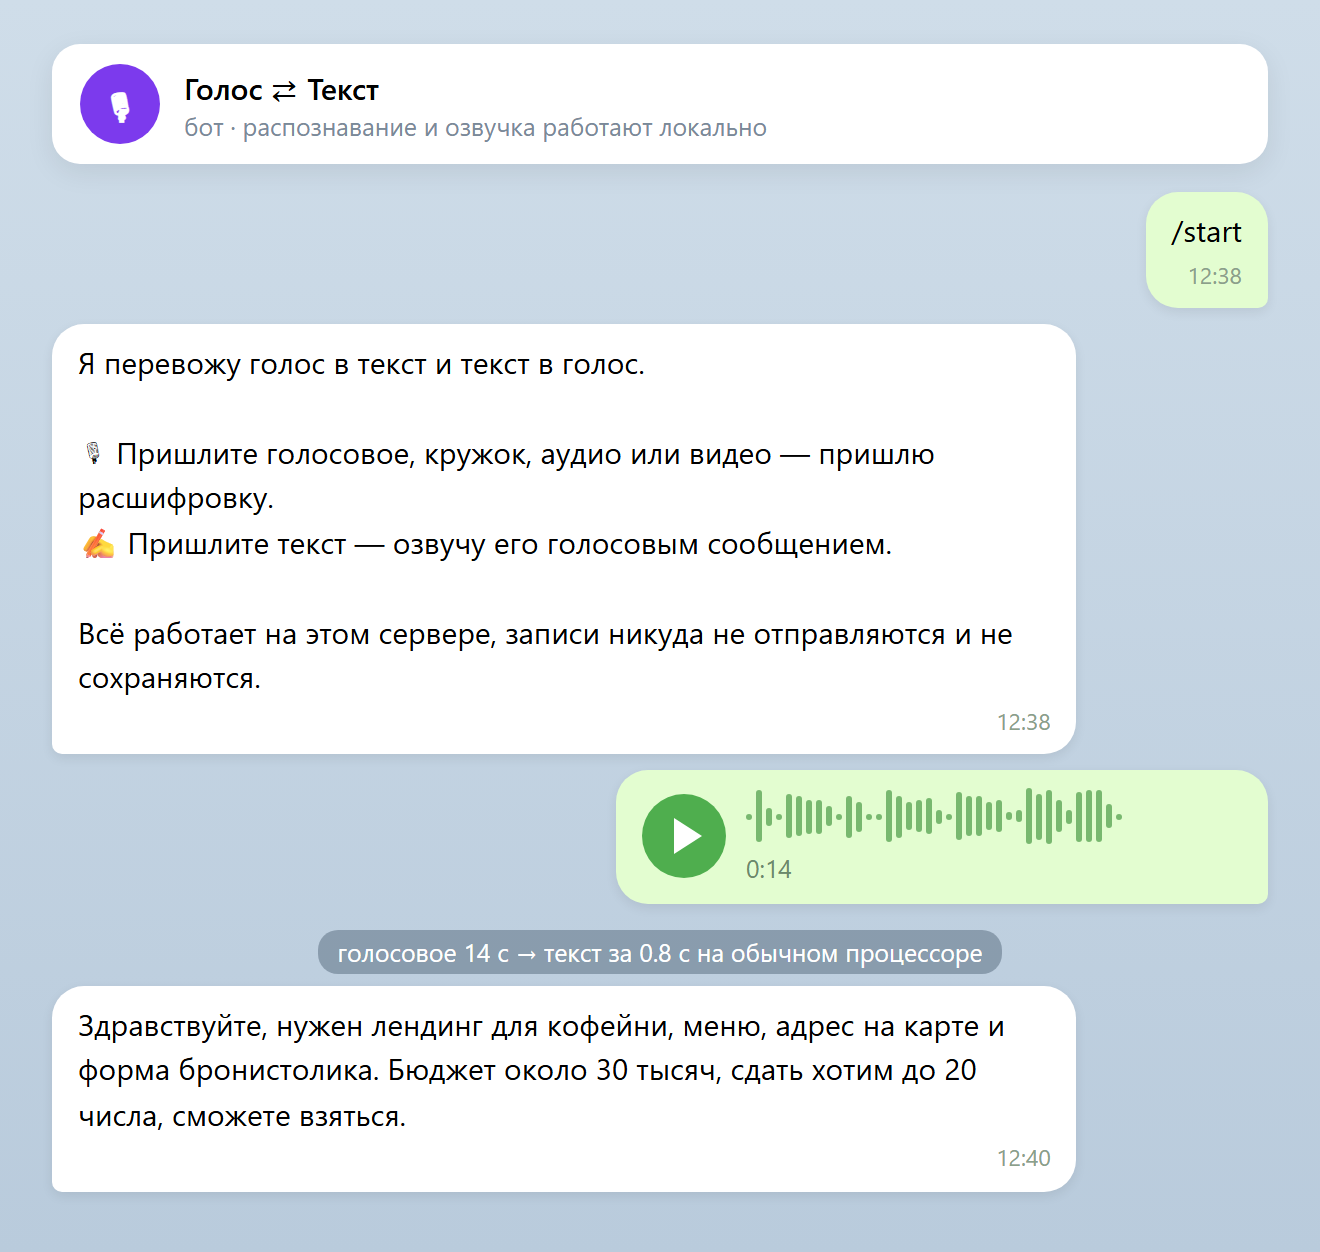
Бот присылает расшифровку голосового, кружка или видео и озвучивает текст настоящим голосовым сообщением. 14-секундное голосовое распознаётся меньше чем за секунду на обычном процессоре, без видеокарты. Всё работает на своём сервере: без облачных API, без оплаты за минуты, записи никуда не уходят.
Проект — открытый форк с сохранением лицензии и указанием автора оригинала; в README подробно расписано, что изменено и почему.