ИИ-агенты, RAG и автоматизация на Python — от прототипа до прода
- Город
- Москва
- Опыт работы
- 13 лет
- На сайте с
- 2026 года
- Юридический статус
- ИП
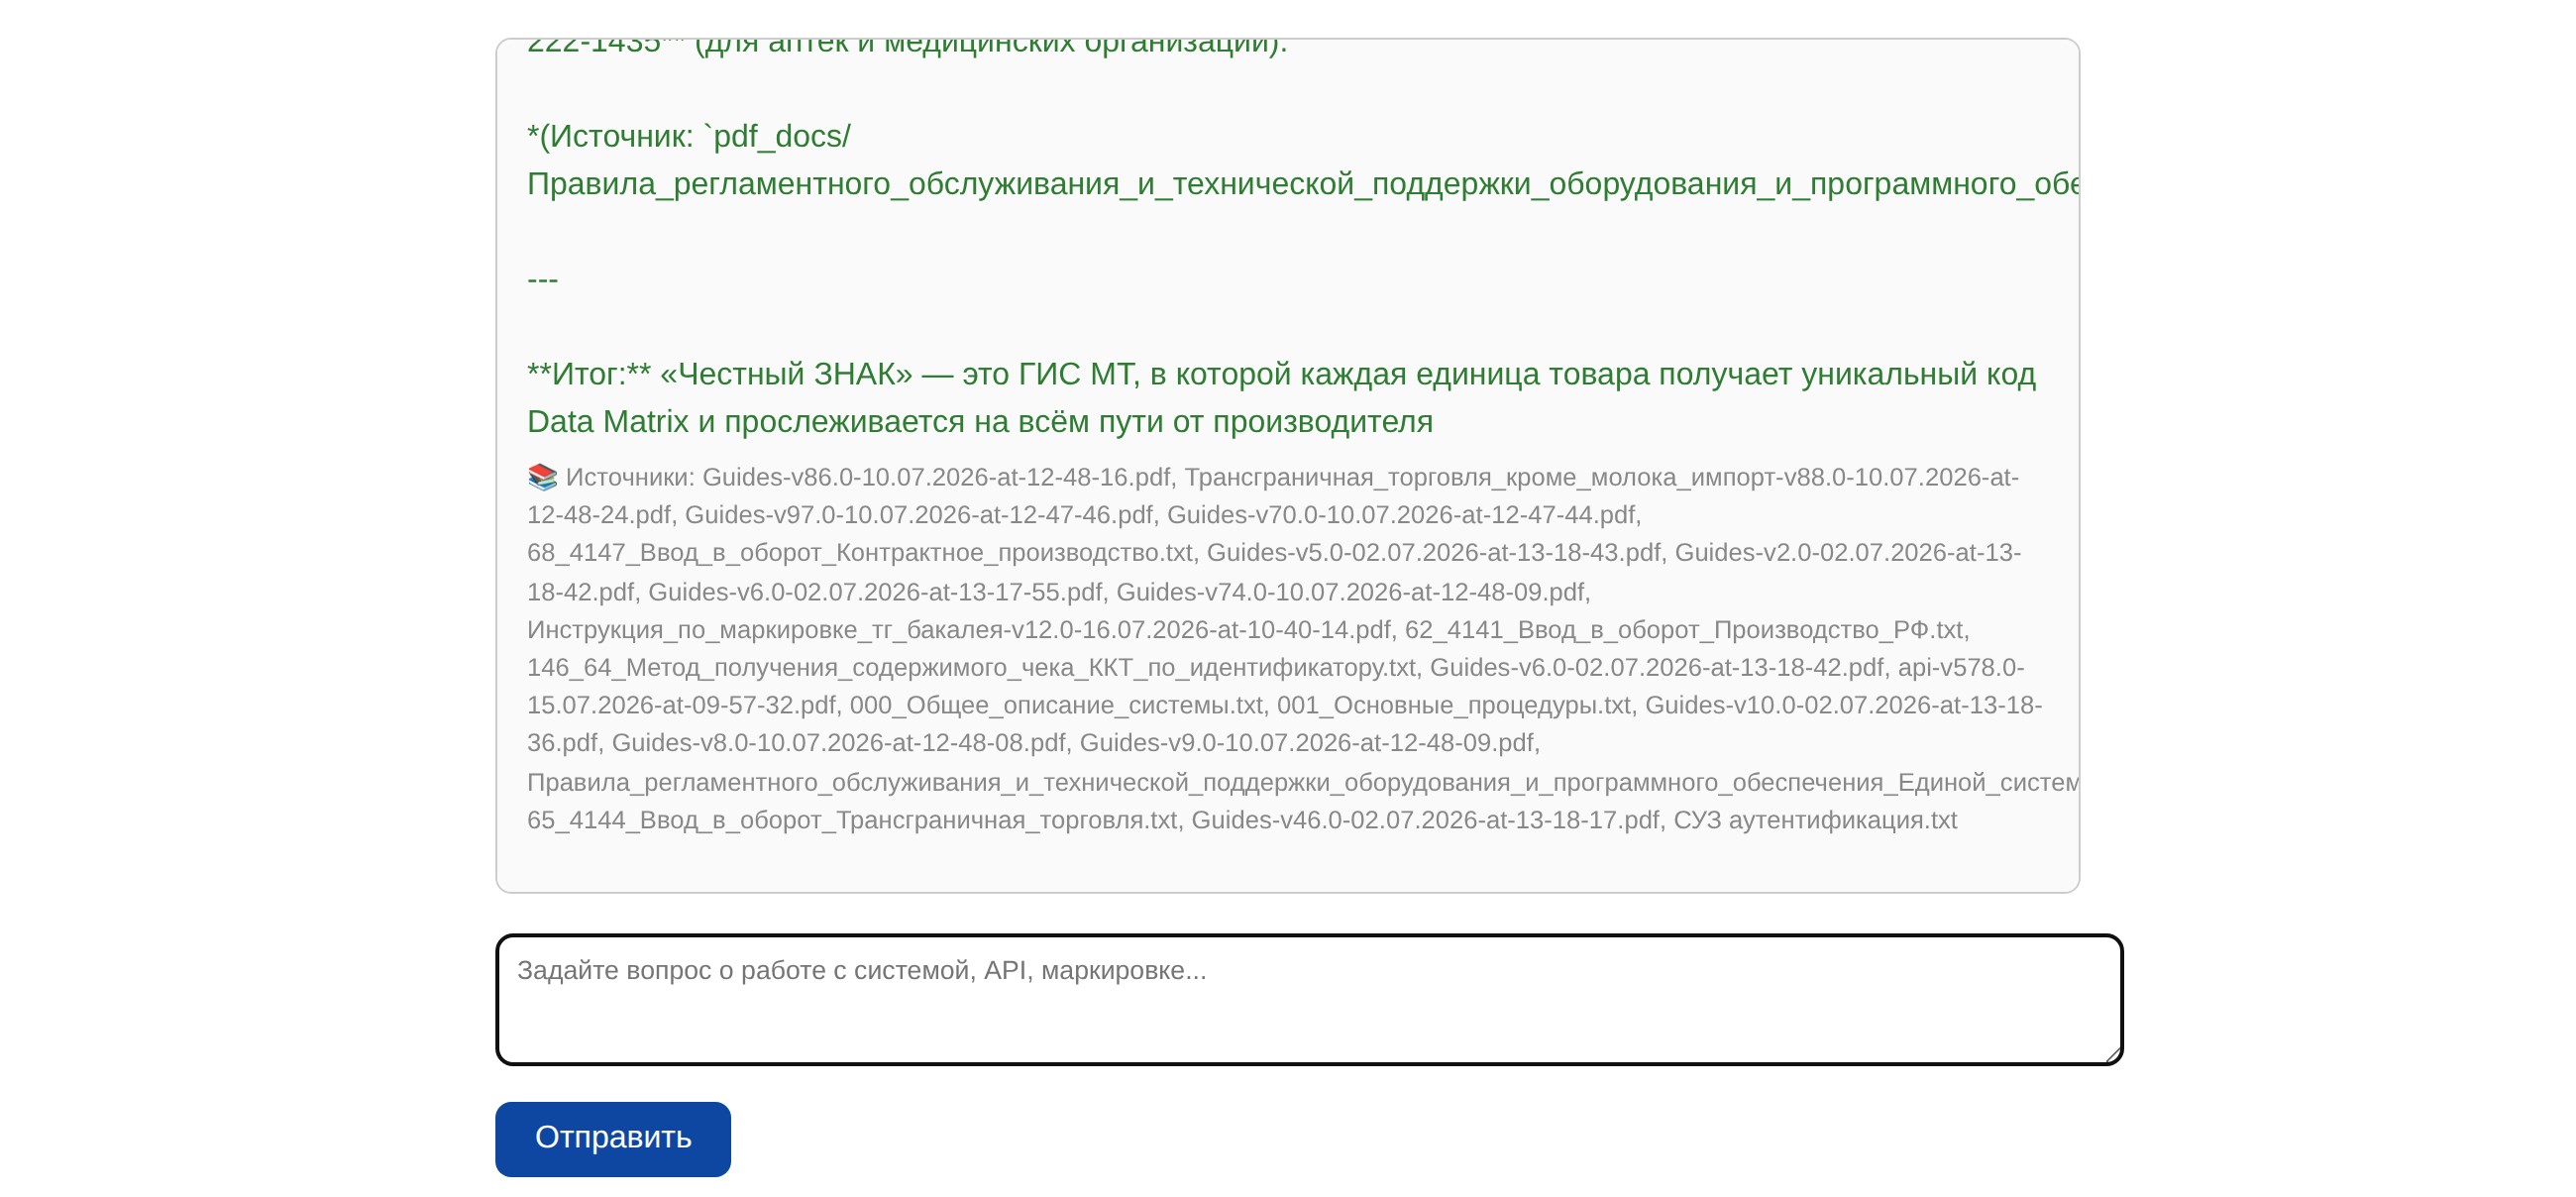
Нормативная база маркировки огромна и постоянно обновляется. Нужно было отвечать на вопросы по документам так, чтобы ответ можно было проверить по первоисточнику, а не принимать на веру.
Собрал автоматическую сборку индекса из PDF и текстов (PyMuPDF) — 59 121 фрагмент.
Настроил поиск top-15 с порогом релевантности, чтобы модель не отвечала на «пустом» месте, и промпт «только по документам + ссылка на источник». В ответе выводится список файлов, откуда взяты факты.
Добавил защиту от промпт-инъекций и ограничение частоты запросов. Развернул на Linux-VPS: nginx, systemd, автоперезапуск.
Консультант отвечает по нормативке и всегда показывает источник — ответ проверяется в один клик. Индекс собирается заново из обновлённых документов без переписывания кода.