DevOps / Python / JS / C#: автоматизация и безопасность
- Опыт работы
- 4 года
- На сайте с
- 2021 года
- Юридический статус
- Самозанятый
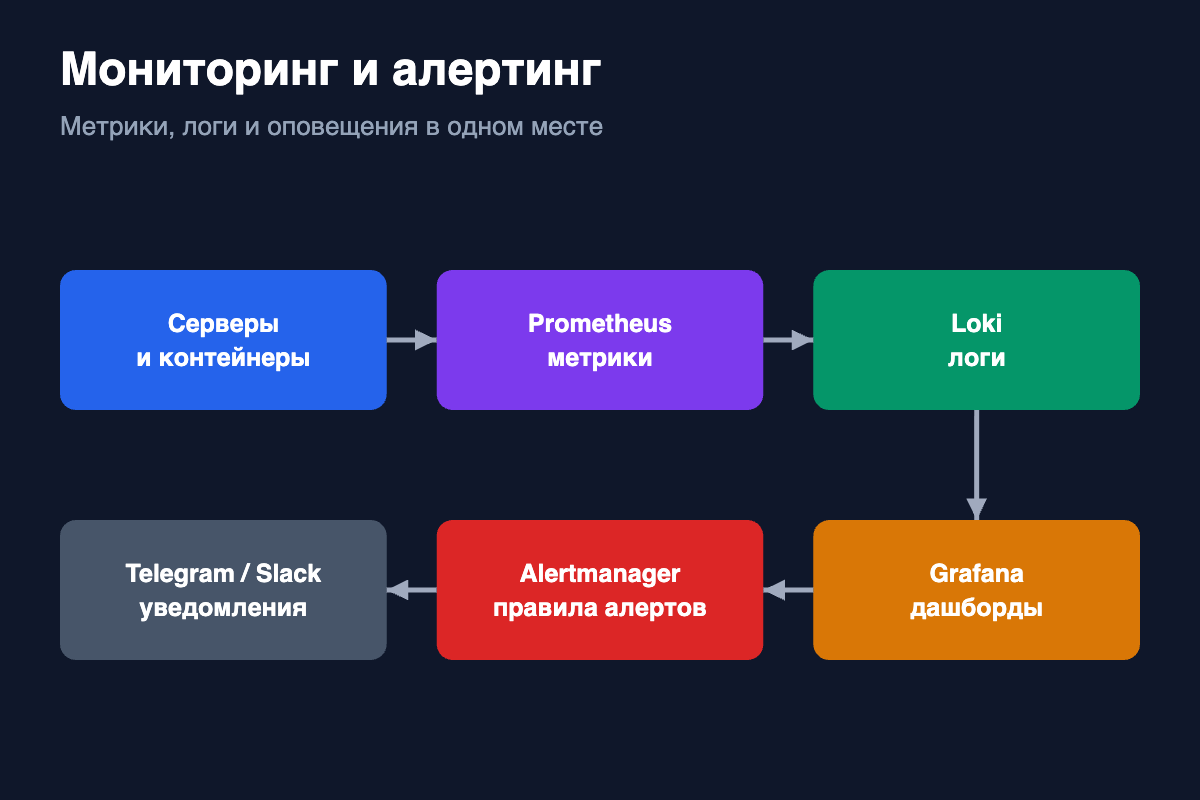
Типовая задача: о проблемах в продакшене узнают от пользователей, а не от системы, метрики и логи разбросаны по серверам.
Разворачиваю стек наблюдаемости: сбор метрик (Prometheus, exporters), централизованные логи (Loki), дашборды в Grafana по ключевым сервисам, алерты по доступности, нагрузке, диску и ошибкам с отправкой в Telegram или Slack. Настраиваю разумные пороги, чтобы не было шума.
Команда узнаёт о сбоях раньше пользователей, видит причину по метрикам и логам и быстрее восстанавливает сервис. Заказчик получает набор дашбордов и описание алертов.