DevOps / Python / JS / C#: автоматизация и безопасность
- Опыт работы
- 4 года
- На сайте с
- 2021 года
- Юридический статус
- Самозанятый
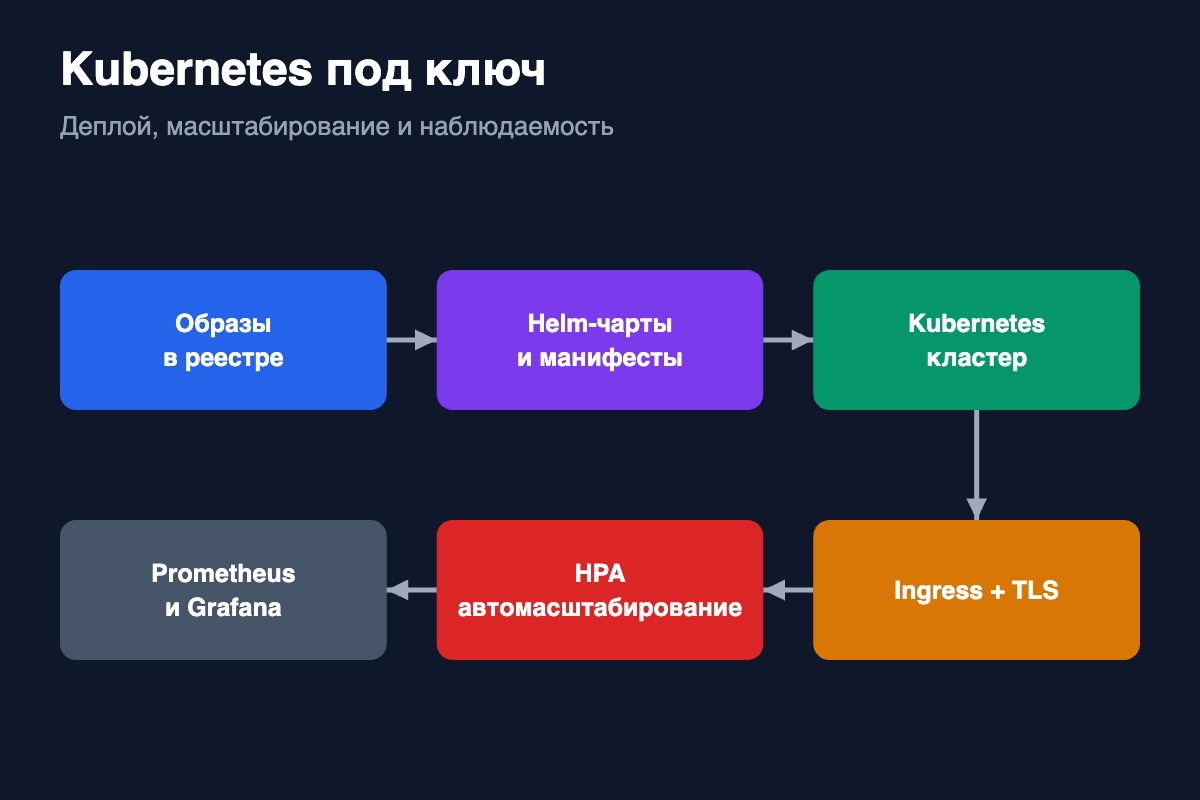
Типовая задача: сервисы нужно запускать в кластере с обновлениями без простоя, автоматическим масштабированием и понятным мониторингом.
Разворачиваю кластер (управляемый EKS или AKS, либо собственный), описываю деплои через Helm, настраиваю Ingress с автоматическими TLS-сертификатами, пробы готовности, лимиты ресурсов, горизонтальное автомасштабирование, сетевые политики и мониторинг в Prometheus и Grafana.
Обновления выкатываются без остановки сервиса, нагрузка распределяется автоматически, а состояние кластера видно на дашбордах.