AI-агенты, данные и веб-сервисы на Python: от идеи до продакшена
- Город
- Москва
- Опыт работы
- 8 лет
- На сайте с
- 2026 года
- Юридический статус
- ИП
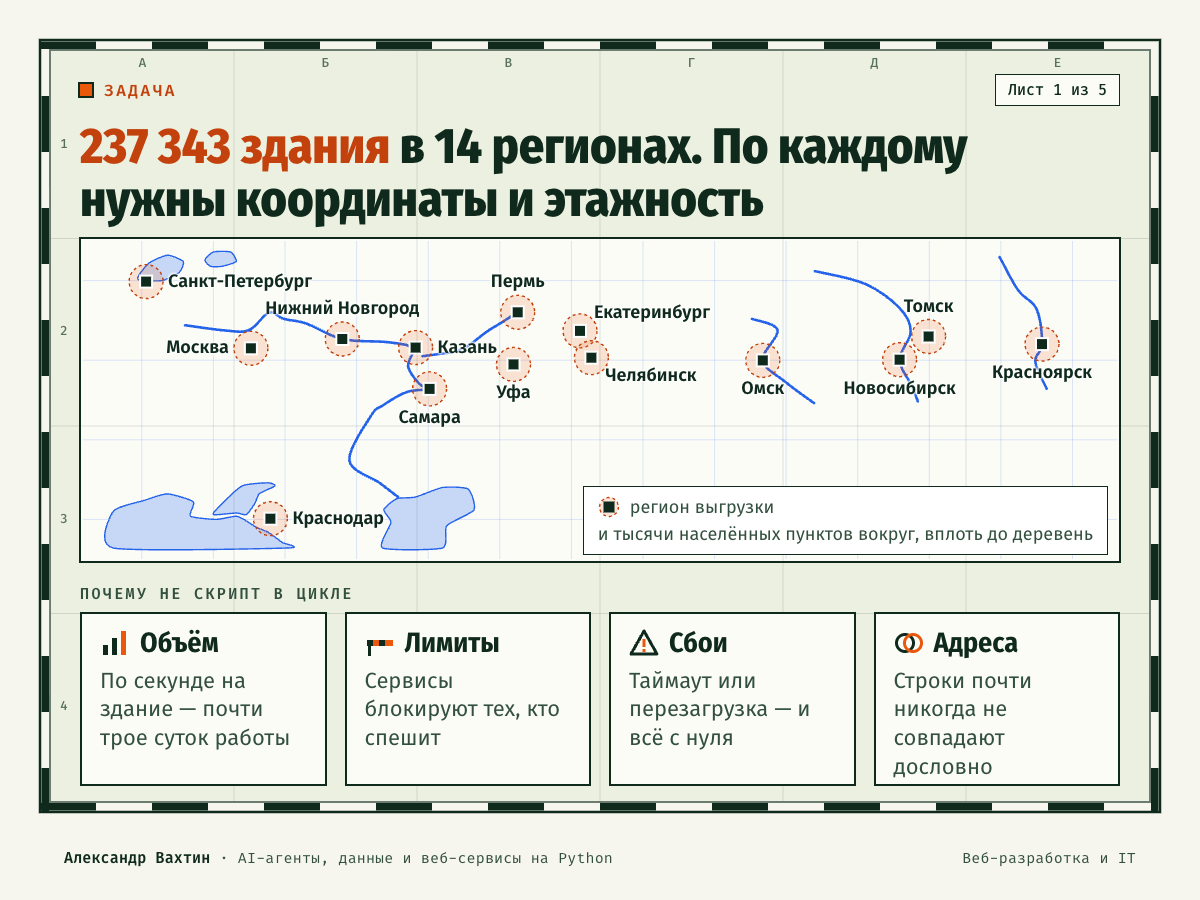
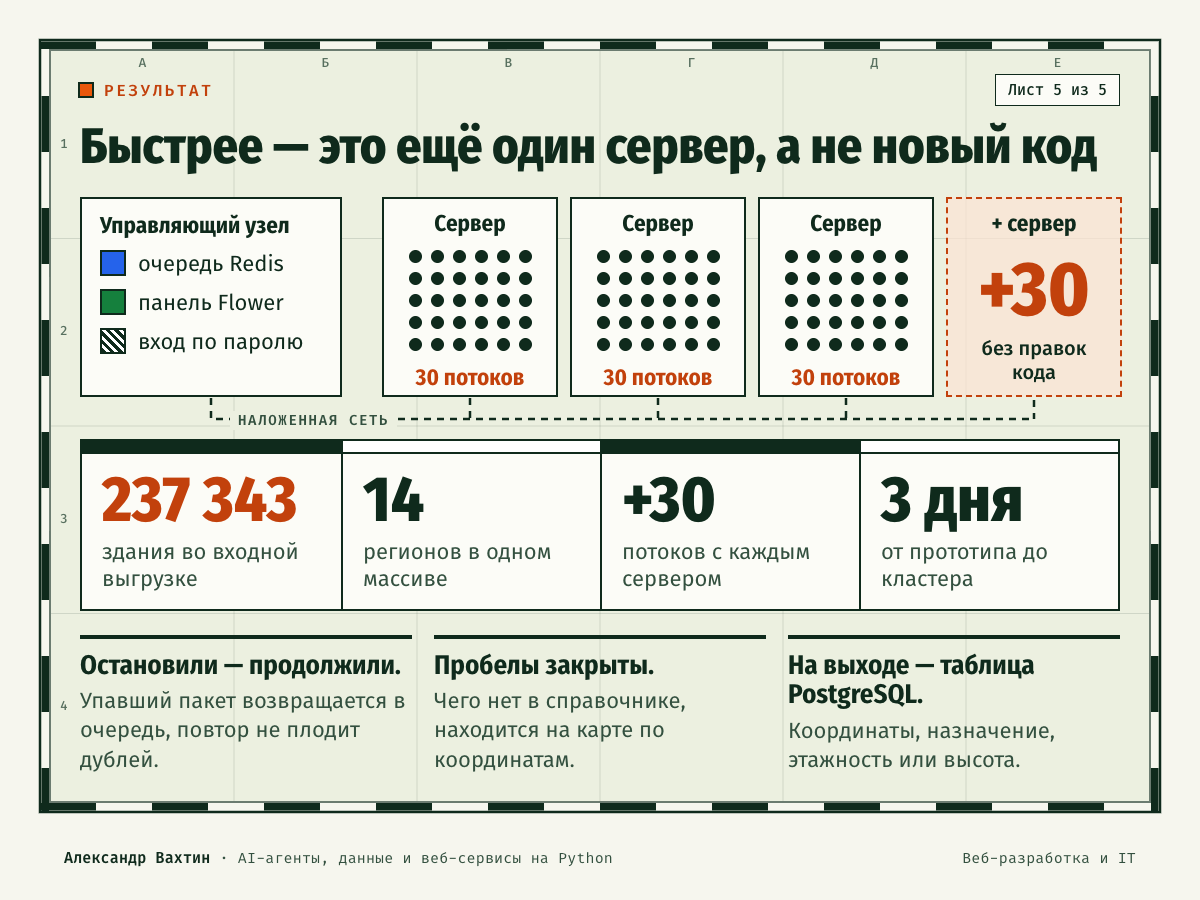
На входе — выгрузка из 237 343 зданий в 14 регионах: Москва, Санкт-Петербург, Краснодар, Нижний Новгород, Казань, Самара, Уфа, Пермь, Екатеринбург, Челябинск, Омск, Новосибирск, Томск, Красноярск и тысячи населённых пунктов вокруг них, вплоть до деревень. По каждому зданию нужно узнать координаты и этажность.
Готового поля «этажность» для всех домов нет ни в одном открытом источнике. Где-то она есть в справочнике, где-то только на карте, где-то её нет совсем, но известна высота здания. Значит, источников должно быть несколько, и они должны подстраховывать друг друга.
Скрипт в цикле такую задачу не вытягивает, и дело не в мощности компьютера.
— Объём. Даже по секунде на здание это почти трое суток непрерывной работы. Реальный запрос к геосервису идёт дольше, а на одно здание их несколько.
— Лимиты. Картографические сервисы ограничивают частоту обращений и блокируют тех, кто спешит. Скорость упирается в число независимых потоков и в аккуратность, а не в процессор.
— Сбои. За несколько суток работы случится всё: таймаут, разрыв соединения, ответ «слишком много запросов», перезагрузка сервера. Скрипт в цикле в этот момент падает, и работа начинается с нуля.
— Адреса. Строка из выгрузки и запись в справочнике почти никогда не совпадают дословно: сокращения, корпуса и строения, другой порядок частей. Ошибка сопоставления — это этажность соседнего дома в отчёте.
Нужен был сбор, который ускоряется добавлением серверов, переживает сбои и перезапускается с места остановки — без потерь и без дублей в базе.
Сделал проект целиком и один: от первого запроса к API на одном адресе до кластера из нескольких серверов. Весь путь от прототипа до кластерной версии занял три дня.
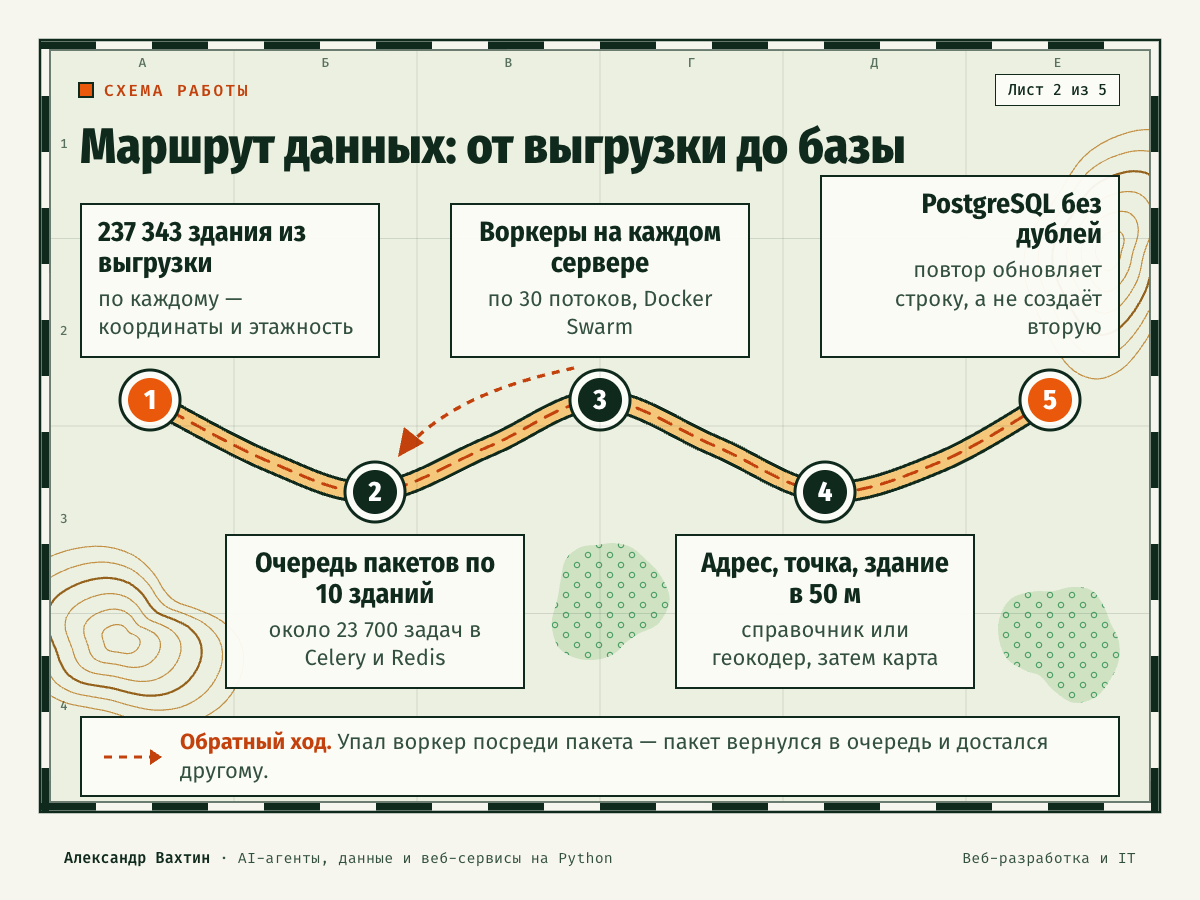
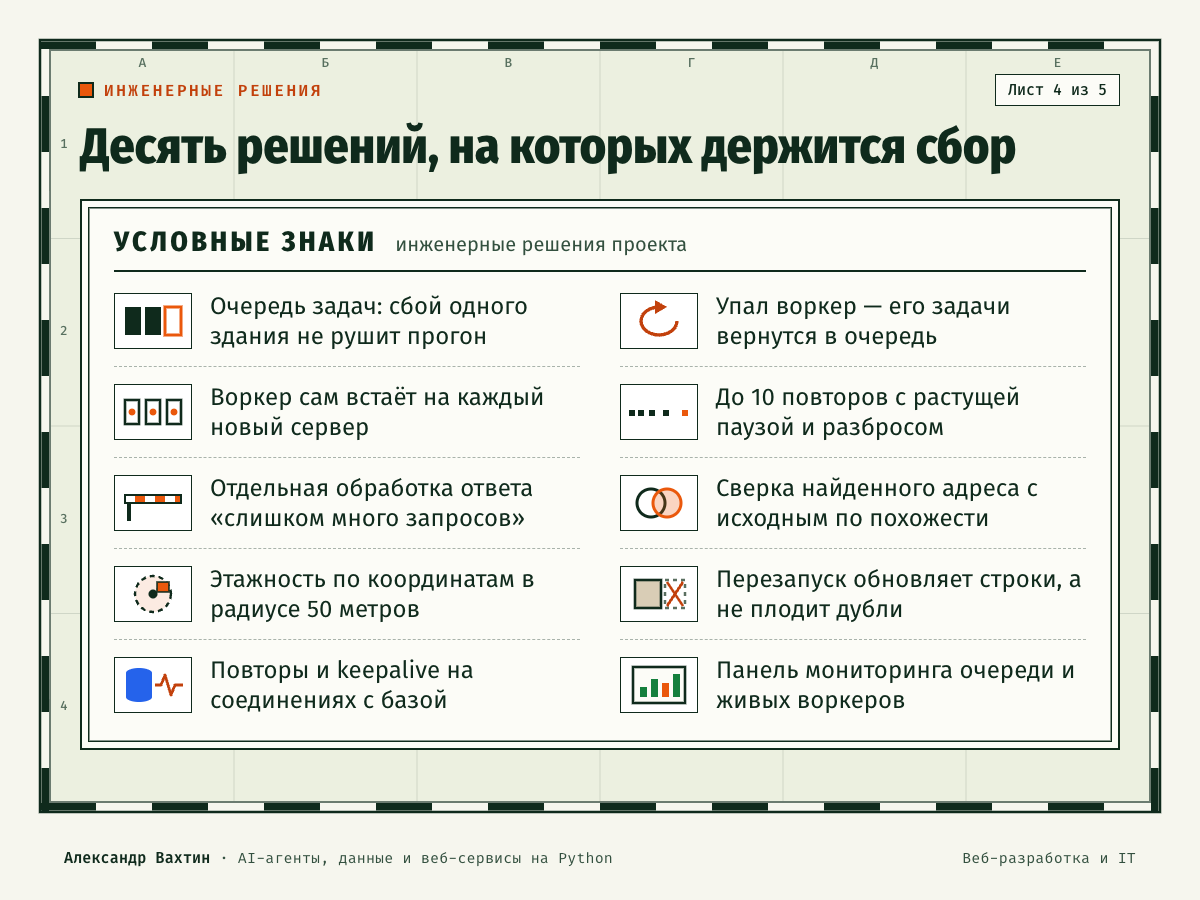
Очередь вместо цикла. Выгрузка режется на пакеты по 10 зданий — около 23 700 независимых задач в очереди на Celery и Redis. Воркеры разбирают их параллельно, по 30 потоков на сервер. Задача считается выполненной только после того, как отработала целиком: если воркер упал посреди пакета, пакет возвращается в очередь и достаётся другому.
Кластер вместо одной машины. Развернул на Docker Swarm в режиме, где воркер сам запускается на каждом сервере кластера. Нужно быстрее — подключается ещё один сервер, и он сразу добавляет свои 30 потоков, без правок в коде. Серверы могут стоять в разных сетях: образы раздаются через приватный реестр, узлы связаны наложенной сетью, очередь закрыта паролем и вместе с панелью мониторинга закреплена за управляющим узлом. Воркер при старте дожидается очереди, проверяет базу и сам создаёт таблицы. Для сети кластера написал отдельные скрипты диагностики: связь между узлами — первое, что ломается, и без инструментов её приходится чинить вслепую.
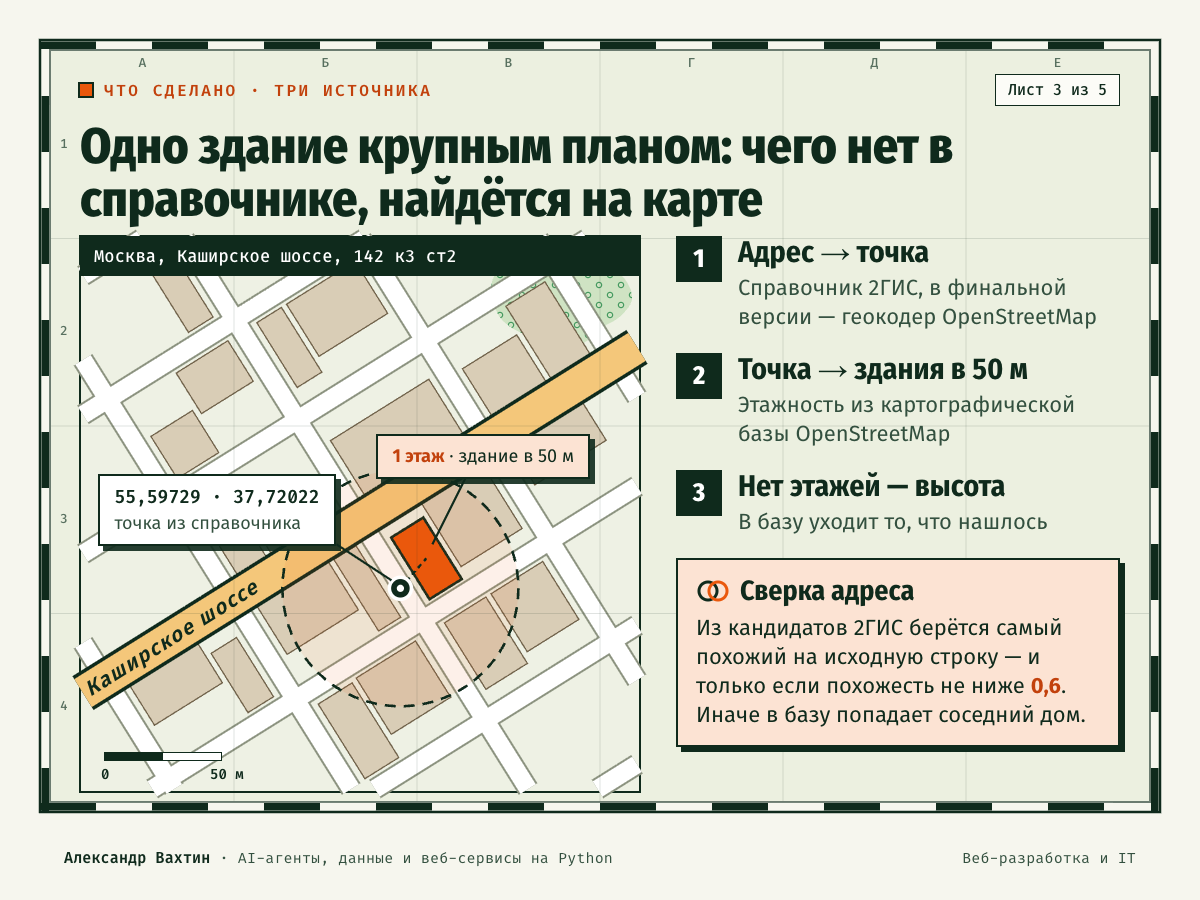
Три источника на одно здание. Сначала адрес превращается в точку на карте: в первой версии через справочник 2ГИС, в финальной — через геокодер OpenStreetMap. Если этажности в ответе нет, по координатам уходит отдельный запрос к картографической базе OpenStreetMap: какие здания стоят в радиусе 50 метров от точки и сколько у них этажей. Если этажей нет и там, сохраняется высота здания.
Сверка адресов. Для справочника 2ГИС написал сопоставление: из нескольких кандидатов выбирается тот, чей адрес больше всего похож на исходную строку, и только если похожесть не ниже 0,6. Иначе в базу попадает соседний дом.
Повторы под реальные сбои. До 10 попыток с растущей паузой и случайным разбросом. Разброс принципиален: без него все упавшие запросы повторяются в одну секунду и сами создают новую волну отказов. Ответ «слишком много запросов» и сетевые ошибки обрабатываются отдельно, ниже работает второй уровень повторов на уровне соединения. Перед каждым обращением к геокодеру поток выдерживает паузу, честно представляется сервису и ждёт ответа дольше обычного. Задача не в том, чтобы обойти ограничения, а в том, чтобы не получить блокировку на весь кластер.
Запись без дублей. Перед записью проверяется, есть ли уже строка по этому зданию: повторный прогон обновляет её, а не создаёт вторую. Именно это делает перезапуск безопасным.
Устойчивость к базе. Операции с PostgreSQL обёрнуты в собственный слой повторов — до 10 попыток при разрыве. Соединение проверяется перед использованием, пересоздаётся по времени и держится keepalive-пакетами. Облачная база рвёт простаивающие соединения, и без этого многочасовой сбор падает на ровном месте.
Наблюдаемость. Панель мониторинга очереди показывает, сколько задач в работе, сколько упало и какие воркеры живы. Отдельная команда печатает статус всего прогона, другая — статистику по базе.
Пример из тестового прогона: «Москва, Каширское шоссе, 142 к3 ст2» — справочник вернул точку 55,59729 · 37,72022, картографическая база нашла на ней здание: 1 этаж.
Скорость сбора решается железом, а не переписыванием кода: каждый подключённый сервер сразу добавляет 30 потоков.
Прогон можно остановить в любой момент и продолжить. Упавший пакет возвращается в очередь, а повторная запись обновляет строку вместо дубля. Сбой среди ночи не отбрасывает работу к началу и не портит уже собранное.
Три источника вместо одного закрывают пробелы: чего нет в справочнике, часто находится на карте по координатам, а где на карте нет этажей, остаётся высота здания.
На выходе — таблица в PostgreSQL: по каждому зданию координаты, назначение, этажность или высота, исходные теги карты и время последнего обновления. Встроенная статистика сразу показывает, у какой доли зданий нашлась этажность, как здания распределены по этажам и по регионам.
От пустой папки до кластера — три дня. Так я делаю парсинг: не скрипт на один запуск, а сбор, который выдерживает объём, лимиты источников и сбои.