AI-агенты, данные и веб-сервисы на Python: от идеи до продакшена
- Город
- Москва
- Опыт работы
- 8 лет
- На сайте с
- 2026 года
- Юридический статус
- ИП
Собственная разработка, выросшая из личной задачи. На площадках с заказами заявки появляются непрерывно и живут несколько часов, поэтому подходящую важно заметить вовремя.
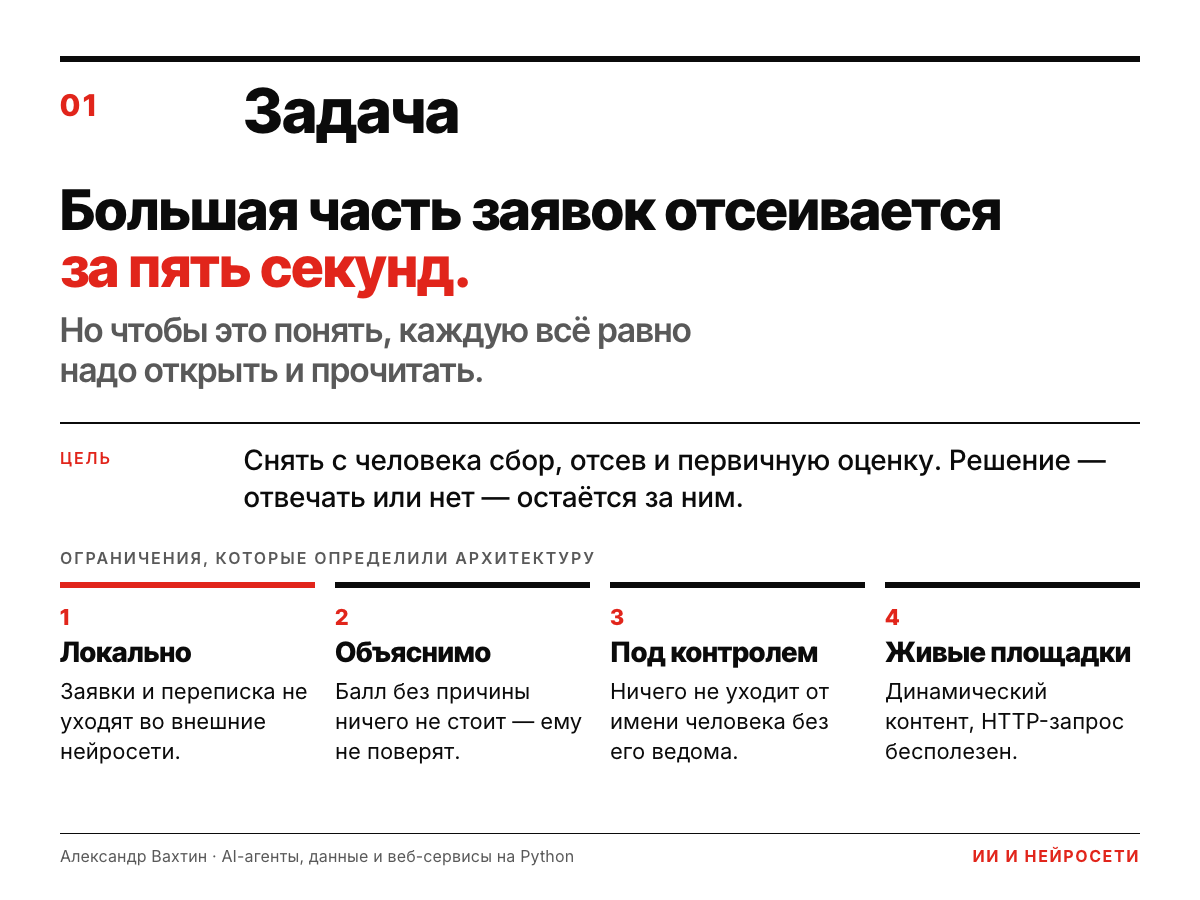
Ручной разбор такого потока устроен абсурдно. Большая часть заявок отсеивается за пять секунд: не тот профиль, несерьёзный бюджет, размытая задача. Но чтобы это понять, каждую всё равно надо открыть и прочитать. Внимание уходит на мусор, а на подходящие заявки, ради которых всё и затевалось, его уже не остаётся.
Та же схема встречается везде, где есть входящий поток: заявки с сайта, тендеры, резюме, обращения клиентов. Сначала отсеять, потом оценить, и только потом думать.
Задача: снять с человека сбор, отсев и первичную оценку, оставив ему решение — отвечать или нет.
Ограничения, которые определили архитектуру:
— тексты заявок и переписка не должны уходить во внешние облачные нейросети, поэтому модель работает локально, на своей машине;
— оценка обязана объясняться: балл без причины ничего не стоит, ему не поверят;
— автоматика не отправляет ничего от имени человека без его ведома;
— площадки отдают контент динамически, обычный HTTP-запрос там бесполезен.
Спроектировал и написал систему целиком, один: серверную часть, фоновые задачи, промпты, интерфейс и развёртывание.
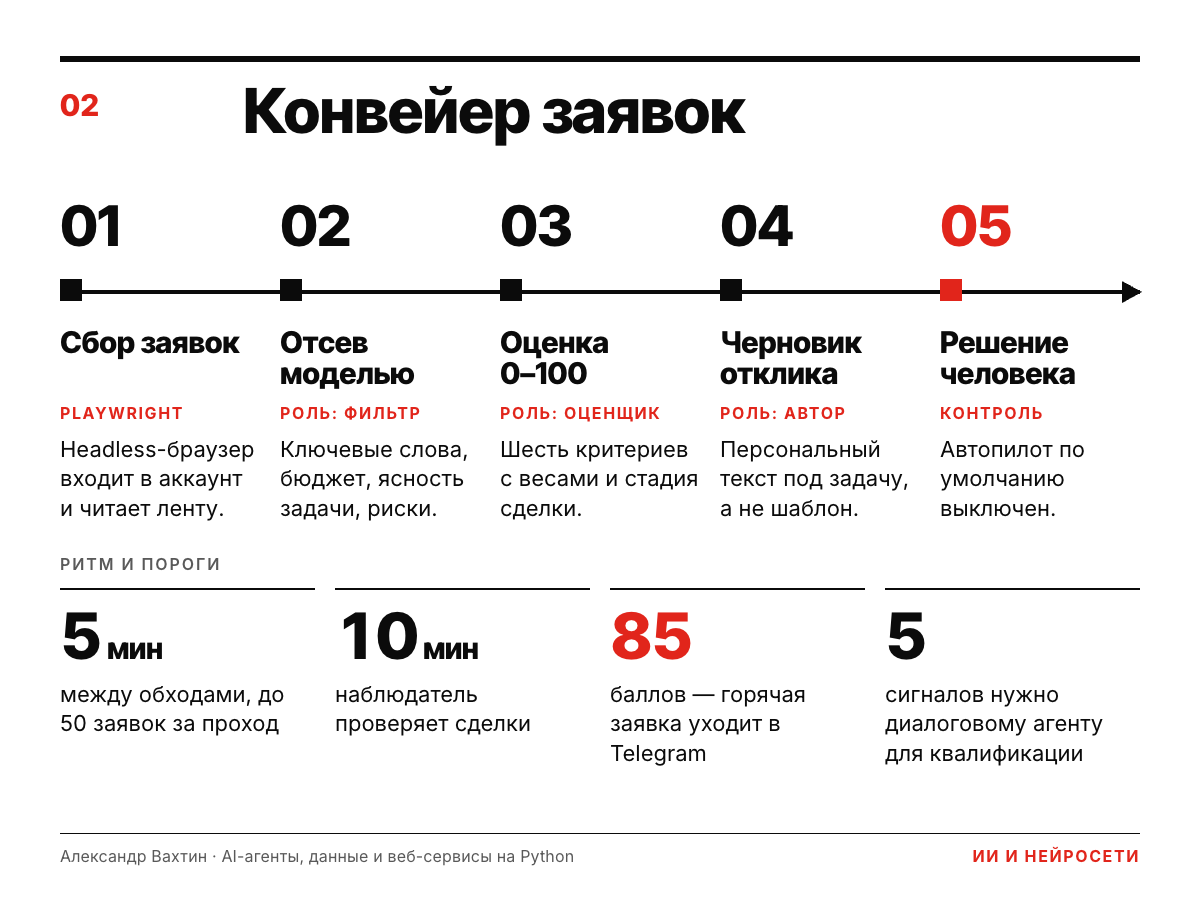
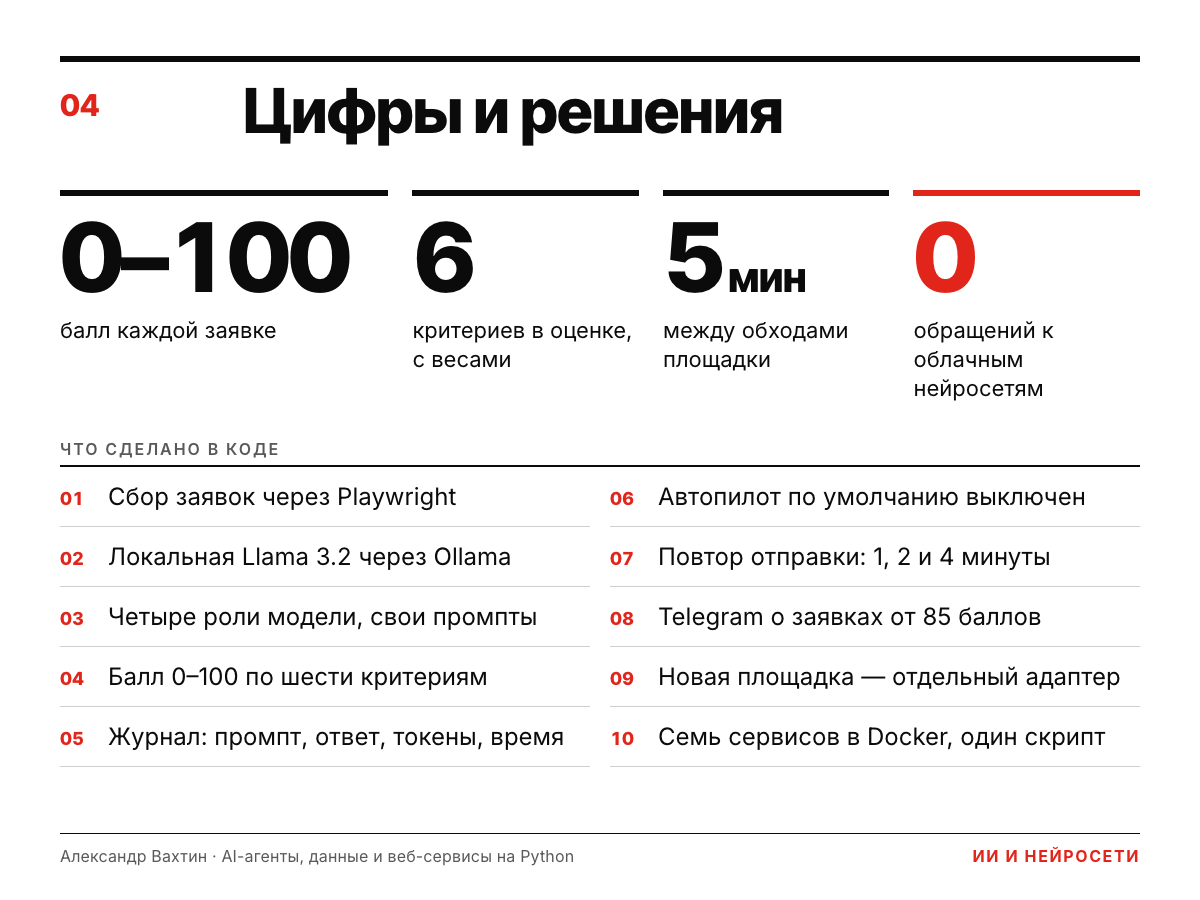
Конвейер фоновых задач: сбор, отсев, оценка, черновик отклика, отправка, диалог и отдельный наблюдатель за сделками. Задачи разнесены по пяти очередям Celery, чтобы медленный вызов модели не задерживал обход площадки. Обход идёт по расписанию раз в 5 минут, до 50 заявок за проход, уже виденные отсекаются.
Сбор через Playwright. Headless-браузер входит в аккаунт, читает ленту заявок и разбирает бюджет — почасовой или фиксированный. Площадка подключается адаптером с общим интерфейсом: войти, получить заявки, отправить отклик, прочитать и написать сообщение. Ядро о конкретной площадке ничего не знает.
Четыре роли языковой модели, у каждой свой промпт и свой формат ответа:
— фильтр отсекает неподходящее по ключевым словам, бюджету, ясности задачи и рискам, помечает категорию и флаги рисков;
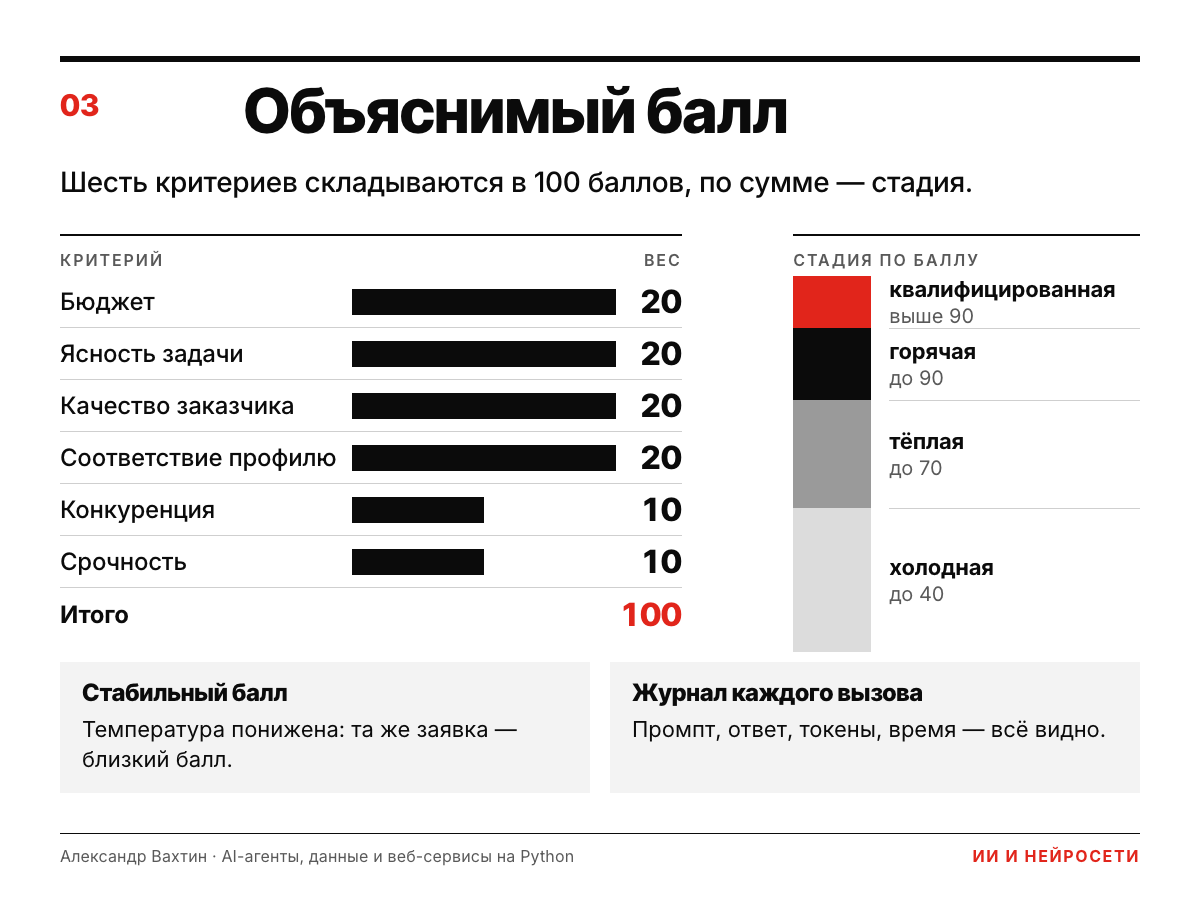
— оценщик ставит балл 0–100 по шести критериям с весами: бюджет, ясность задачи, качество заказчика и соответствие профилю — по 20 баллов, конкуренция и срочность — по 10. По тем же границам выставляется стадия: холодная до 40, тёплая до 70, горячая до 90, выше — квалифицированная;
— автор отклика пишет персональный текст под конкретную задачу по заданной структуре, а не подставляет шаблон;
— диалоговый агент ведёт переписку и признаёт сделку квалифицированной, только когда подтверждены все пять сигналов: бюджет, объём, сроки, лицо, принимающее решение, и готовность начать.
Локальная модель: Llama 3.2 через Ollama на своей машине, поднимается вместе с остальными сервисами. Ни одного обращения к облачным нейросетям.
Ответ модели — строгий JSON. Разбор страхует от типичного мусора вокруг структуры: обёрток разметки и лишнего текста. Для структурированных ответов температура понижена, чтобы одна и та же заявка получала близкий балл.
Журнал каждого вызова: промпт, ответ, модель, токены на входе и выходе, время выполнения — в отдельной таблице и в API. Если балл кажется странным, видно, на чём модель его построила.
Контроль за человеком. Три режима автономности: безопасный, с проверкой и автономный. Автоотправка возможна только в автономном, и по умолчанию автопилот выключен. Любую сделку можно поставить на паузу отдельно. Отправка при сбое повторяется трижды с нарастающей паузой: через 1, 2 и 4 минуты.
Уведомления: наблюдатель раз в 10 минут проверяет сделки и присылает в Telegram горячие от 85 баллов и квалифицированные — бюджет, балл, категория, риски, ссылка.
Панель на React и TypeScript: сводка, лента заявок с фильтрами, доска сделок по стадиям, отклики, переписка, настройки стратегии и ключевых слов.
Развёртывание: семь сервисов в Docker — база, очередь, модель, API, обработчик, планировщик, интерфейс. Запуск одним скриптом, инструкции под Linux с видеокартой, Windows и macOS на Apple Silicon.
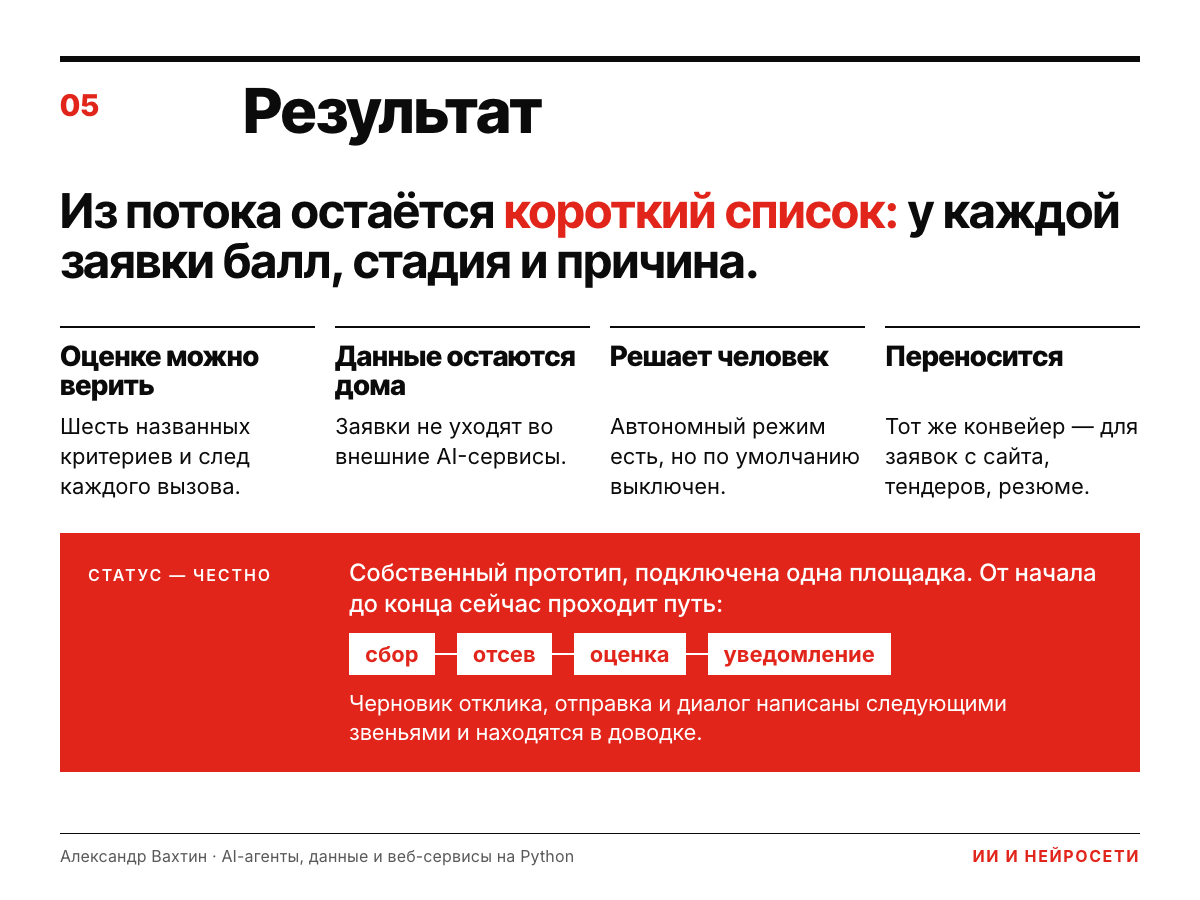
Из потока остаётся короткий список. Сбор, отсев и оценка идут по расписанию без участия человека: неподходящее отбрасывается с причиной, остальное получает балл от 0 до 100 и стадию. Горячие заявки сами приходят в Telegram — заходить на площадку проверить, не появилось ли что-то, больше не нужно.
Оценке можно верить, потому что её можно проверить. Балл складывается из шести названных критериев, а в журнале лежит полный след: что модель получила, что ответила и за сколько. Вопрос «почему нейросеть так решила» закрывается чтением записи, а не догадками.
Данные остаются дома. Модель работает на своей машине, заявки и переписка не уходят во внешние AI-сервисы. Это снимает вопрос, который чаще всего тормозит внедрение нейросети в работу с клиентскими данными.
Последнее слово за человеком. Автономный режим есть, но по умолчанию выключен: система готовит, человек решает.
Архитектура переносится на другую задачу. Ключевые слова и бюджетные пороги задаются стратегией с историей версий, новая площадка — отдельный адаптер. Тот же конвейер «собрать → отсеять → оценить → уведомить» подходит для заявок с сайта, тендеров или резюме.
Статус — честно. Это собственный прототип, а не коммерческий продукт, подключена одна площадка. От начала до конца сейчас проходит путь «сбор → отсев → оценка → уведомление»; черновик отклика, отправка и диалог написаны как следующие звенья конвейера и находятся в доводке.