AI-агенты, данные и веб-сервисы на Python: от идеи до продакшена
- Город
- Москва
- Опыт работы
- 8 лет
- На сайте с
- 2026 года
- Юридический статус
- ИП
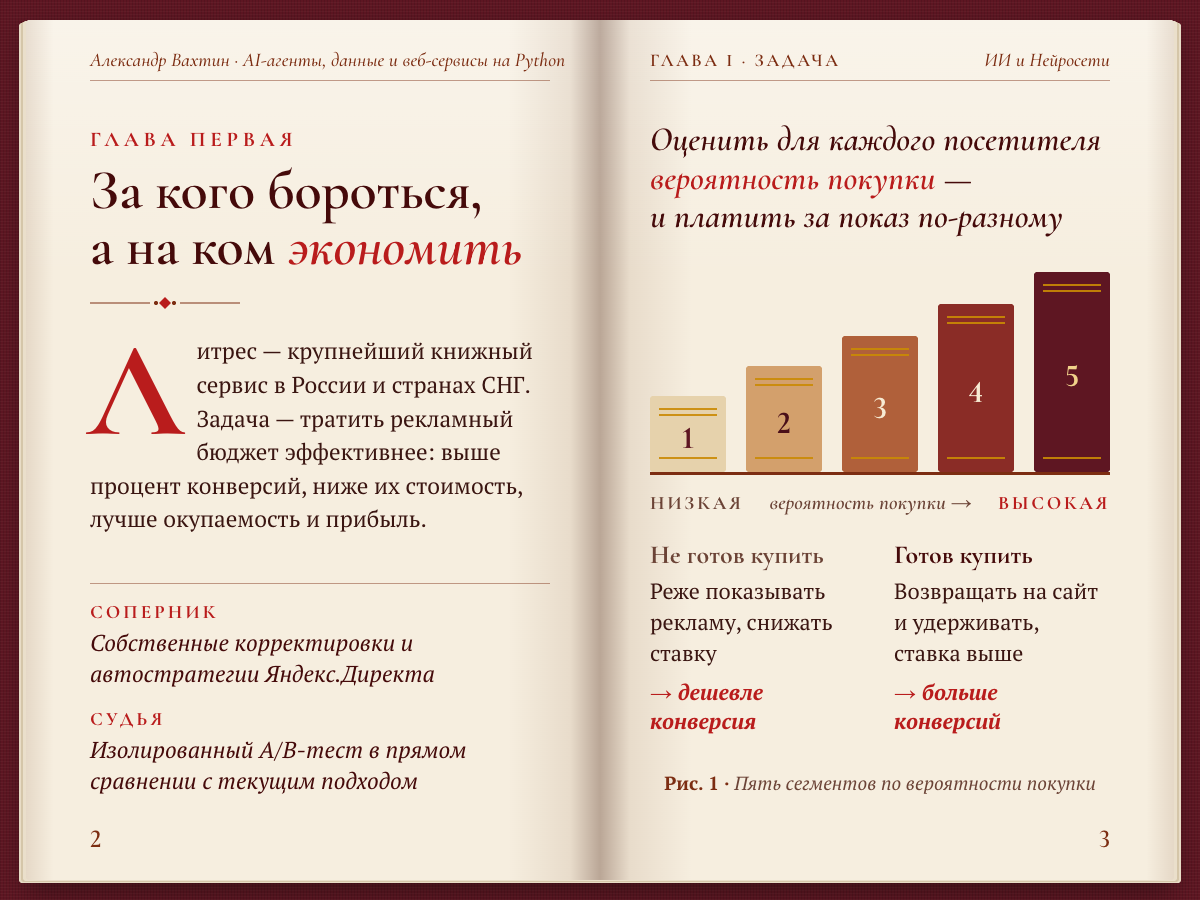
Литрес — крупнейший книжный сервис в России и странах СНГ. Задача — тратить рекламный бюджет эффективнее: поднять процент конверсий, снизить стоимость конверсии, улучшить окупаемость и прибыль.
Идея — оценить для каждого посетителя сайта вероятность покупки. За тех, кто готов купить, бороться активнее: возвращать на сайт и удерживать. Тем, кто не готов, реже показывать рекламу и снижать по ним ставки.
Соперник был известен заранее. Кампании в Яндекс.Директе уже работали на комбинации собственных корректировок и автостратегий Директа. Новый подход должен был обыграть именно его — в прямом сравнении, а не на бумаге.
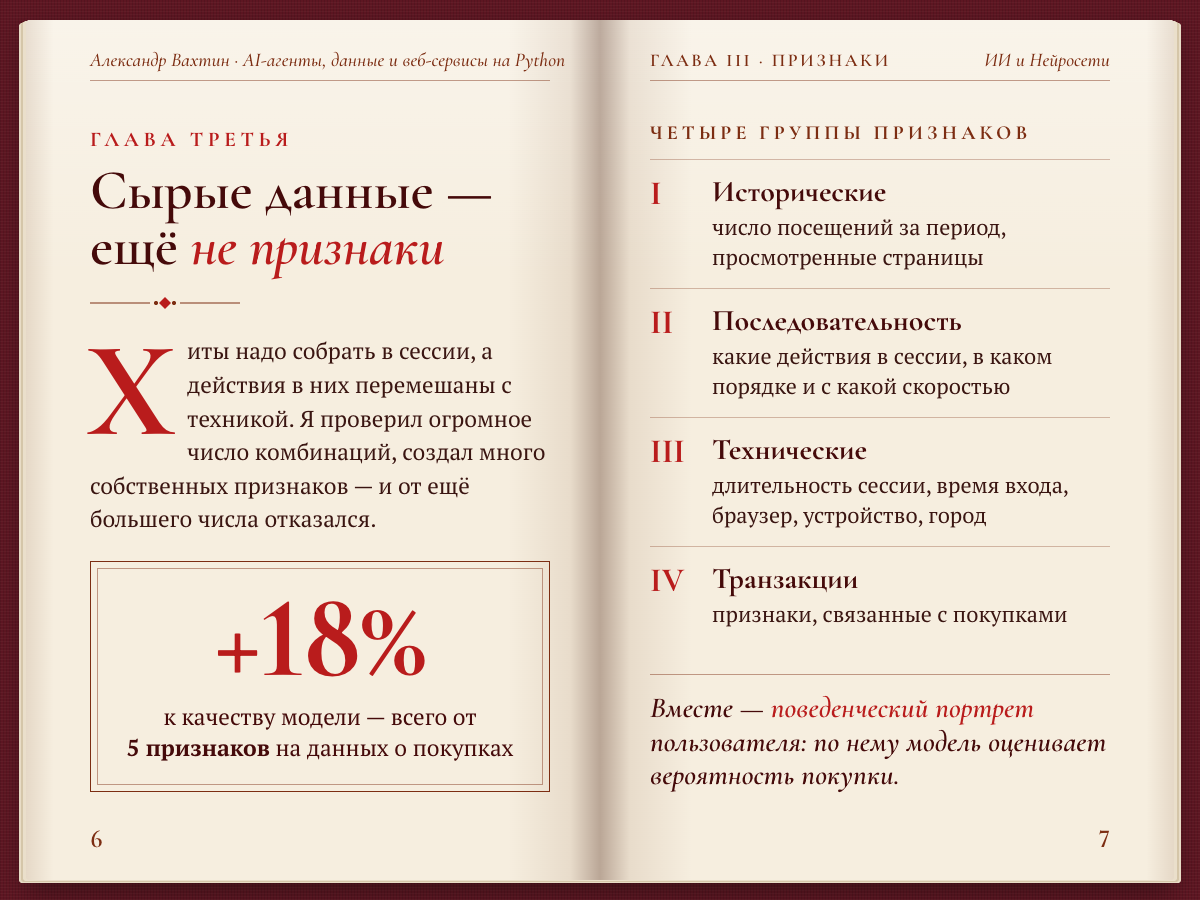
Основа — сквозная аналитика, построенная для Литрес: она собирает данные о поведении пользователей. Но сырые данные — ещё не признаки для модели:
— это хиты Google Analytics, которые сначала нужно собрать в сессии;
— действия пользователя (какие страницы смотрел, что покупал) перемешаны с технической информацией: устройство, браузер, время входа;
— важность большинства полей интуитивно оценивается неверно;
— большая часть информации для машинного обучения не подходит вовсе.
Отдельное требование — измерить реальное влияние системы на рекламу: не оценкой «сколько могло бы быть», а изолированным A/B-тестом против текущего подхода.
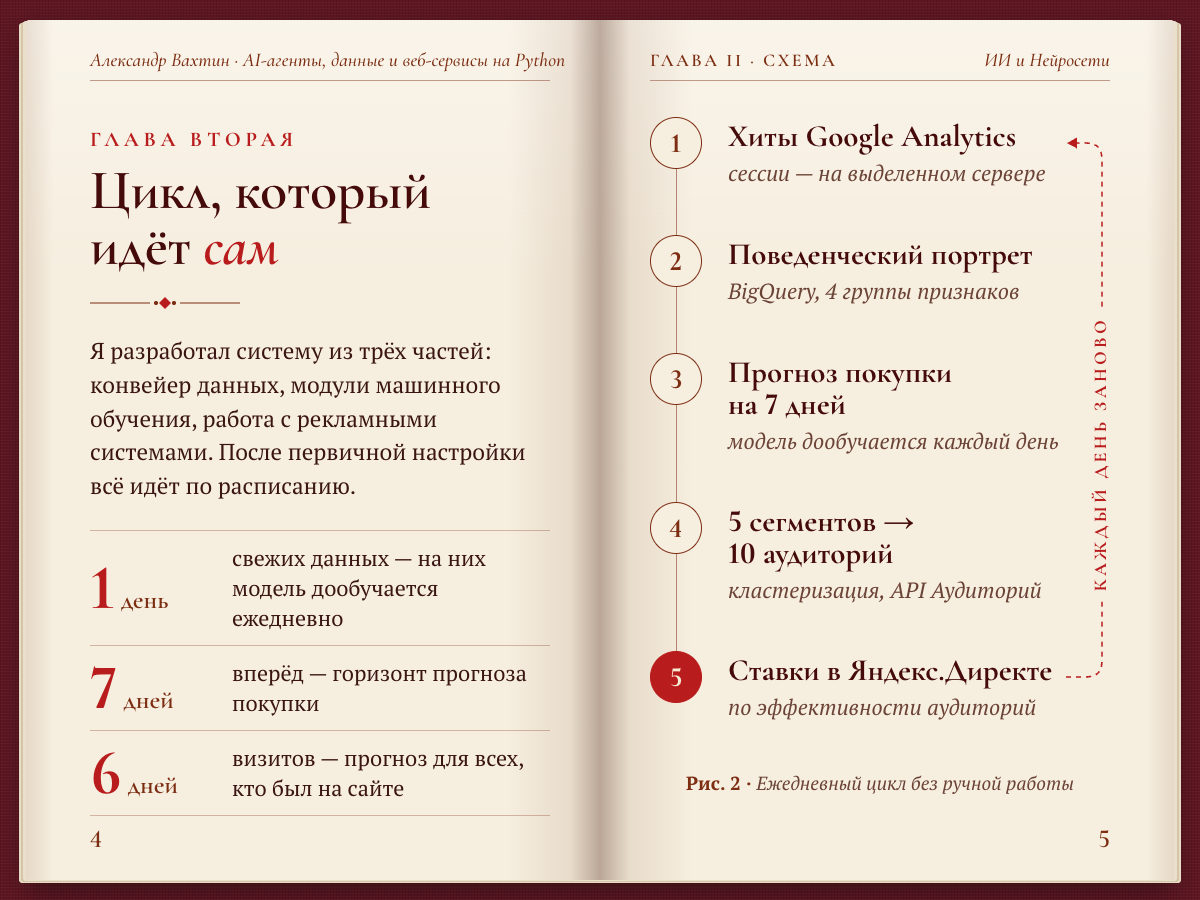
Систему предсказания вероятности покупки разработал я. Литрес — первый проект, где она заработала. В системе три части: конвейер обработки данных, модули машинного обучения и работа с рекламными системами.
Данные. Хиты Google Analytics по собственным алгоритмам собираются в сессии на выделенном сервере. Предобработанная выборка выгружается из BigQuery на сервер с моделью.
Признаки — самый трудоёмкий этап, от него зависит качество модели. Я проверил огромное число комбинаций, создал много собственных признаков и от ещё большего числа отказался. Остались четыре группы:
— исторические, накопительные: число посещений за период, просмотренные страницы;
— последовательность действий: что пользователь делает в сессии, в каком порядке и с какой скоростью;
— технические: длительность сессии, время входа, браузер, устройство, город;
— связанные с транзакциями.
Вместе они складываются в поведенческий портрет пользователя, по которому модель оценивает вероятность покупки. Главная находка — поведенческие признаки на данных о покупках: всего пять таких признаков сразу подняли качество модели на 18%.
Ежедневный цикл. После первичной настройки всё идёт само, по расписанию:
— дообучение: модель дообучается на новых данных за один день;
— прогноз: вероятность покупки в ближайшие семь дней для всех, кто был на сайте за последние шесть дней;
— кластеризация: пользователи делятся на пять групп по вероятности покупки;
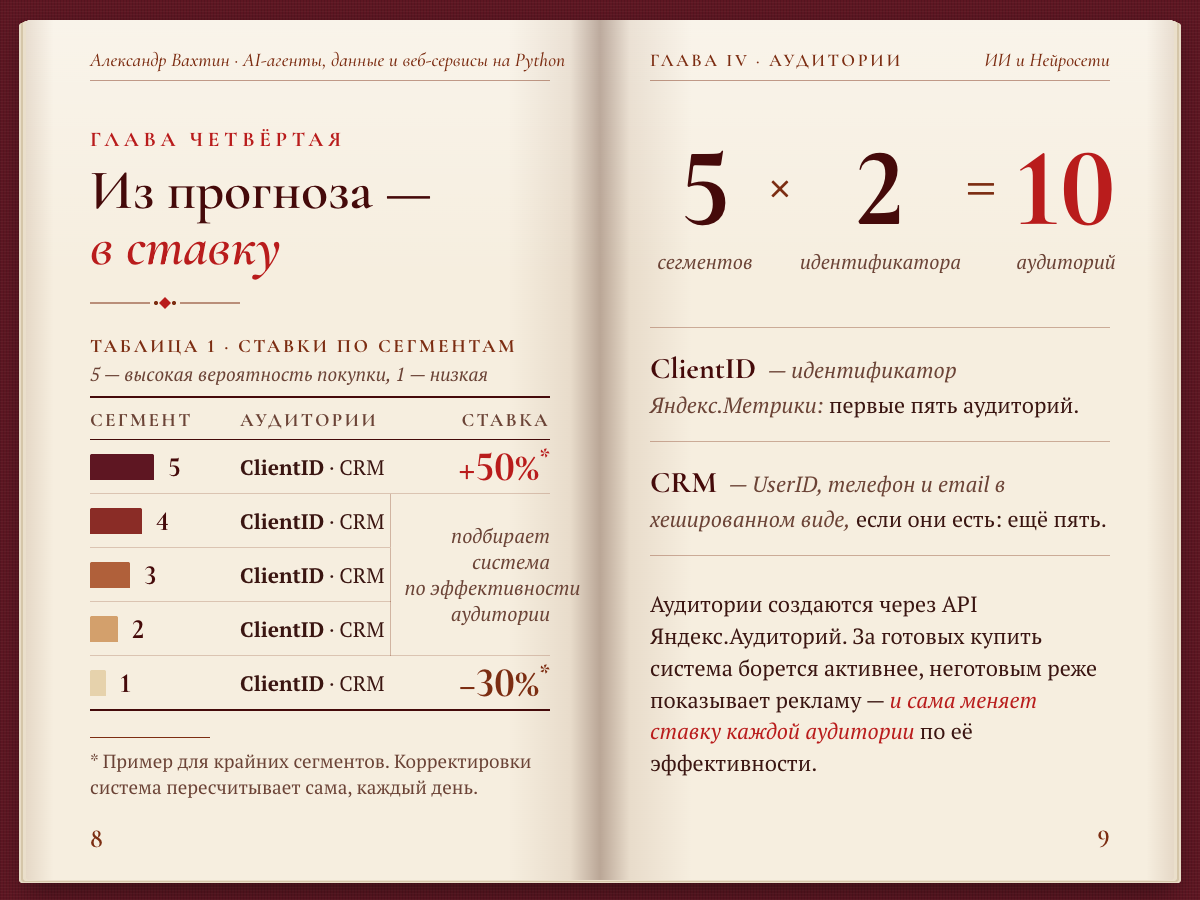
— аудитории по ClientID: через API создаются аудитории в Яндекс.Аудиториях, идентификатор — ClientID Яндекс.Метрики;
— обогащение из CRM: к ClientID подтягиваются UserID, телефон и email в хешированном виде, если они есть, — по ним строится второй набор аудиторий;
— ставки: система сама меняет корректировку для каждой аудитории по её эффективности.
Из прогноза — в ставку. На выходе 10 аудиторий: пять по ClientID и пять по CRM-идентификаторам. В Директе на каждую висит своя корректировка. Например, для самых вероятных покупателей ставка выше на 50%, а тем, у кого вероятность низкая, реклама показывается реже — ставка ниже на 30%.
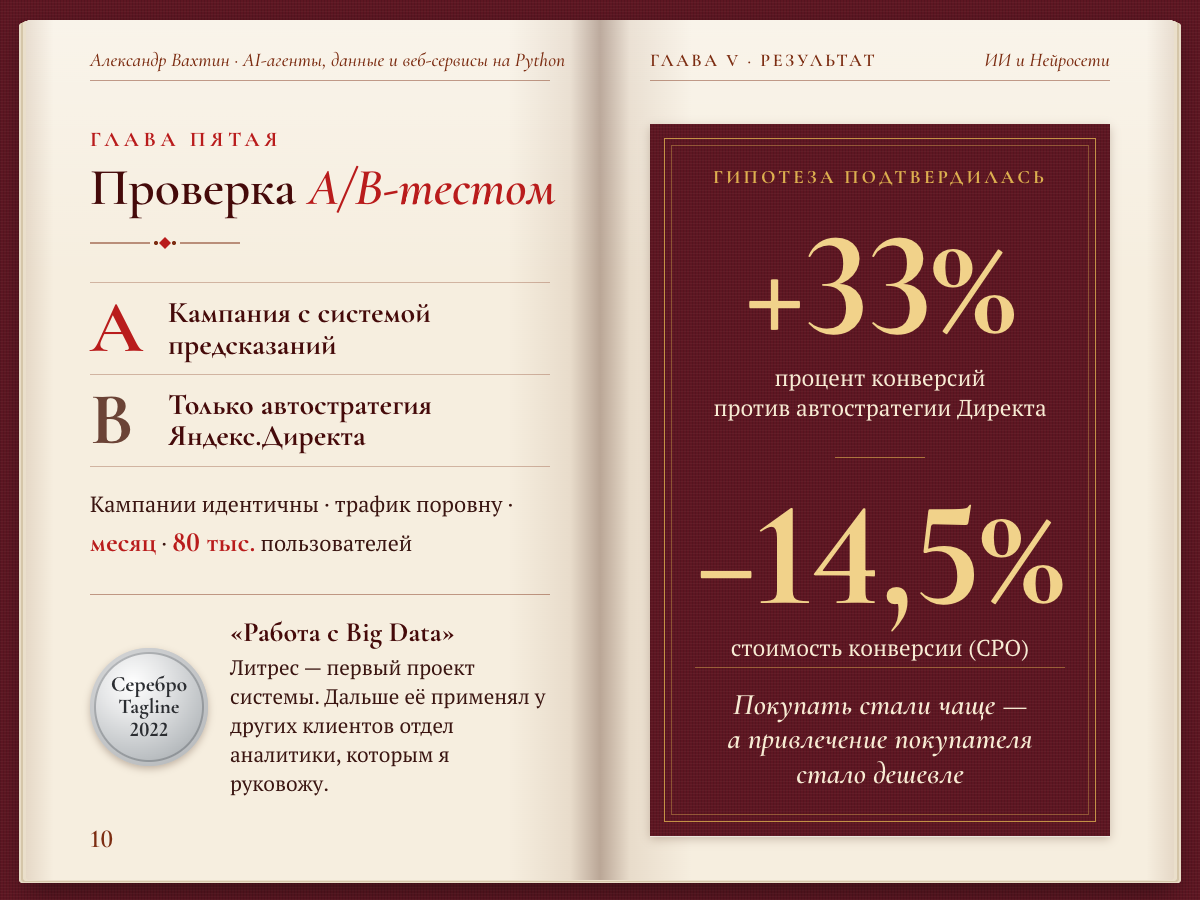
Проверка. Вместе с Литрес и Яндекс.Директом мы провели изолированный A/B-тест. Гипотеза: система поднимет процент конверсий (CR) и снизит стоимость конверсии (CPO). Группа A — кампания с системой предсказаний, группа B — только автостратегия Директа. В остальном кампании идентичны, трафик делится поровну. Тест шёл месяц, в нём участвовали 80 тысяч пользователей.
Гипотеза подтвердилась. По сравнению с группой B, где работала только автостратегия Директа:
— процент конверсий вырос на 33%;
— стоимость конверсии снизилась на 14,5%.
Проще говоря, из тех, кто пришёл с рекламы, покупать стали чаще — а привлечение покупателя при этом стало дешевле. Обе метрики сдвинулись в нужную сторону одновременно: рост покупок не пришлось оплачивать дороже.
Результату можно доверять. Это не расчёт задним числом, а изолированный тест: одинаковые кампании, трафик поровну, месяц, 80 тысяч пользователей.
Эффект не разовый. Система каждый день оценивает, как работают аудитории, и сама двигает ставки по актуальным показателям. Бюджет расходуется эффективнее и подстраивается под изменения в поведении пользователей.
Сопровождение дешёвое: после первичной настройки выгрузка данных, обучение, прогнозы и ставки работают сами, по расписанию.
Кейс «Литрес» взял серебро Tagline Awards 2022 в номинации «Работа с Big Data».
Литрес стал первым проектом системы. Дальше команда отдела аналитики, которым я руковожу, применяла её в проектах других клиентов.
Проверить (статью о кейсе на сайте StreamMyData писал я):
https://streammydata.ru/projects/uvelichili-chislo-pokupok-na-sajte-litres-na-33/
https://medianation.ru/cases/uvelichili-chislo-pokupok-na-33-/
https://medianation.ru/about/
Команда отдела аналитики MediaNation. Моя роль — автор системы предсказания вероятности покупки и руководитель проекта; я автор этого кейса на сайте StreamMyData.