ML, парсеры и боты на Python — с проверяемым результатом
- На сайте с
- 2026 года
- Юридический статус
- Самозанятый
Безопасная сделка
Деньги списываются после приёмки
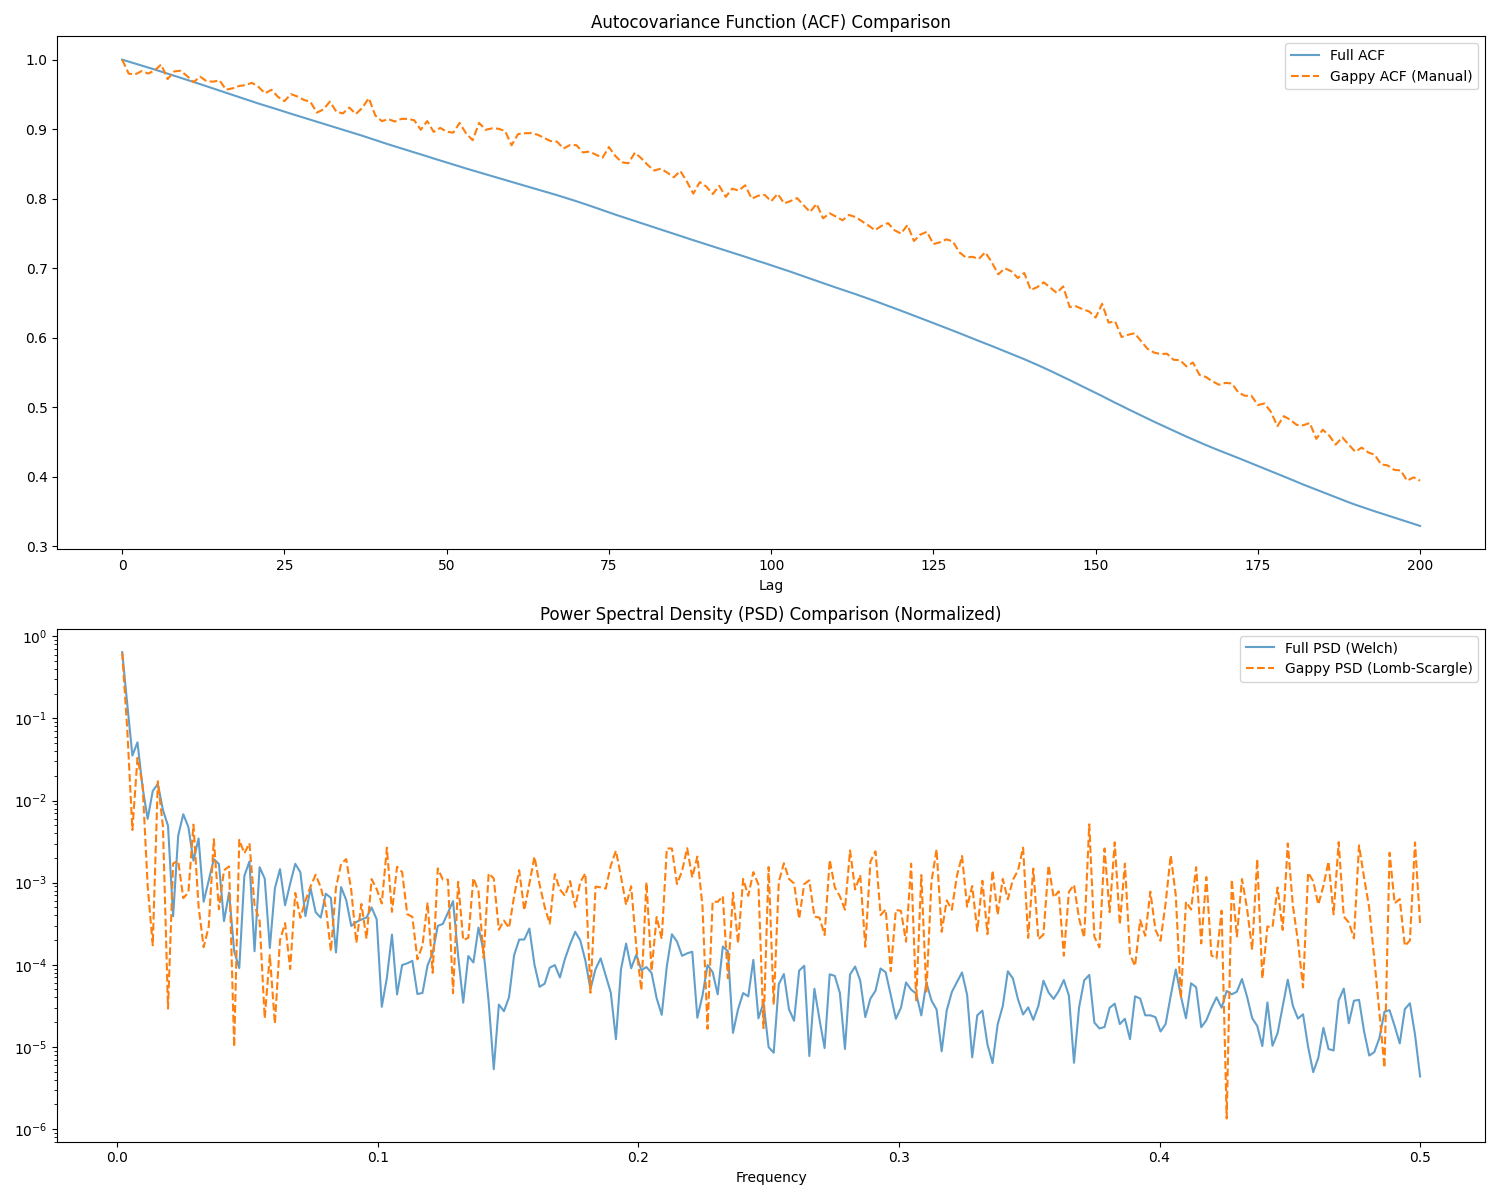
Собственный проект, не клиентский заказ. Вопрос — насколько можно доверять статистике ряда, в котором часть данных потеряна.
Свечные данные SOL/USDT собираются через API биржи, затем из полного ряда искусственно выбиваются наблюдения. Оценки сравниваются: автоковариация напрямую против оценки по ряду с пропусками; спектральная плотность по Уэлчу против периодограммы Ломба–Скаргла.
Стек: Python, NumPy, SciPy, pandas, API биржи.
Видно, где пропуски завышают оценку, а где ломают спектр — и какой метод остаётся надёжным. Код открыт на GitHub (Levos06/sol_analisys).