ML, парсеры и боты на Python — с проверяемым результатом
- На сайте с
- 2026 года
- Юридический статус
- Самозанятый
Безопасная сделка
Деньги списываются после приёмки
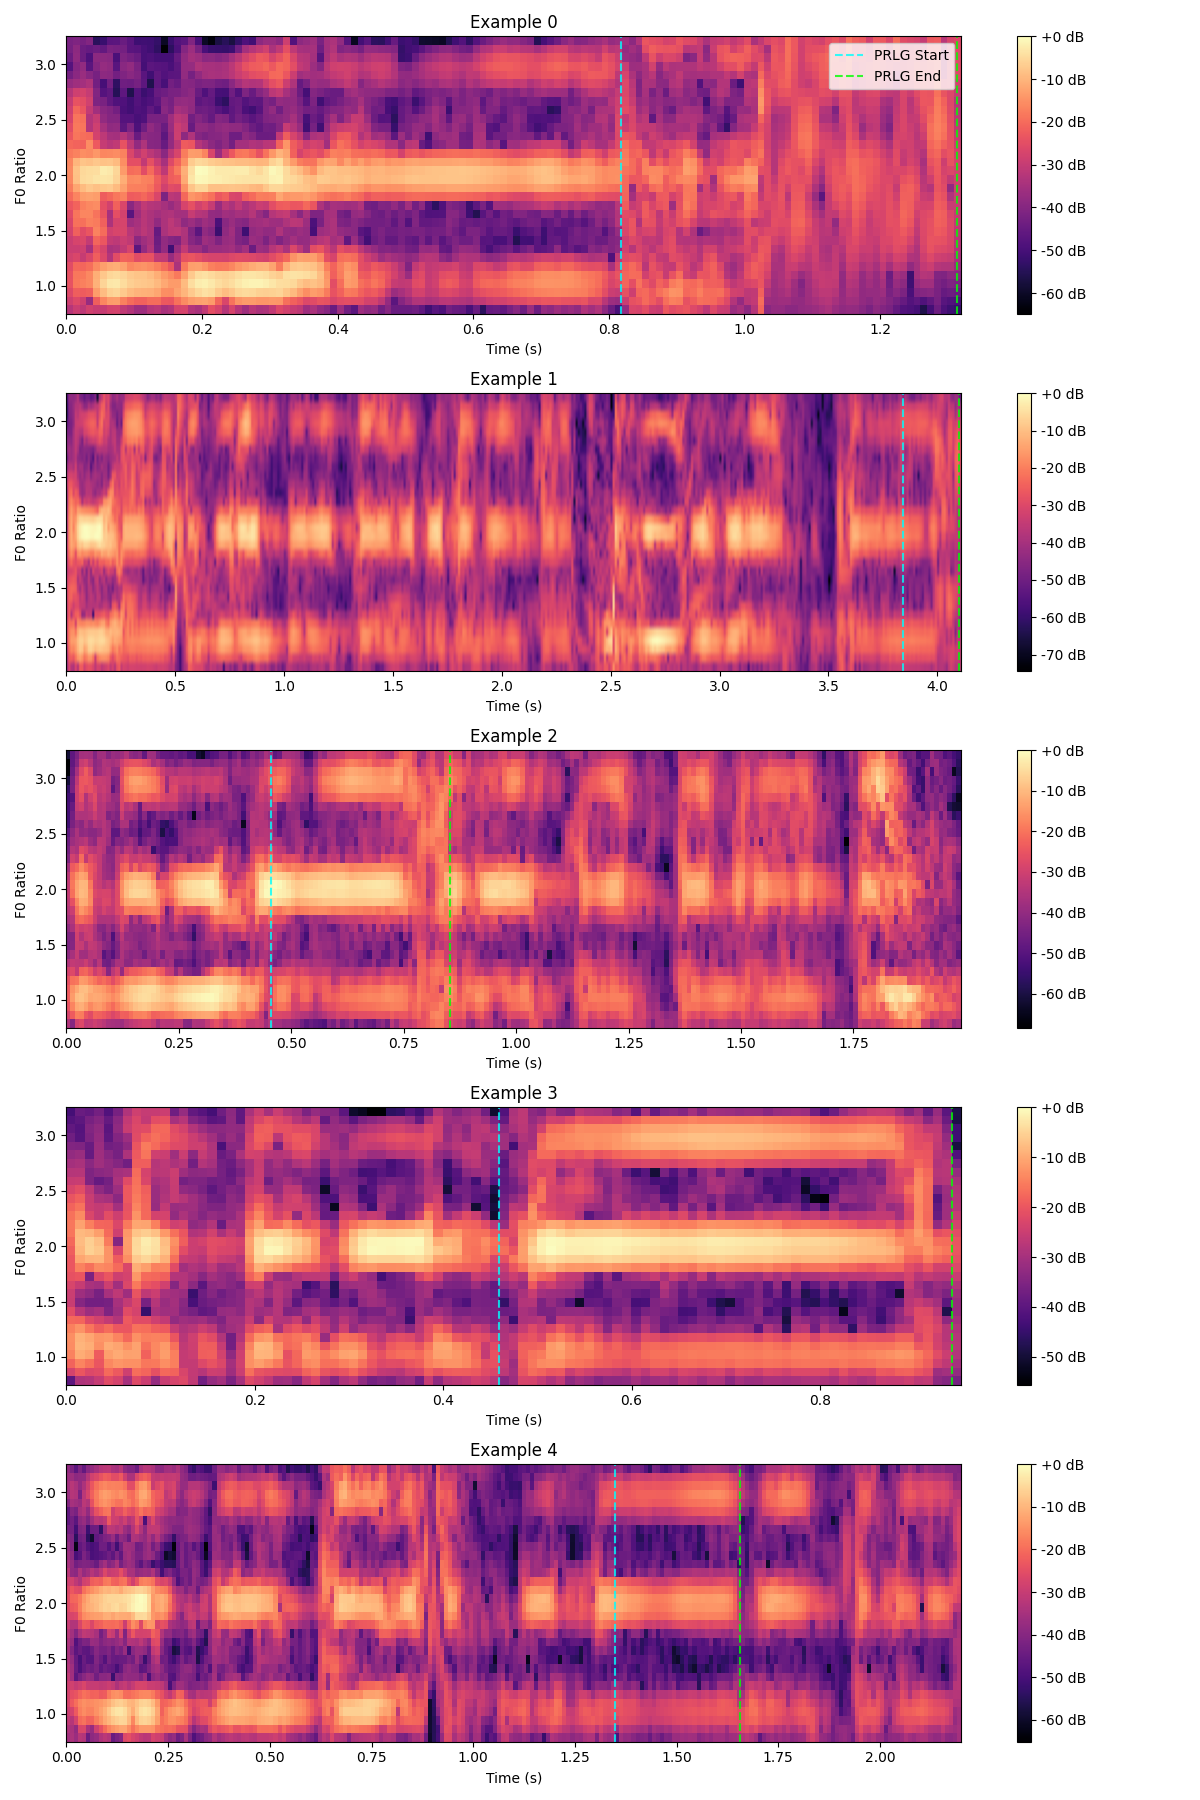
Собственный проект, не клиентский заказ. Задача — автоматически находить в записи речи растянутые звуки (один из маркеров заикания) и размечать их на временной шкале, чтобы не делать это вручную по каждой записи.
Из аудио извлекаются покадровые эмбеддинги Whisper-small: слои 8, 10 и 11 энкодера, 2304 признака на каждые 20 мс. Поверх них обучен CatBoost, предсказания сглаживаются медианным фильтром.
На выходе — скрипт, который берёт исходный TextGrid, добавляет в него слой disfluencies и записывает найденные интервалы.
Стек: Python, PyTorch, Whisper, CatBoost, praat-textgrids.
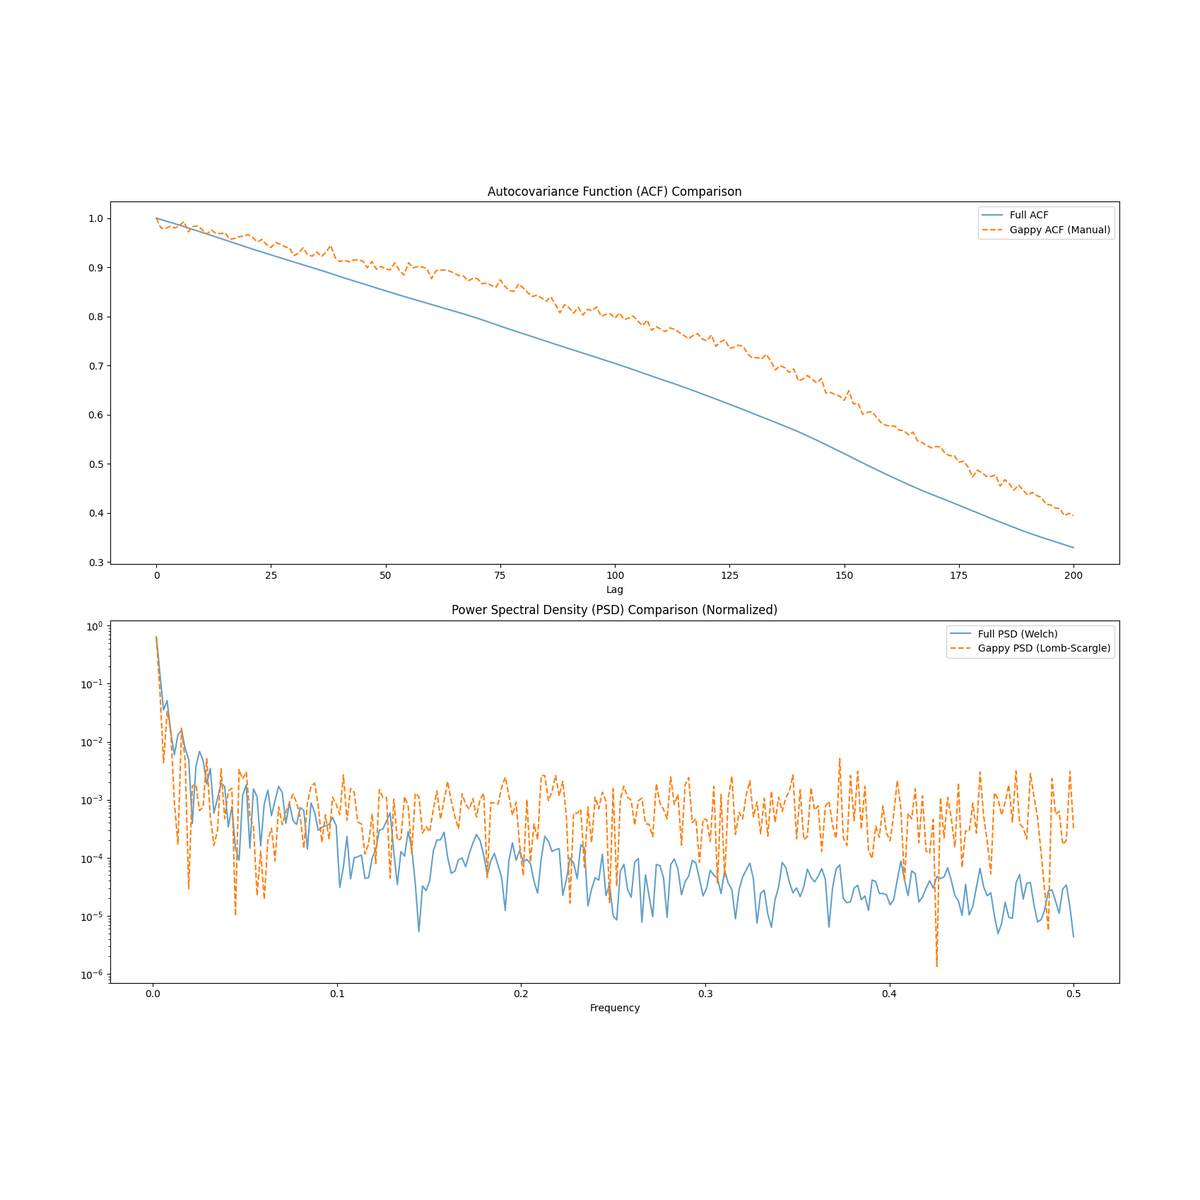
ROC-AUC 0.96 на валидации и 0.90 на отложенном тесте с дикторами, которых модель не слышала. Второе число важнее: оно показывает, что модель не запомнила голоса. Код открыт на GitHub (Levos06/prolongation-detector).