AI-автоматизация, n8n, Python, Telegram-боты и FastAPI
- Опыт работы
- 3 года
- На сайте с
- 2025 года
- Юридический статус
- ИП
Собственный демонстрационный проект RAG-ассистента, который отвечает на вопросы пользователя на основе загруженной базы знаний.
Задача — реализовать AI-сценарий, в котором документы предварительно преобразуются в embeddings и сохраняются в векторной базе, а при обращении пользователя система ищет релевантный контекст и передаёт его LLM для формирования ответа.
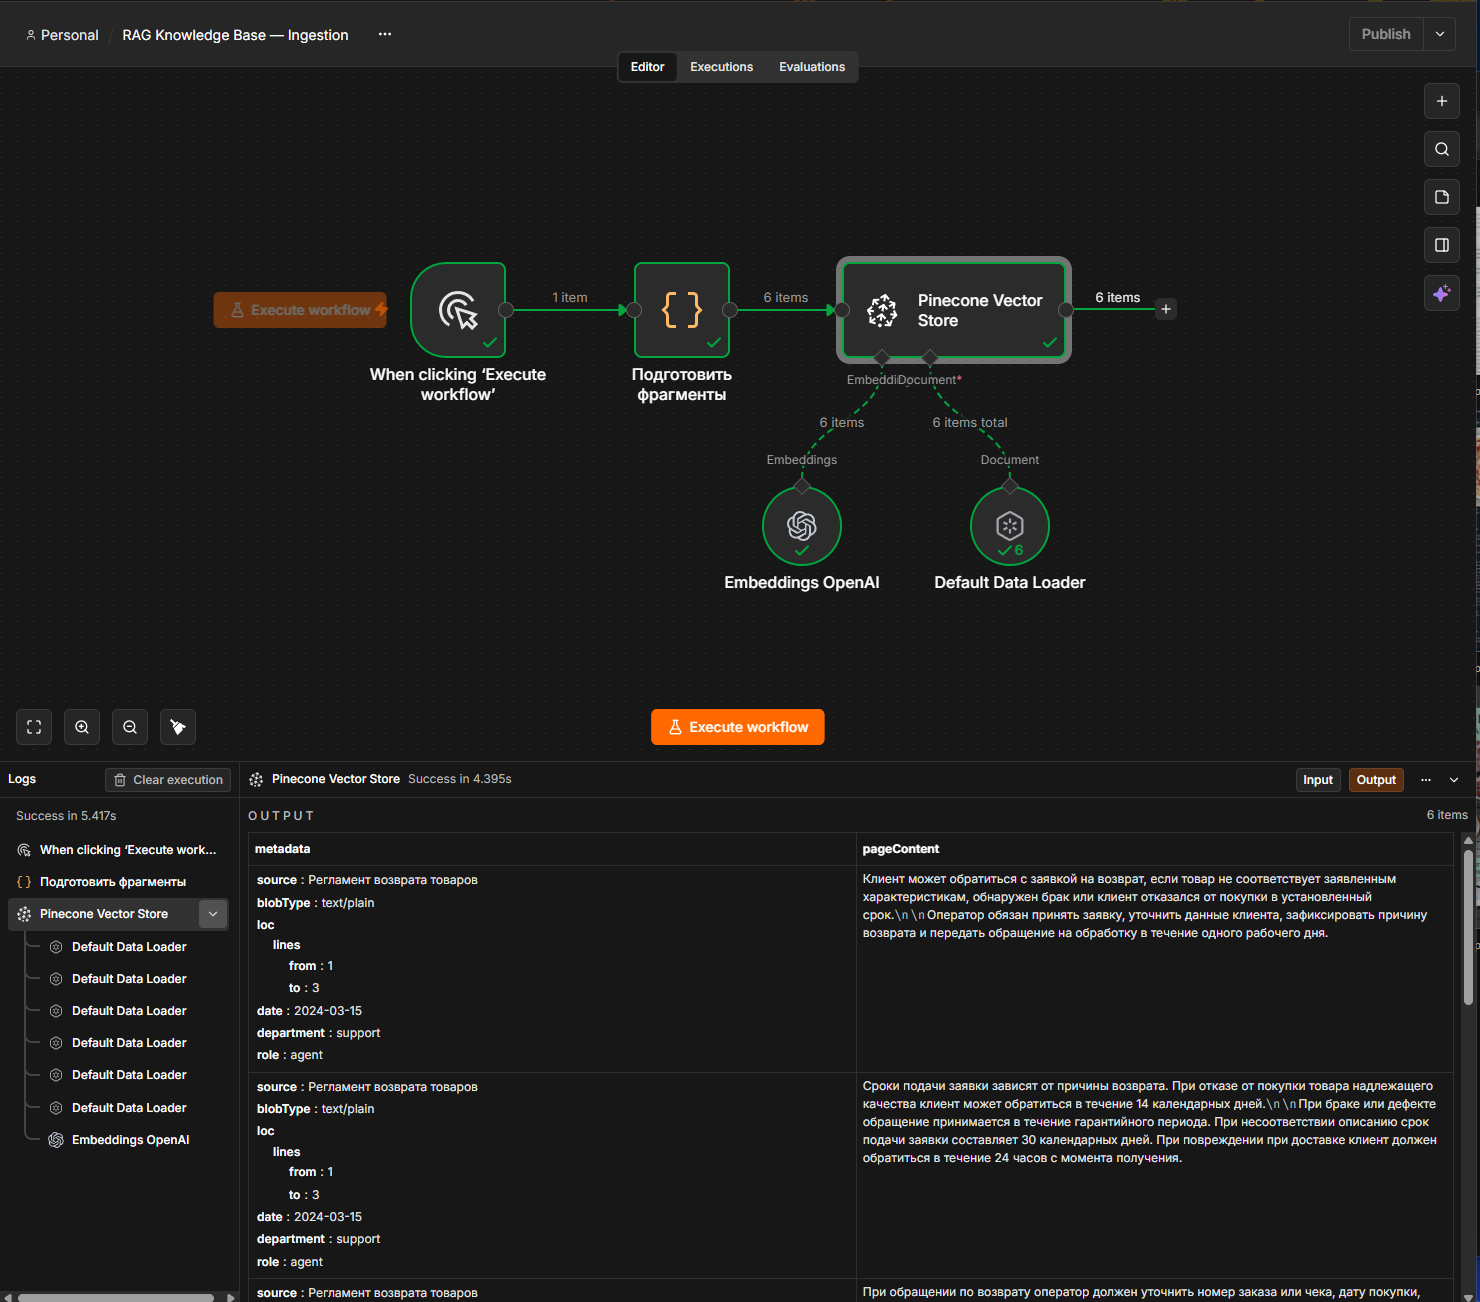
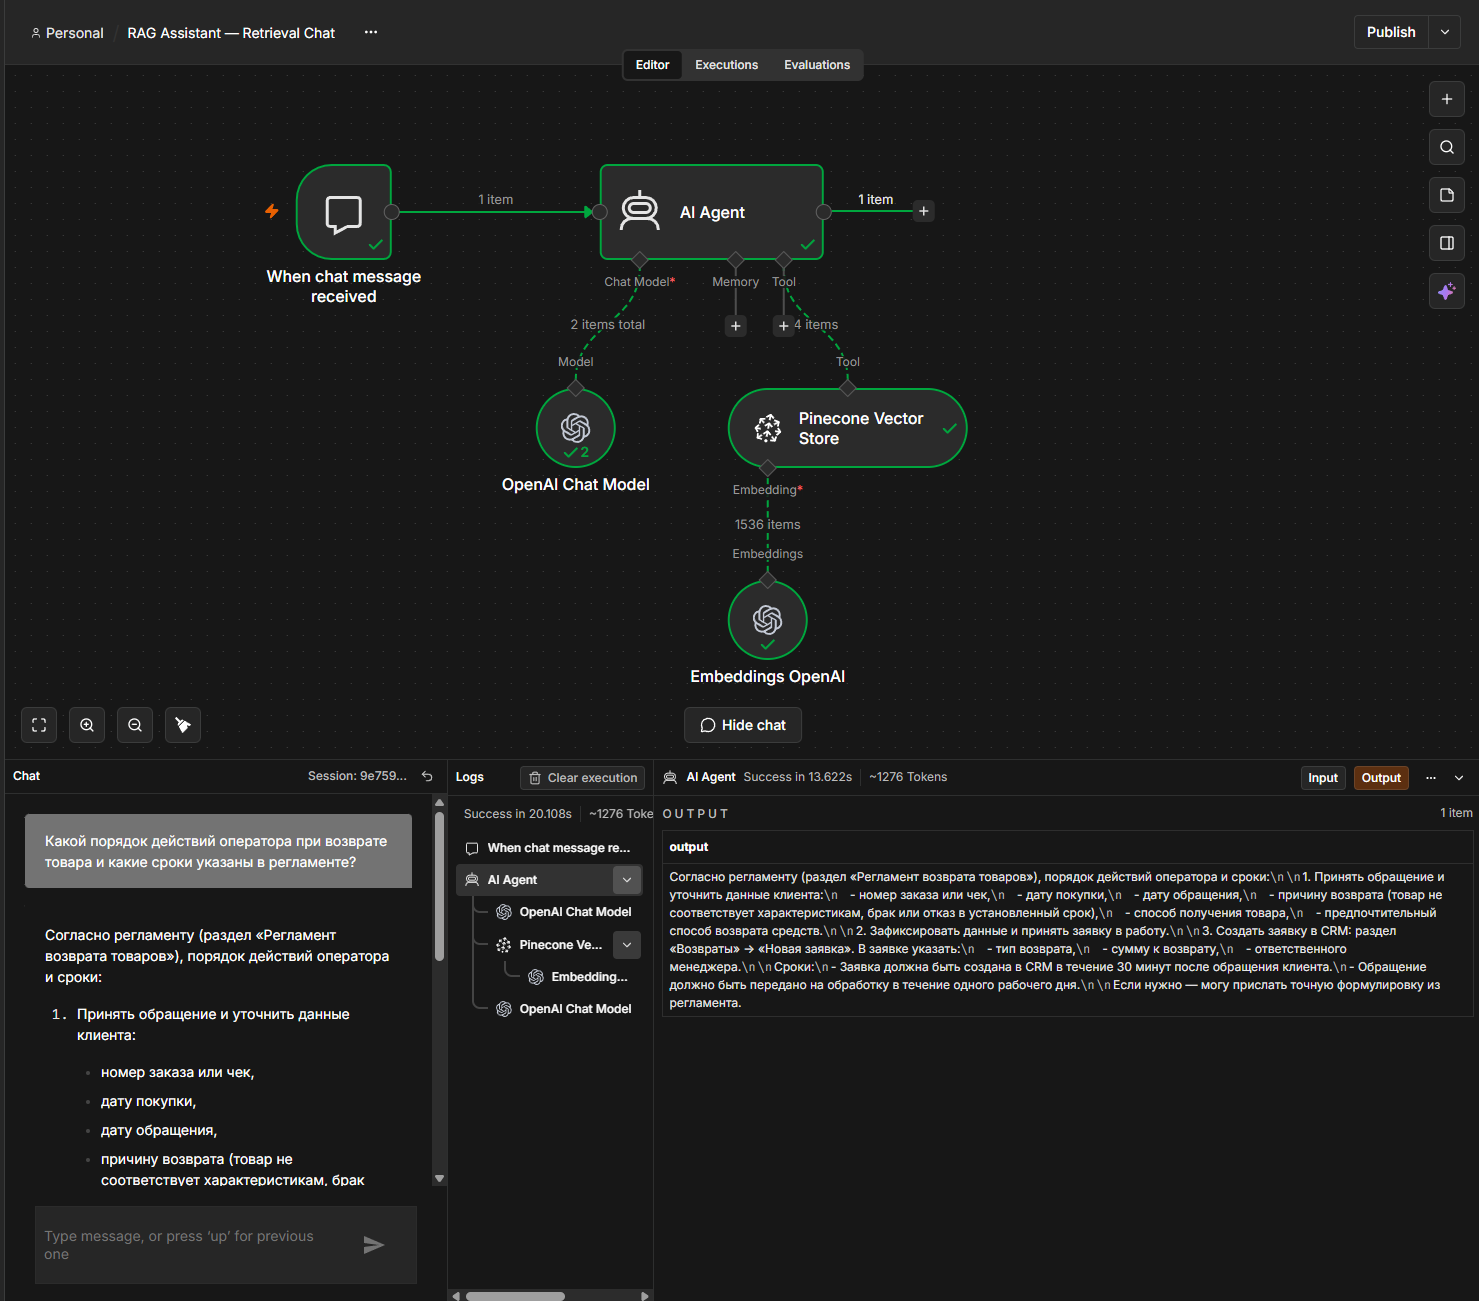
Проект собран в n8n и разделён на два независимых workflow: загрузка базы знаний и обработка пользовательских запросов.
Реализовал RAG-pipeline в n8n с использованием OpenAI и Pinecone.
Первый workflow отвечает за подготовку базы знаний:
— получение исходных документов;
— подготовку данных;
— преобразование текста в embeddings через OpenAI;
— сохранение в Pinecone Vector Store.
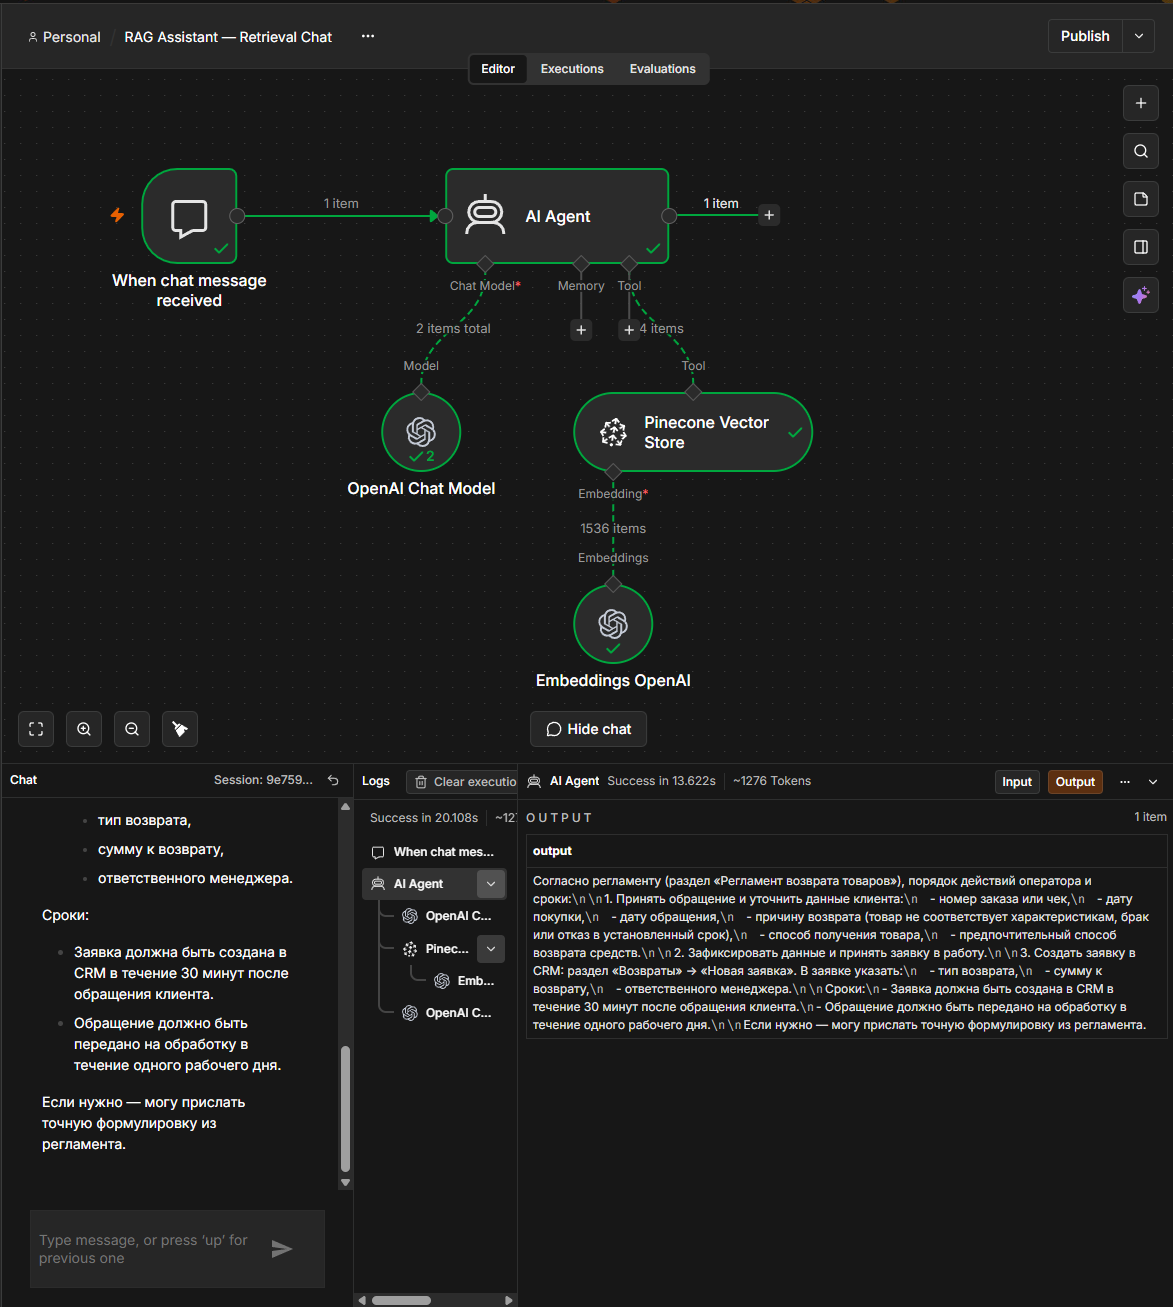
Второй workflow обрабатывает запрос пользователя:
— принимает сообщение;
— передаёт его AI Agent;
— выполняет поиск релевантных фрагментов в Pinecone;
— использует найденный контекст при формировании ответа через OpenAI Chat Model.
Архитектура разделяет этап индексации данных и этап retrieval, поэтому базу знаний можно обновлять независимо от пользовательского сценария.
Дополнительно реализовал альтернативный вариант RAG-архитектуры на Supabase Vector Store с векторным поиском через PostgreSQL/pgvector и памятью диалога.
Это показывает, что retrieval-архитектура не привязана к одному векторному хранилищу: в зависимости от задачи можно использовать как Pinecone, так и Supabase.
В результате собран работающий RAG-сценарий, позволяющий AI-ассистенту отвечать не только на основе знаний модели, а использовать информацию из собственной базы знаний.
Такой подход может применяться для:
— внутренних баз знаний компании;
— инструкций и регламентов;
— FAQ и службы поддержки;
— продуктовой документации;
— базы обучения сотрудников;
— корпоративных AI-ассистентов.
Проект демонстрирует практическую работу с n8n, embeddings, vector search, Pinecone и LLM.
Исходный код и обезличенные n8n workflow:
https://github.com/Andrei-Blagov/n8n-rag-knowledge-assistant