AI/ML-инженер и product builder | NURM · CV · iOS
- На сайте с
- 2026 года
- Юридический статус
- Частное лицо
Построить не очередную обёртку над внешним AI API, а собственную приватную open-weight модель и фабрику, которая умеет системно улучшать её на проверенных результатах. Цикл должен запускать агентов в контролируемых одноразовых песочницах, проверять работу исполняемыми тестами, превращать подтверждённые провалы в материал для следующей версии и честно сравнивать базу с кандидатом на замороженных held-out задачах. Обязательные ограничения: разделение train/eval, воспроизводимость, происхождение артефактов, контроль стоимости, откат, обнаружение подмены тестов и запрет на promotion при регрессиях.
Собрал end-to-end контур на Python и PyTorch: agent runtime и проверяемые инструменты, репозиторные песочницы, исполняемые валидаторы, трассировку и классификацию провалов, отбор данных, LoRA/SFT/RLVR-циклы, парные A/B-измерения, статистические promotion-гейты, lineage моделей и артефактов, Cockpit, маршрутизацию GPU и watchdog-выключение арендуемого compute. Рабочий цикл: Run → Verify → Measure → Improve. Неподтверждённые кандидаты отбрасываются, а продвижение требует прохождения заранее зафиксированных критериев и решения владельца. Runtime использует собственную open-weight модель; внешние frontier-модели — только офлайн-учителя или судьи на собственных данных, не runtime-мозг.
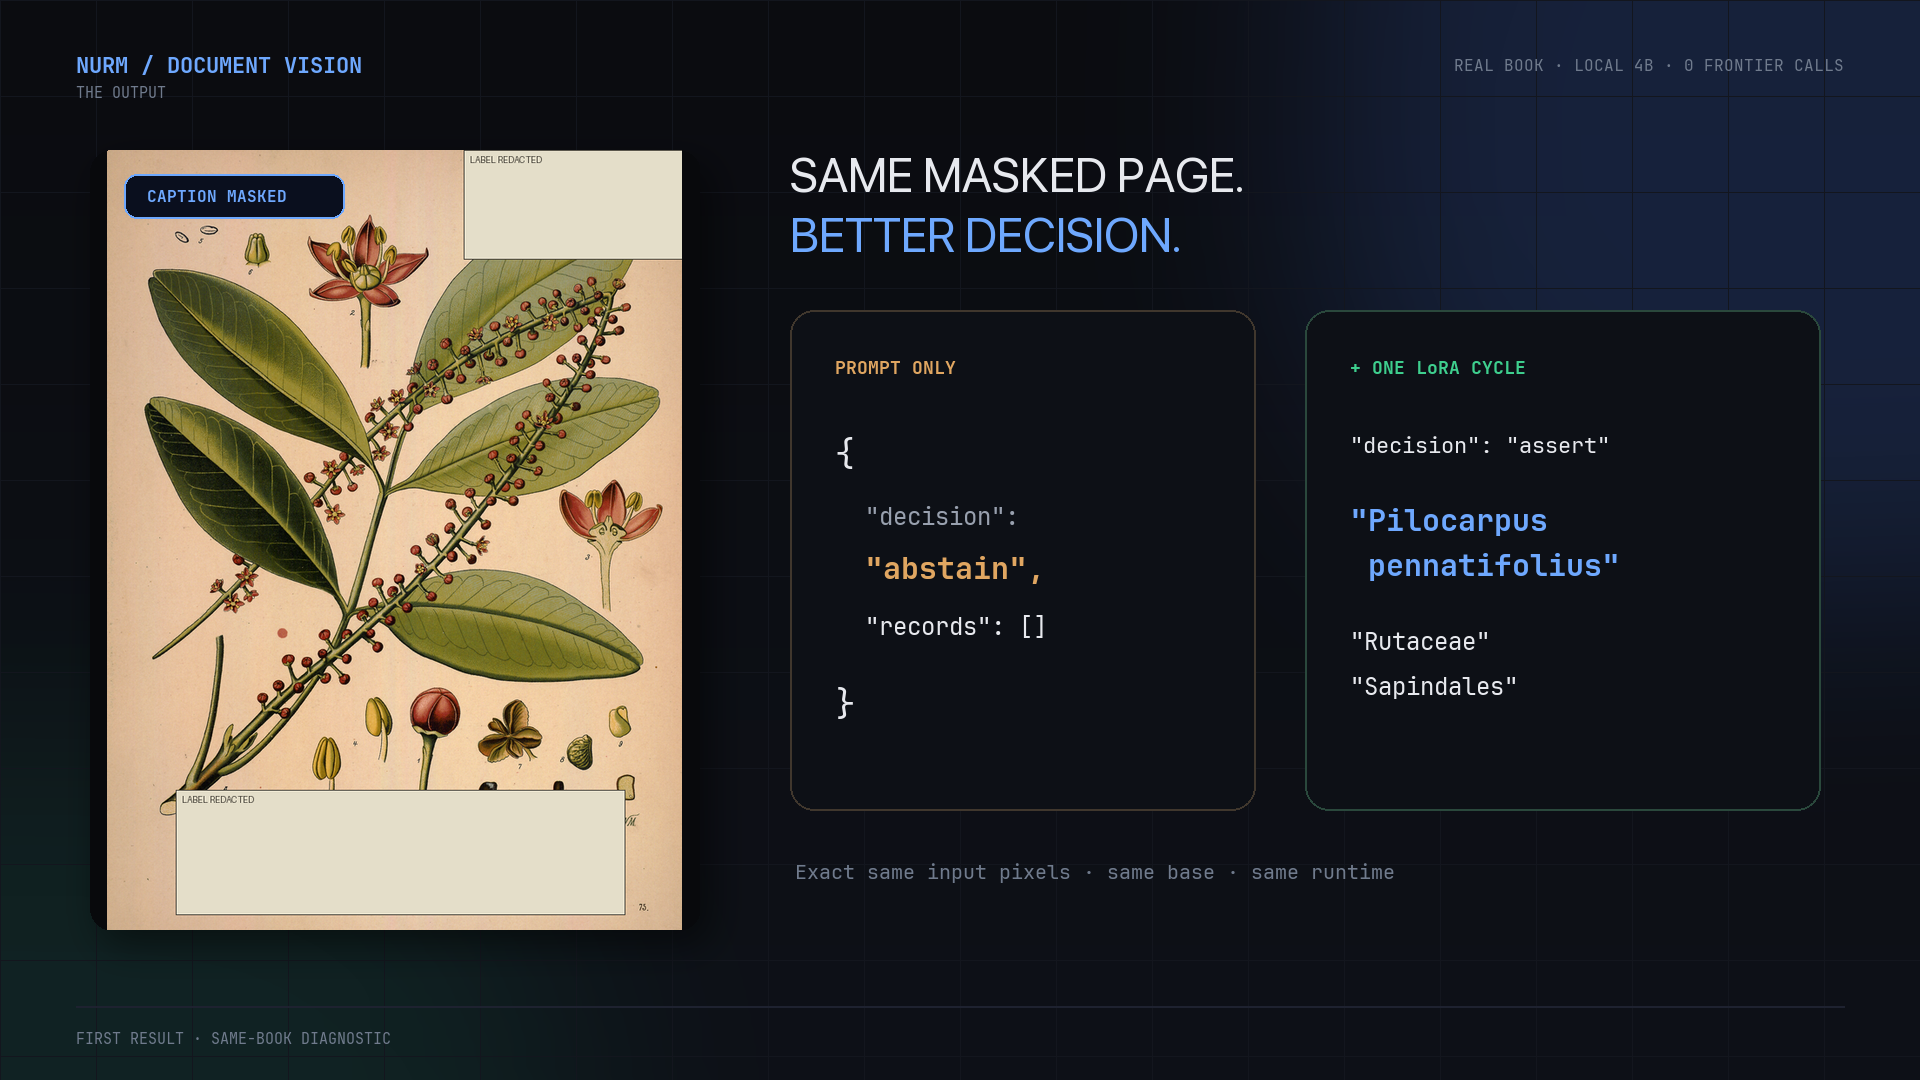
Фабрика работает end to end и публикует не только успехи, но и нулевые или отрицательные вердикты. Сильнейший публичный full-ladder v2 результат при одинаковом бюджете: pooled 100/512 → 374/512 (+53,5 п.п.); sealed OOD-поверхность 45/256 → 118/256 (+28,5 п.п.; 95% CI [+21,9; +35,2]); в 3 072 tamper-проверках не зафиксировано tamper-событий. Граница: это малая dense-модель и собственный synthetic software gym, не клиентский benchmark или production-SLA. Отдельный кандидат поднял recovery 30/512 → 509/512, но уничтожил корректное воздержание 261/768 → 0/768 — фабрика отклонила обновление. Это показывает способность не только обучать, но и измеримо отказываться от опасного релиза.