Заказчик: производственно-логистический холдинг (3 производственные площадки, 8 складов, 52 400 позиций в справочнике «Номенклатура» 1С).
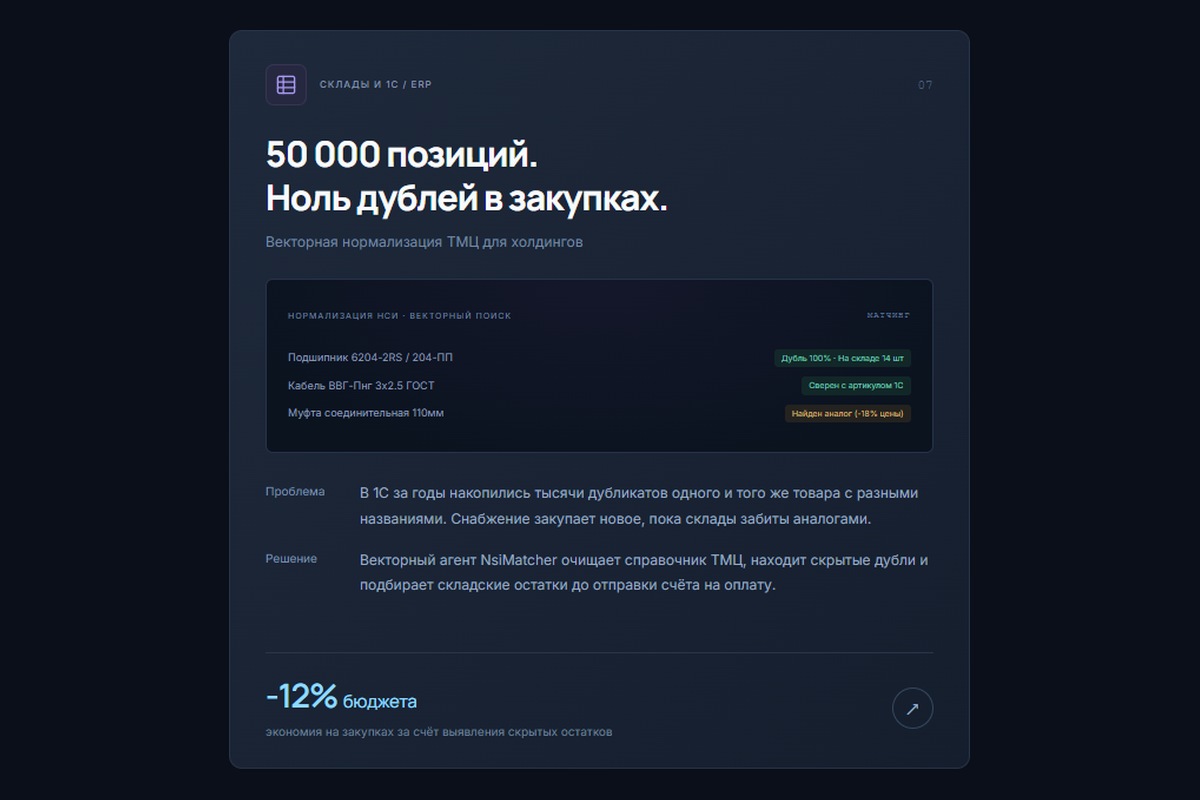
Проблема: за 12 лет одна и та же позиция заводилась под разными названиями, сокращениями и латиницей/кириллицей. Снабжение закупало новые партии подшипников и кабеля, пока аналоги годами лежали на соседнем складе. Ручная чистка провалилась (4000 строк за полгода).
За 9 рабочих дней разработан двухступенчатый движок семантического матчинга VmvCode NsiMatcher:
1. Нормализатор технических наименований (Python regex + NLP): стандартизация ГОСТ/DIN/ISO, единиц измерения и смешанных раскладок.
2. Векторные эмбеддинги BGE-M3 + база Qdrant + Cross-Encoder Reranker для точного поиска кандидатов за 15 мс.
3. Rule-Based Extractor числовых допусков: жёстко сверяет сечение, размер и напряжение, чтобы никогда не склеить разные типоразмеры (например, 3х2.5 и 3х4.0).
4. Расширение для 1С:ERP (REST API): при заведении новой карточки мгновенно показывает складские остатки аналогов и блокирует дубль.
• Вся база из 52 400 строк сгруппирована в кластеры за 45 минут — выявлено и ликвидировано 8 400 скрытых дублей (-16%).
• Время заведения новой позиции сократилось с 20–25 минут до 10 секунд.
• Доля оборачиваемых складских остатков выросла с 62% до 88%.
• Экономия бюджета закупок: -12.4% (6 850 000 ₽ за первый квартал).
Команда VmvCode: архитектура (Максим Васильев), NLP/эмбеддинги BGE-M3 + Qdrant, интеграция 1С:ERP.