Telegram-боты, парсеры и автоматизация под ключ
- Опыт работы
- 12 лет
- На сайте с
- 2026 года
- Юридический статус
- Самозанятый
Создать локальный инструмент для объективного сравнения ИИ-агентов, работающих с кодом, на задачах конкретного репозитория.
Публичные рейтинги не учитывают структуру проекта, принятые правила, тесты и технологический стек. Требовалось дать нескольким агентам одинаковые условия и получить результат, который можно проверить и сопоставить.
Разработан AgentRace — CLI-инструмент с открытым исходным кодом.
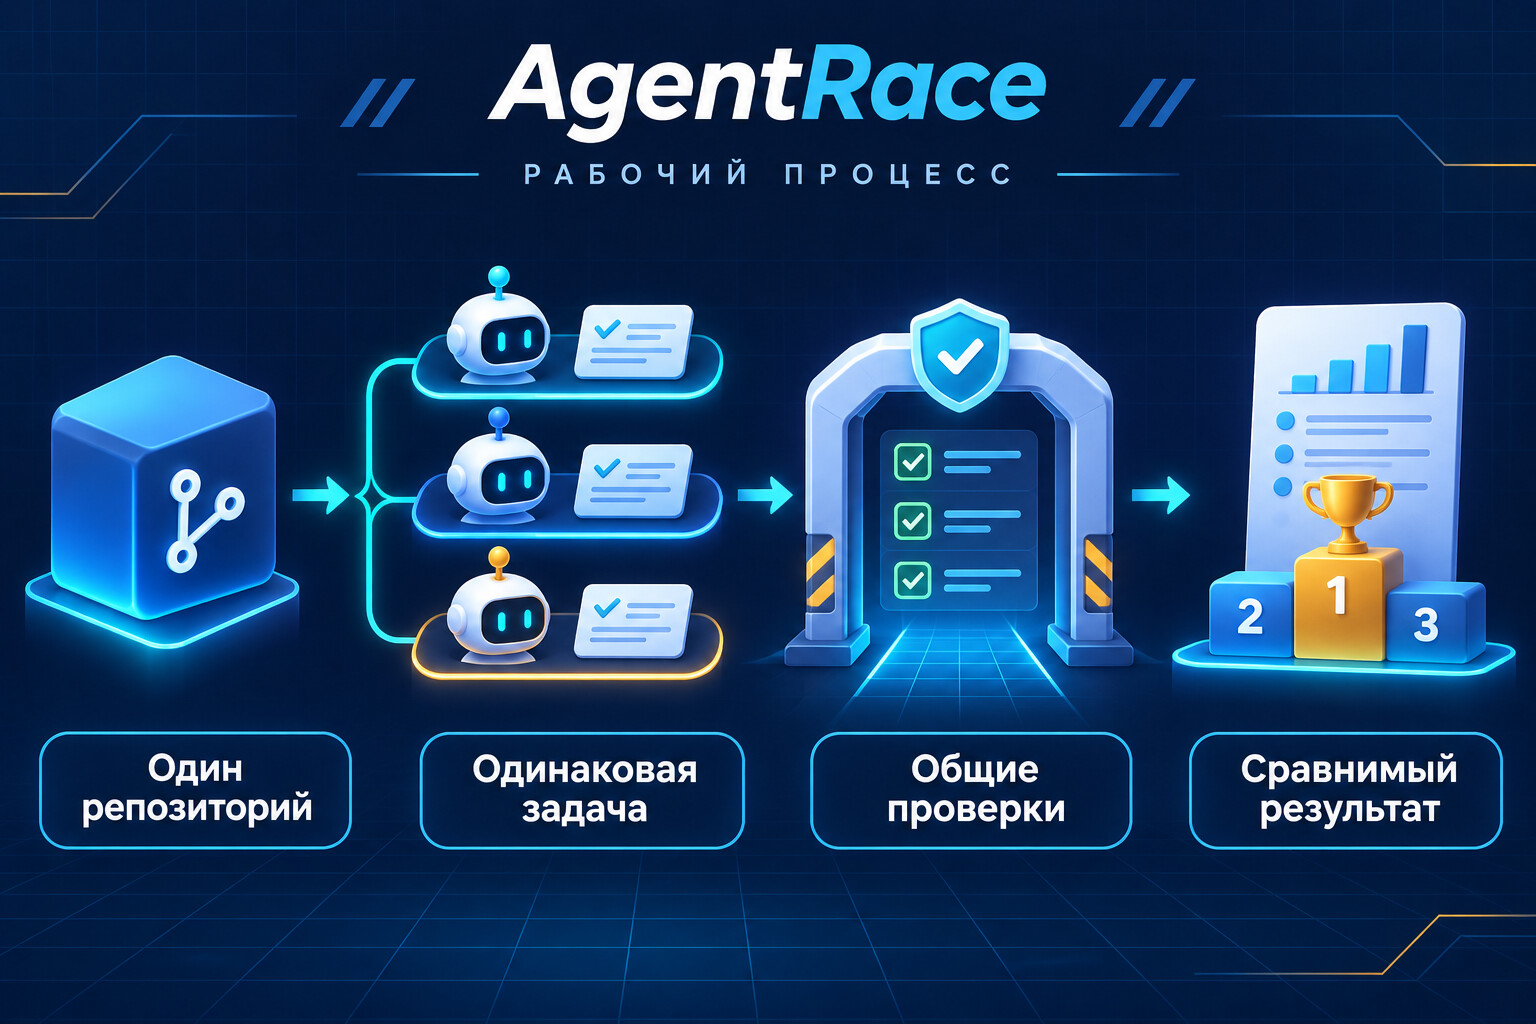
Пользователь задаёт одну задачу и набор проверок. Система запускает поддерживаемых ИИ-агентов в независимых копиях репозитория, сохраняет одинаковые исходные условия и применяет к результатам единый набор проверок.
По итогам формируется локальный отчёт, в котором можно сравнить успешность выполнения, прохождение проверок, время работы и объём изменений.
Реализованы:
— проверка доступности подключённых агентов;
— параллельный запуск в изолированных рабочих копиях;
— одинаковые задания и правила для всех участников;
— пользовательские команды проверки;
— прозрачная система оценки без дополнительного ИИ-судьи;
— демонстрационный режим;
— формирование самостоятельного HTML-отчёта;
— локальное хранение результатов без обязательной регистрации.
Проект поддерживает Claude Code, Codex CLI и Gemini CLI. Технические детали в портфолио не раскрываются; исходный код доступен в публичном репозитории.
Создана рабочая alpha-версия инструмента, опубликованная в открытом доступе под лицензией MIT.
AgentRace позволяет проверять ИИ-агентов на реальных задачах конкретного проекта и сравнивать их по единым правилам, а не опираться только на общие рейтинги и субъективные впечатления.
Инструмент можно запустить локально без регистрации. Результаты остаются на компьютере пользователя и оформляются в отдельный отчёт.