Excel/CSV: очистка данных, Python, документы Word/PDF
- На сайте с
- 2026 года
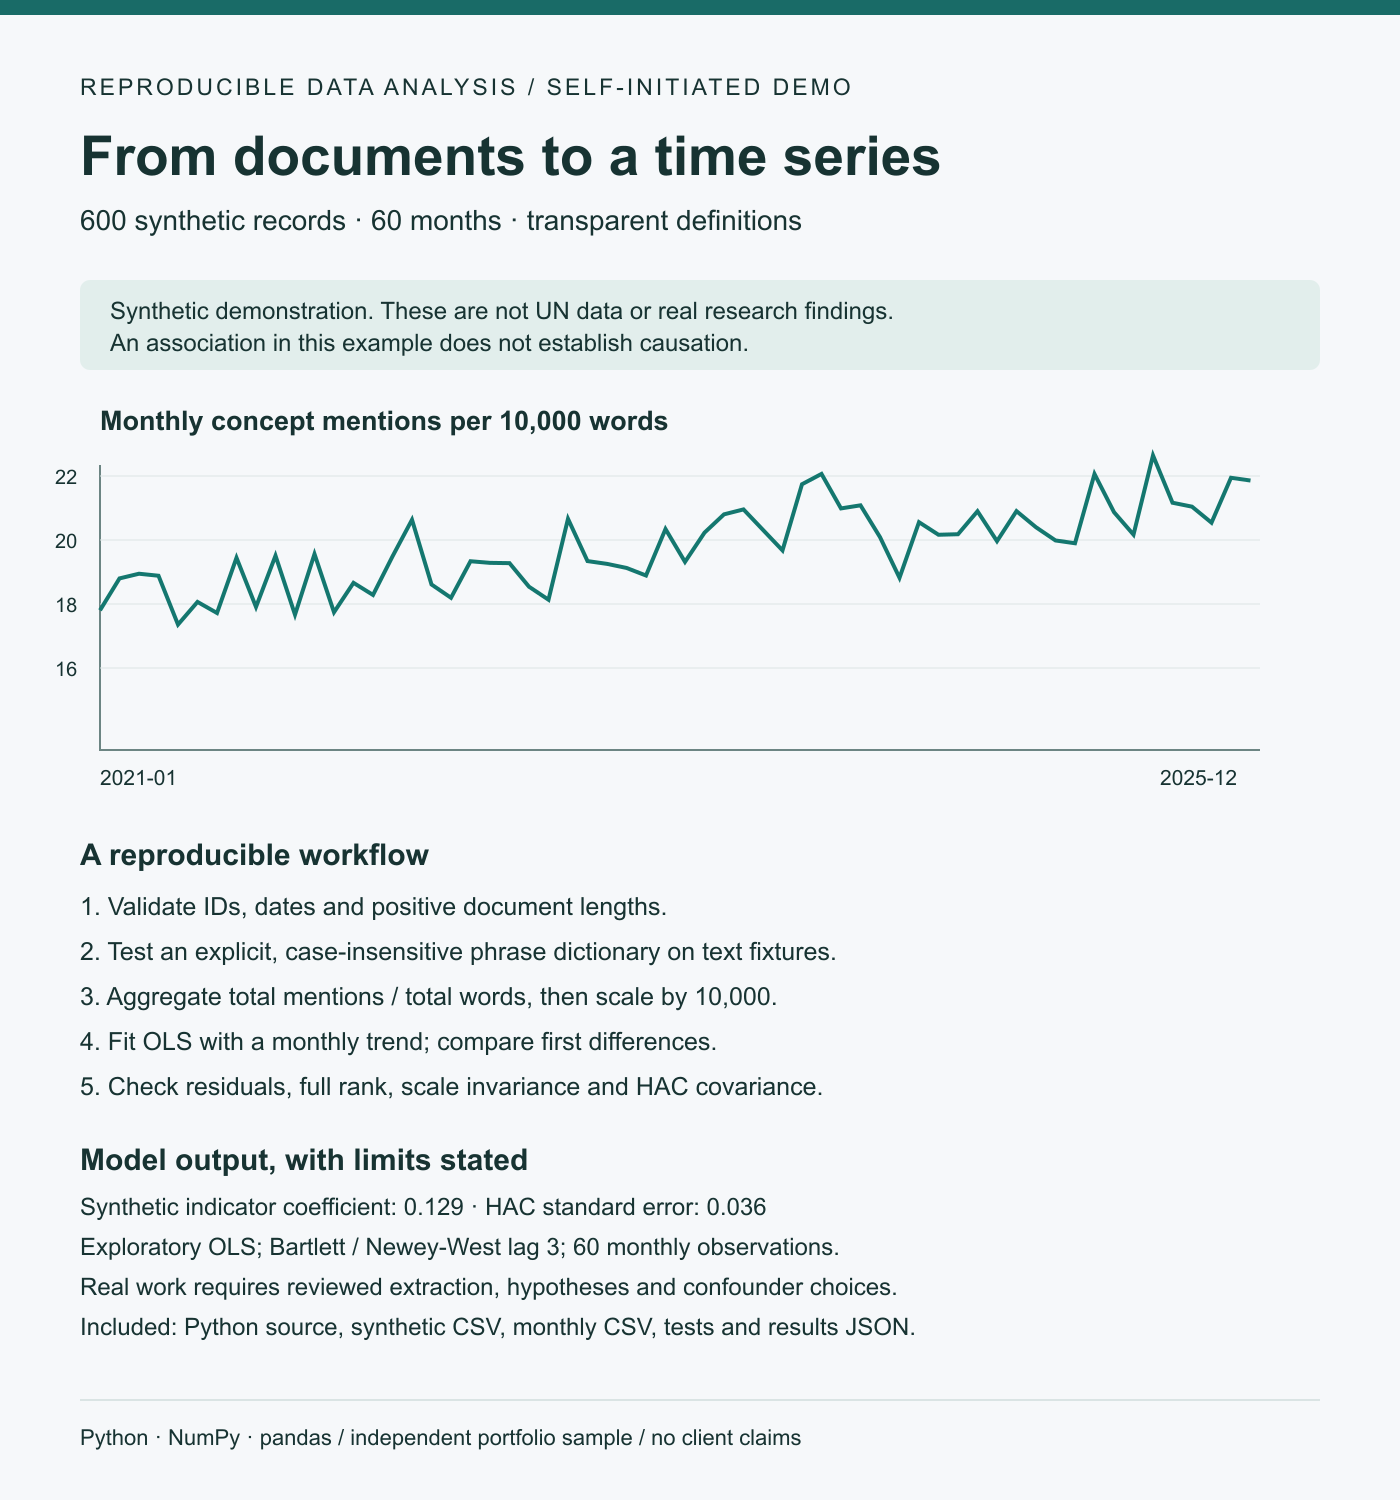
Личный учебный проект на синтетических данных, не работа для клиента и не реальные исследовательские выводы. Задача — показать воспроизводимую обработку 600 записей документов и построение показателей за 60 месяцев.
Python, NumPy и pandas: проверка идентификаторов, дат и длины документов; тестирование словаря фраз на текстовых примерах; расчёт месячной частоты упоминаний на 10 000 слов; визуализация временного ряда и проверочные расчёты модели. В комплекте исходный Python-код, синтетический CSV, месячный CSV, тесты и JSON результатов.
Получен повторяемый учебный процесс с явными определениями метрик, проверками и ограничениями. Найденная связь в синтетическом примере не доказывает причинность. Это демонстрация обработки данных, а не обещание научных выводов для неизвестного корпуса документов. Для реального проекта отдельно проверяются извлечение текста, качество источников и требования к анализу.