Telegram-боты, парсеры и автоматизация на Python
- Город
- Новосибирск
- Опыт работы
- 3 года
- На сайте с
- 2026 года
- Юридический статус
- Самозанятый
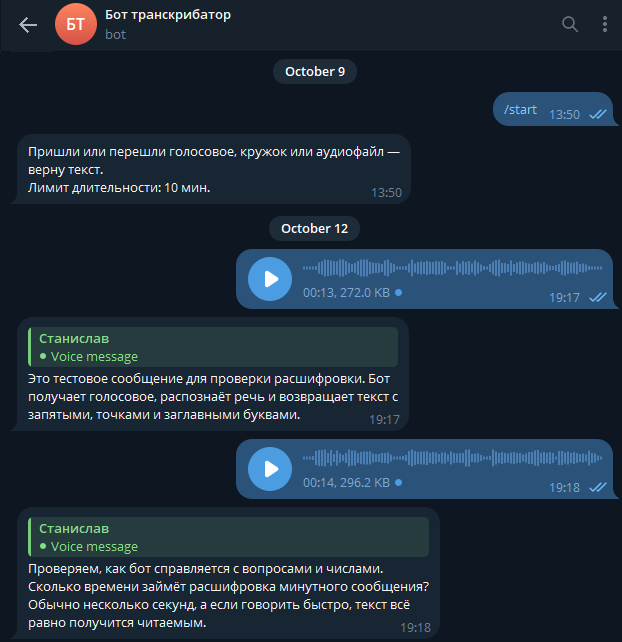
Голосовые неудобно слушать на совещании, в дороге или когда их пришло десять подряд. Облачные сервисы распознавания берут плату за минуты и отправляют записи на чужие серверы, а для рабочей переписки это не всегда допустимо. Нужен был бот, который переводит голосовые в текст полностью на своём сервере, причём самом дешёвом.
Бот на aiogram 3 с моделью GigaAM от Сбера, обученной на русской речи. Она сразу ставит пунктуацию. Длинная речь режется по паузам (Silero VAD), чтобы не упираться в память.
Принимает голосовые, кружки, аудио и видеофайлы до 20 МБ. Пока идёт распознавание, в сообщении обновляется «Распознаю… N%», а длинный текст делится на несколько сообщений.
Доступ только для разрешённых пользователей, задачи идут по очереди, память контейнера ограничена, чтобы бот не мешал другим сервисам на сервере.
Бот работает на сервере 1 vCPU / 1 ГБ RAM, без видеокарты и платных API, записи никуда не уходят. Запуск одной командой через Docker Compose, модель скачивается сама при первом старте.
Стек: Python, aiogram 3, GigaAM (ONNX), Silero VAD, Docker.