AI / Python: от бизнес-задачи до работающей production-системы
- На сайте с
- 2026 года
ЗАДАЧА
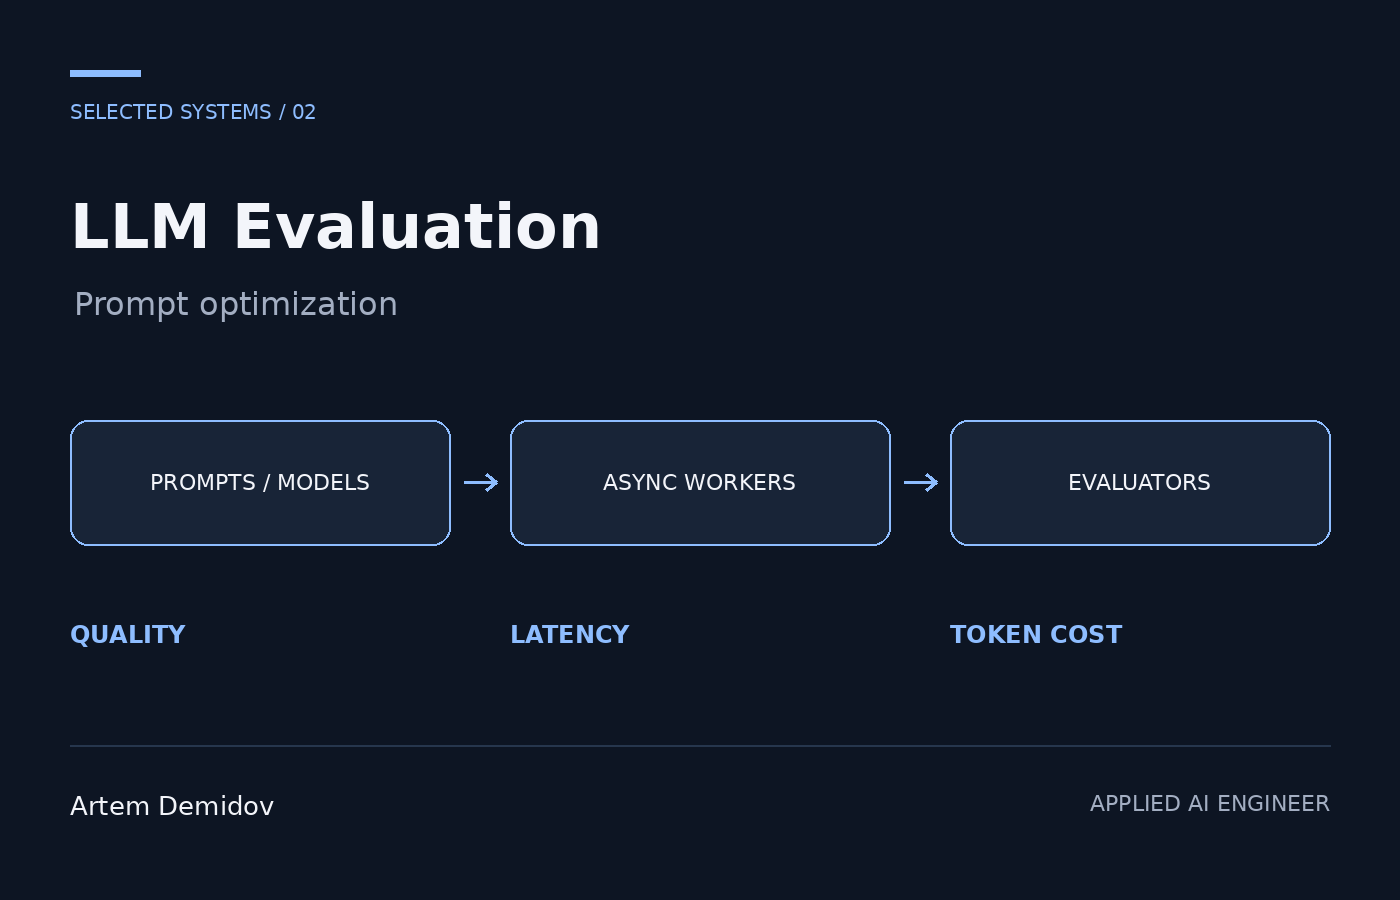
Изменения промптов и моделей трудно сравнивать объективно: различаются датасеты, оценщики, удалённые вычисления и бюджеты токенов. Нужна инфраструктура, которая превращает LLM-эксперименты в воспроизводимый инженерный процесс.
Проект: LLM Evaluation & Prompt Optimization Platform. Заказчик анонимизирован.
МОЙ ВКЛАД
Спроектировал контракты оценщиков, создание вычислительных задач, pipeline мутации промптов, воспроизводимые датасеты и workflows оптимизации.
РЕШЕНИЕ
• Асинхронные evaluation jobs и удалённые workers.
• Модульные оценщики качества и сравнение моделей.
• Prompt mutation и state-machine optimization.
• Воспроизводимые эксперименты и leaderboard datasets.
• Отслеживание качества, задержки и стоимости токенов в одном контуре.
ТЕХНОЛОГИИ
Python, LLM APIs, asynchronous workers, structured evaluation, experiment tracking, containerized compute.
РЕЗУЛЬТАТ
Создан единый воспроизводимый цикл сравнения качества, latency и token cost. Команда может проверять изменения на согласованных данных, выбирать промпты и модели по измеримым критериям и контролировать вычислительные затраты.
ПРАКТИЧЕСКАЯ ЦЕННОСТЬ
Инфраструктура поддерживает систематическую оптимизацию LLM-продукта и повторяемую проверку новых версий.
Мой вклад: архитектура оценивания, evaluator contracts, provisioning задач, prompt mutation и workflows оптимизации. Клиентские данные и личности участников анонимизированы.