- На сайте с
- 2022 года
- Юридический статус
- Частное лицо
Задача развернуть систему мониторинга для небольшого SaaS-проекта на 5 серверов.
Собрал стек на Docker Compose:
Node Exporter — собирает метрики с серверов (CPU, RAM, диск, сеть).
Prometheus — хранит метрики и опрашивает targets каждые 15 секунд.
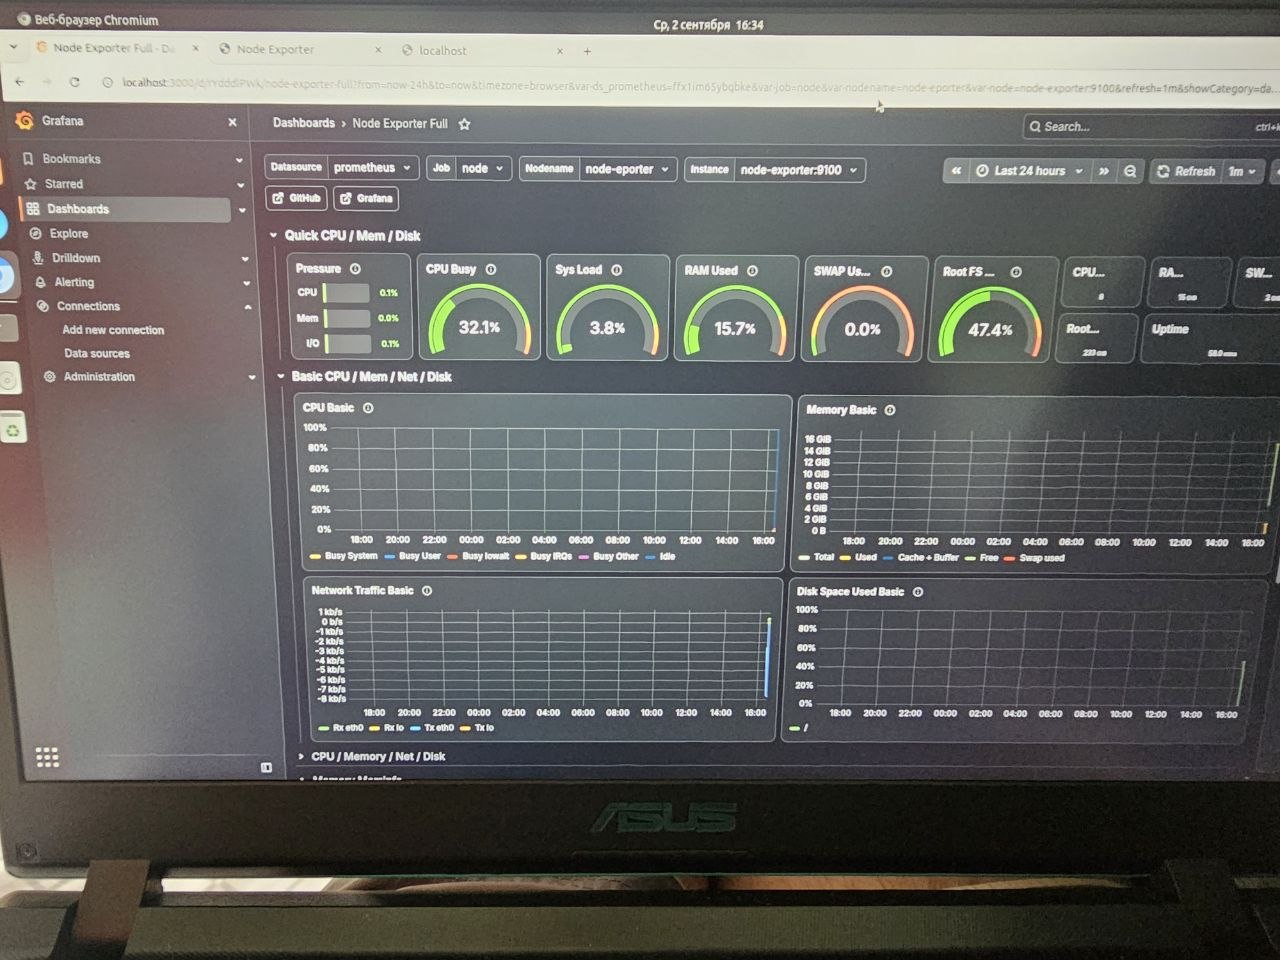
Grafana — визуализация: дашборды с графиками CPU, памяти, дисков и сети.
Alertmanager — отправляет оповещения в Telegram при срабатывании правил.
Настроил правила алертов:
CPU > 80% в течение 5 минут — уведомление.
RAM > 85% в течение 5 минут — уведомление.
Свободное место на диске < 10% — критическое уведомление.
Собрал дашборд с ключевыми метриками для быстрого взгляда на состояние инфраструктуры.
Настроил автоматический запуск через docker compose up -d и Makefile для удобного управления.
Клиент видит состояние всех серверов в одном дашборде.
Оповещения приходят в Telegram до того, как пользователи заметят проблему.
Время реакции на инциденты сократилось с нескольких часов до 5–10 минут.
Всё разворачивается одной командой — можно поднять на новом сервере за 5 минут.