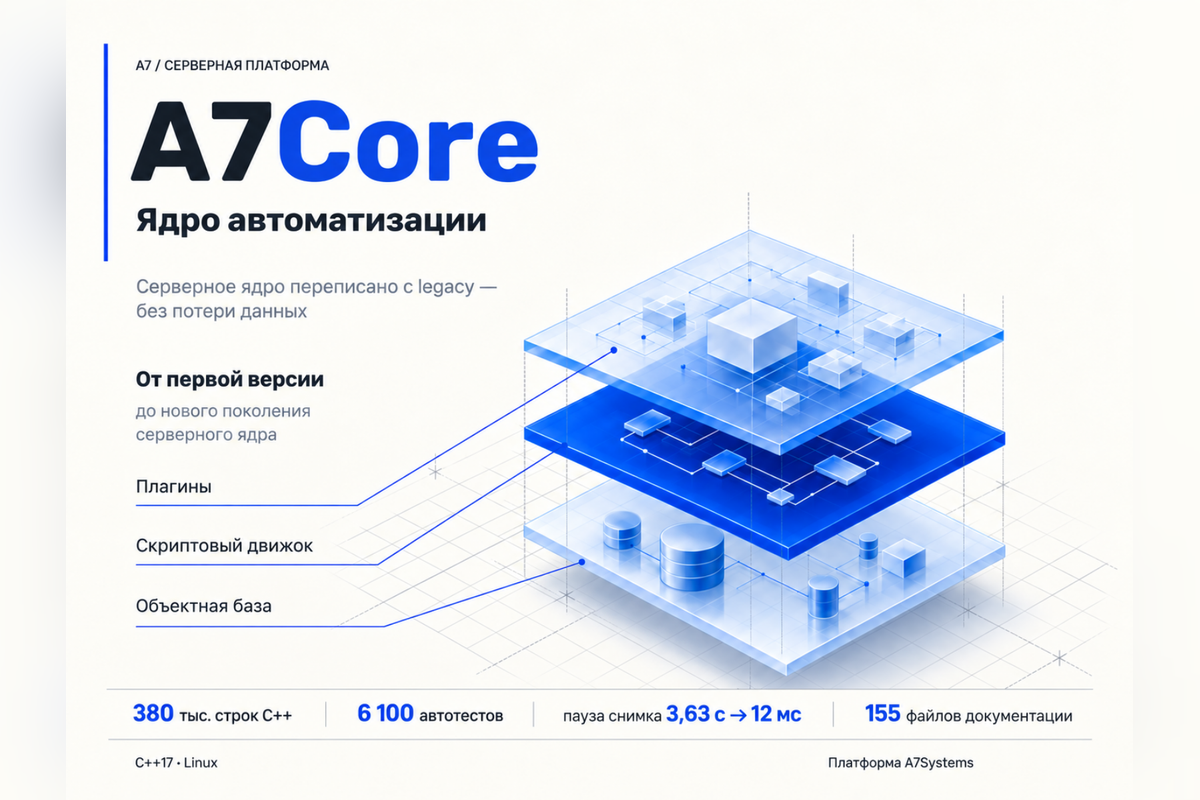
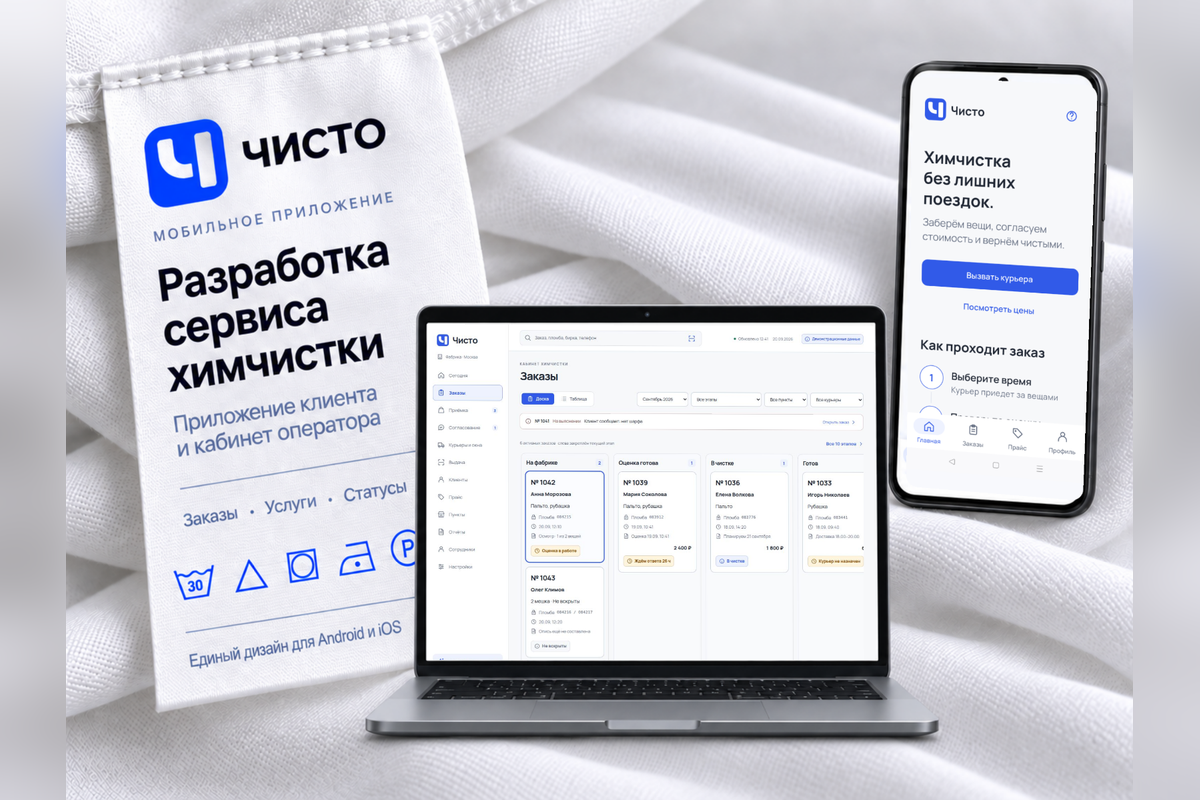
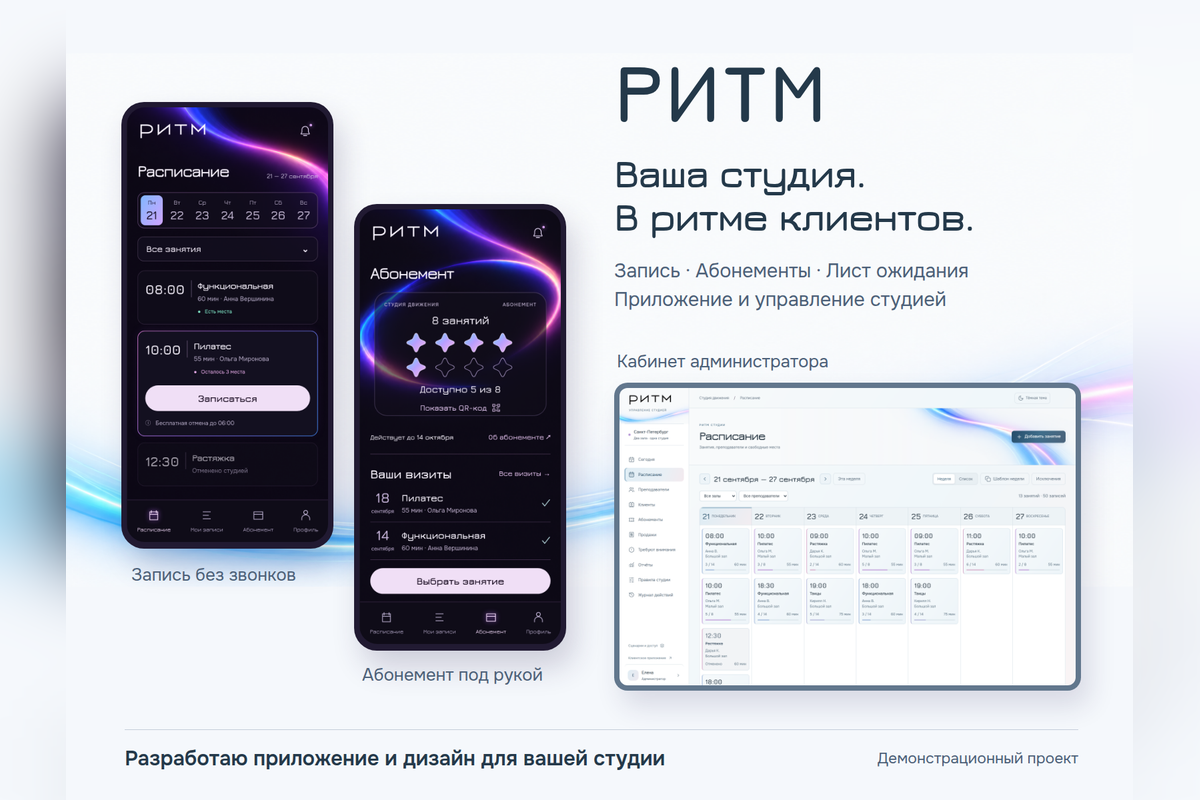
Приложения, боты, парсинг. 20 лет в IT
- Город
- Санкт-Петербург
- Опыт работы
- 21 год
- На сайте с
- 2026 года
- Юридический статус
- ИП
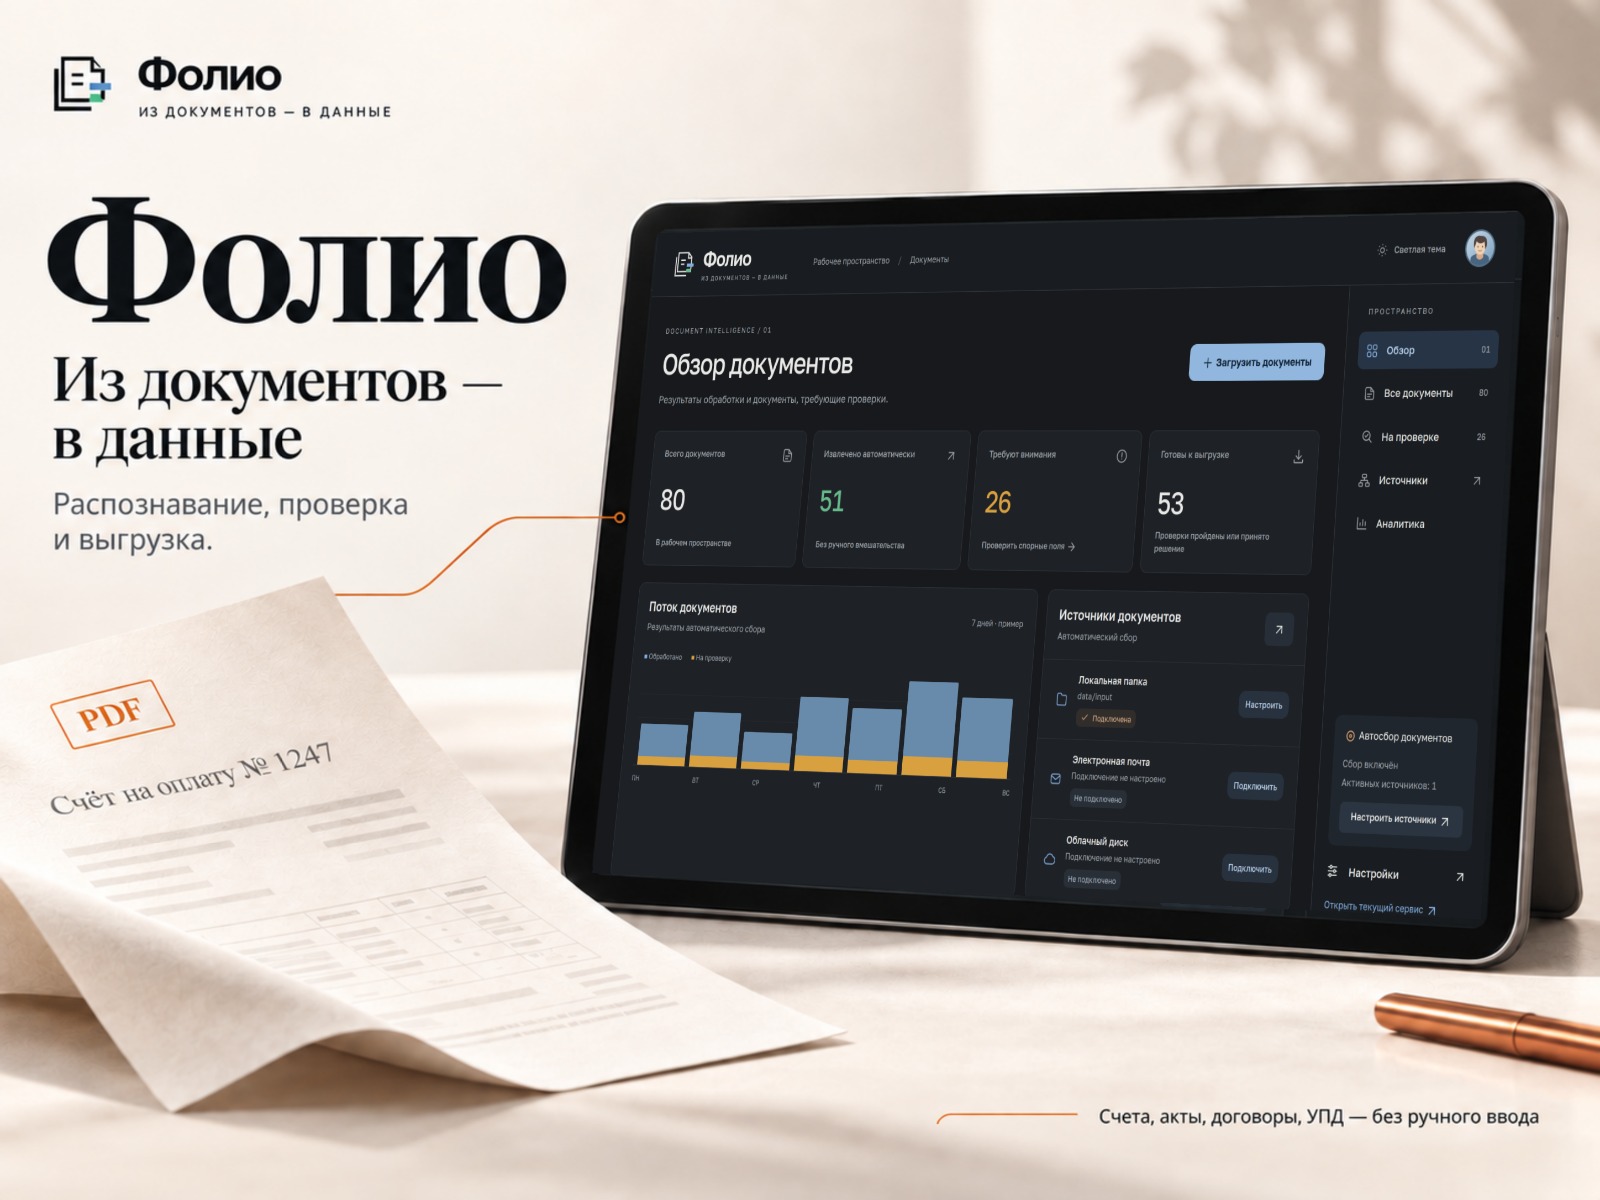
Конвейер обработки документов: из PDF, сканов и фотографий — в реестр с проверенными полями.
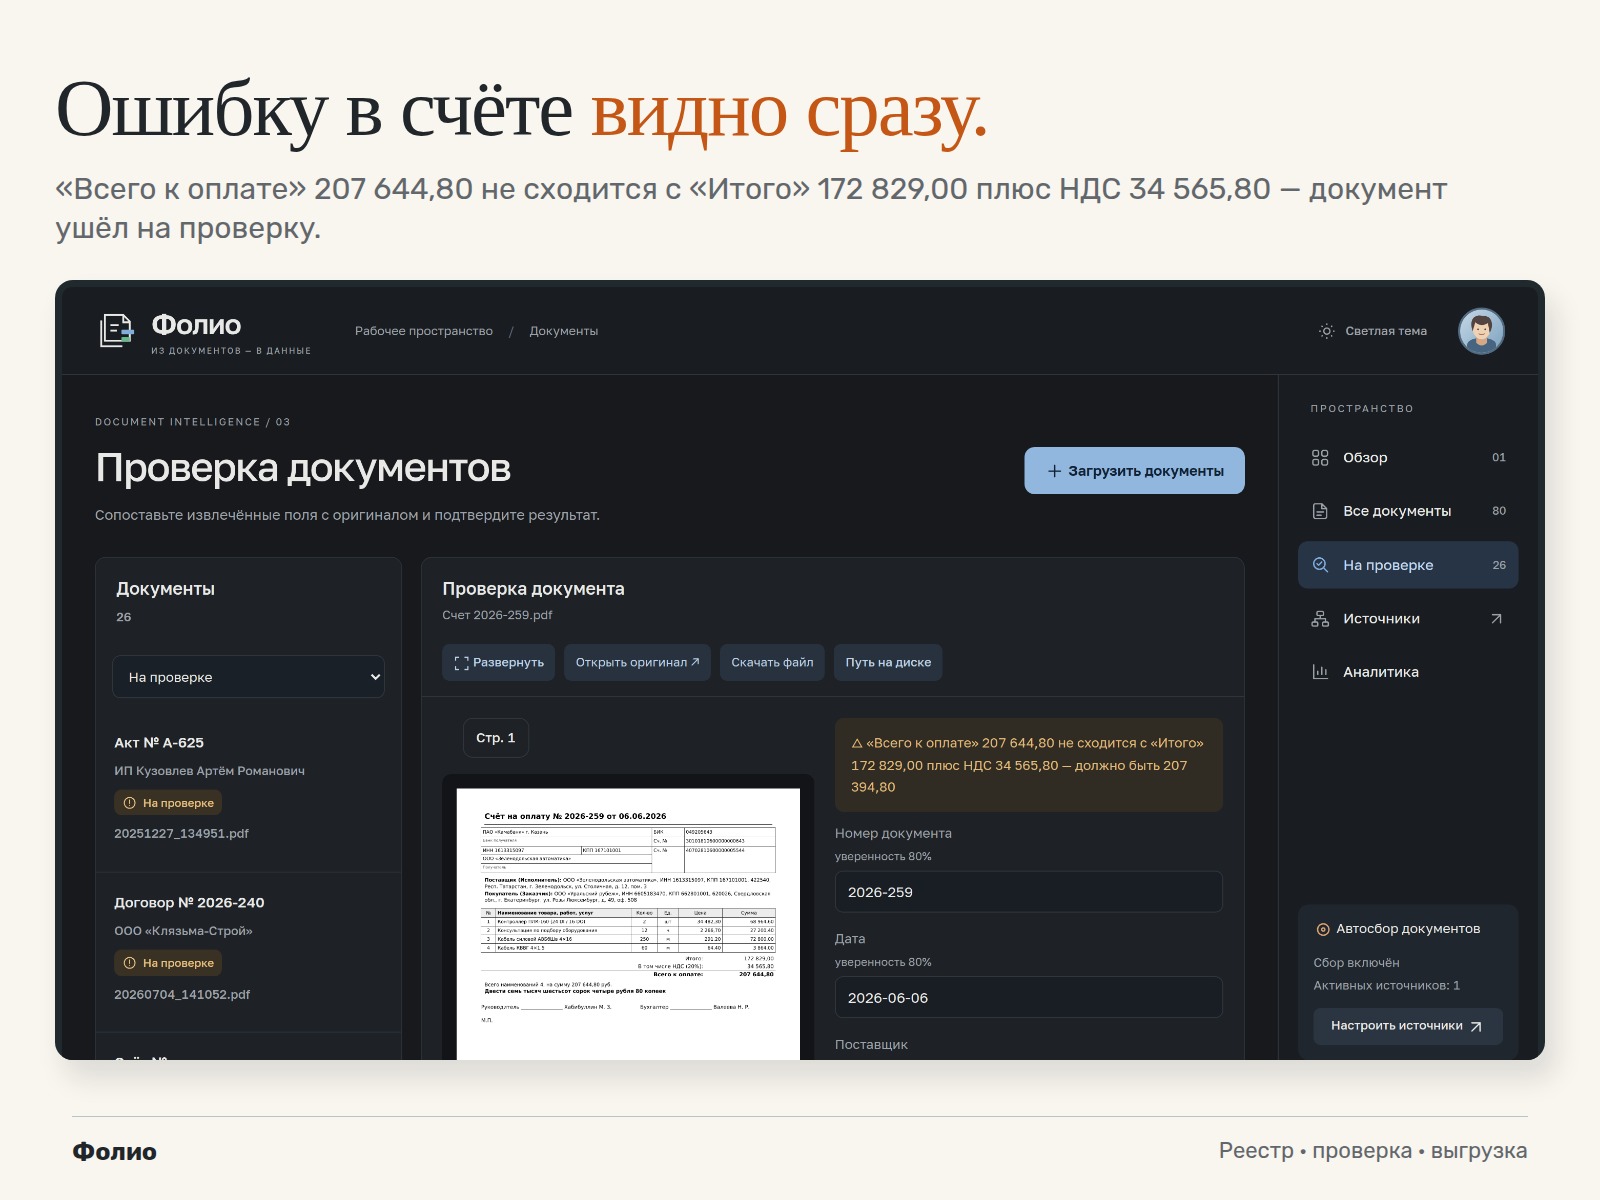
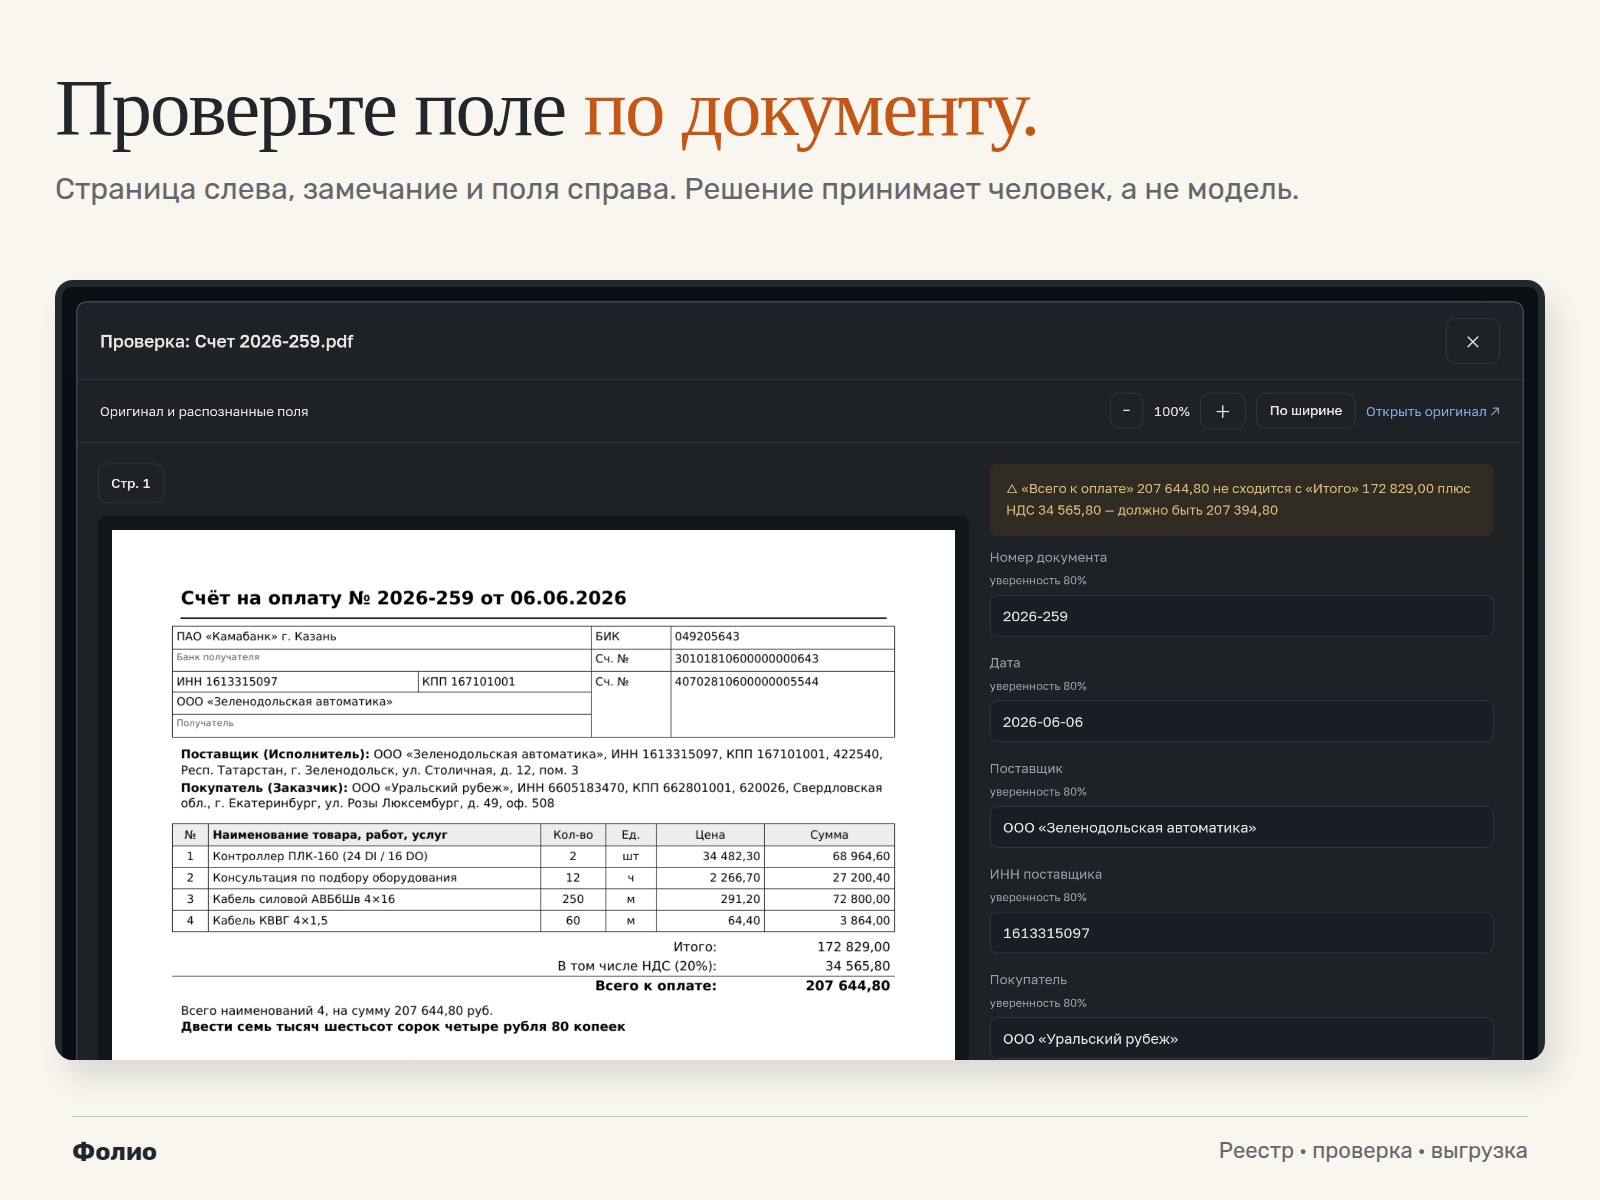
Задача: счета, акты и договоры перестают перебиваться руками, но ошибка распознавания не уезжает в учёт молча. Всё, в чём программа не уверена, должен увидеть человек — рядом с исходной страницей.
Данные демонстрационные: синтетические документы с вымышленными контрагентами.
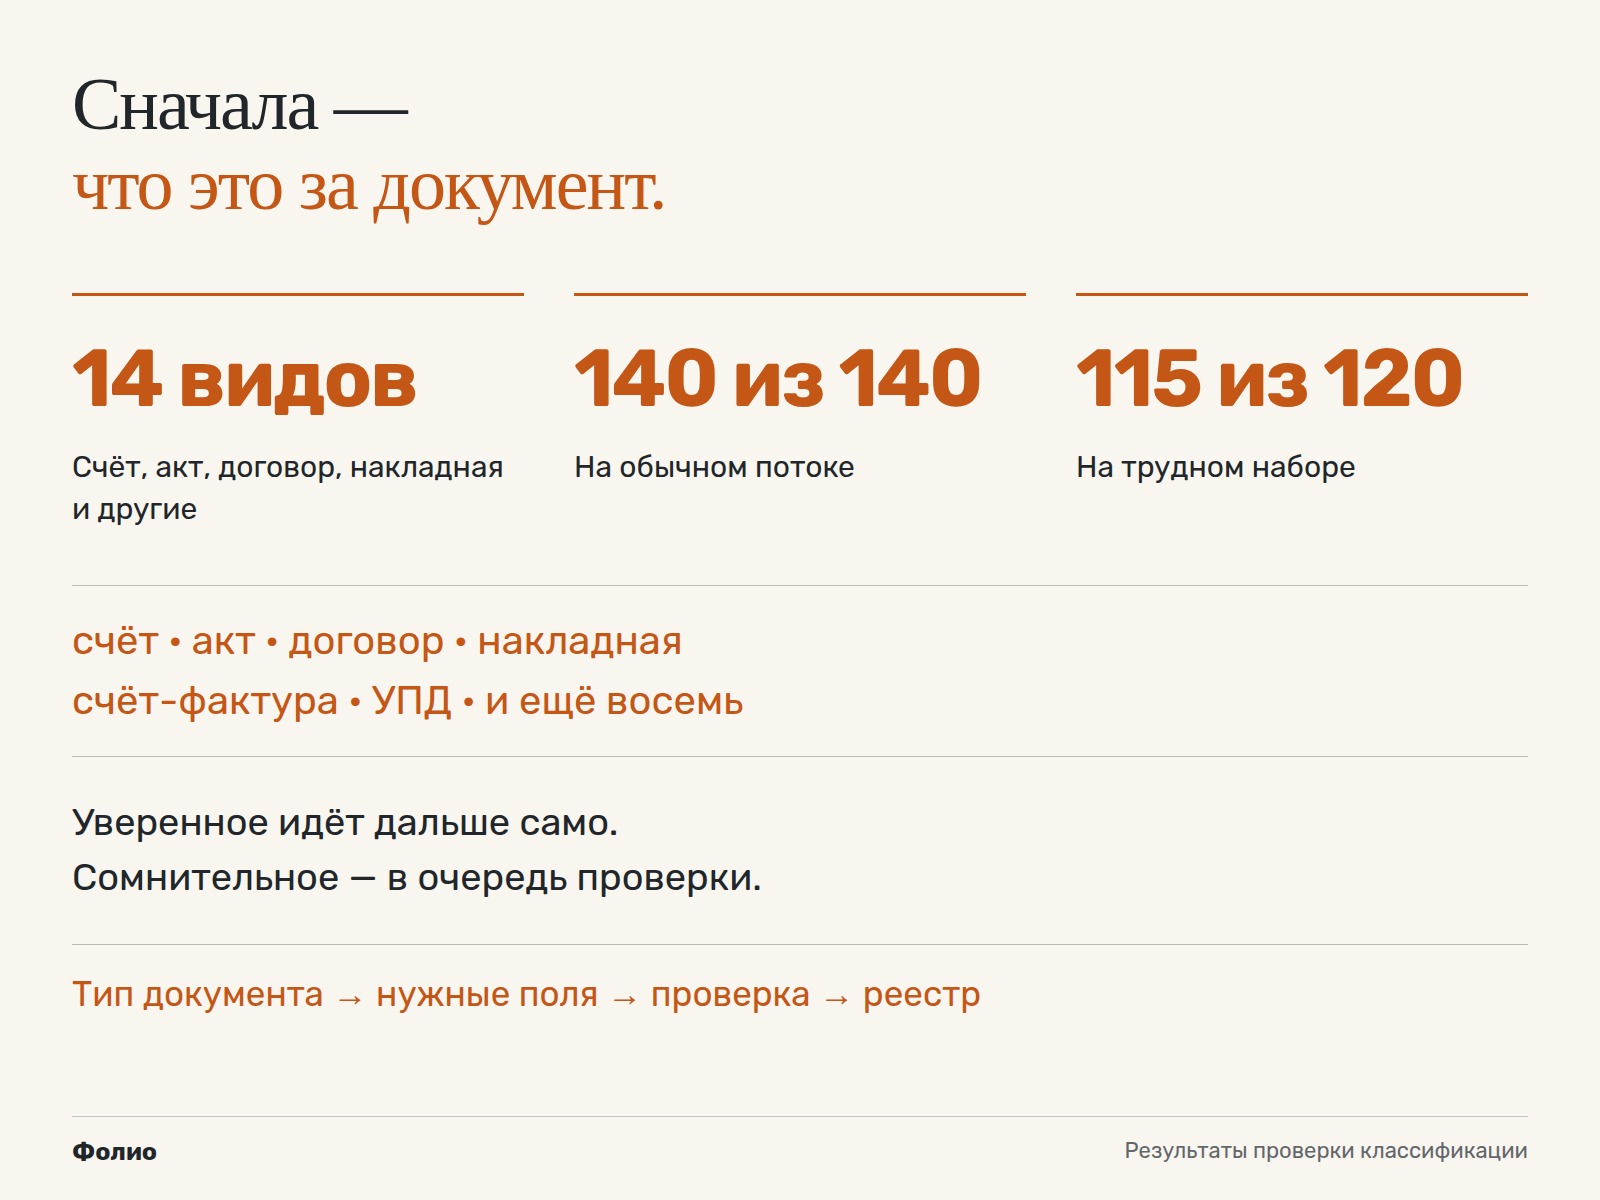
Сначала определяется вид документа — 14 видов: счёт, акт, договор, накладная, счёт-фактура, УПД и другие. Вместе с видом отдаётся уверенность: уверенное идёт дальше само, сомнительное попадает в очередь проверки с пометкой «вид определён неуверенно».
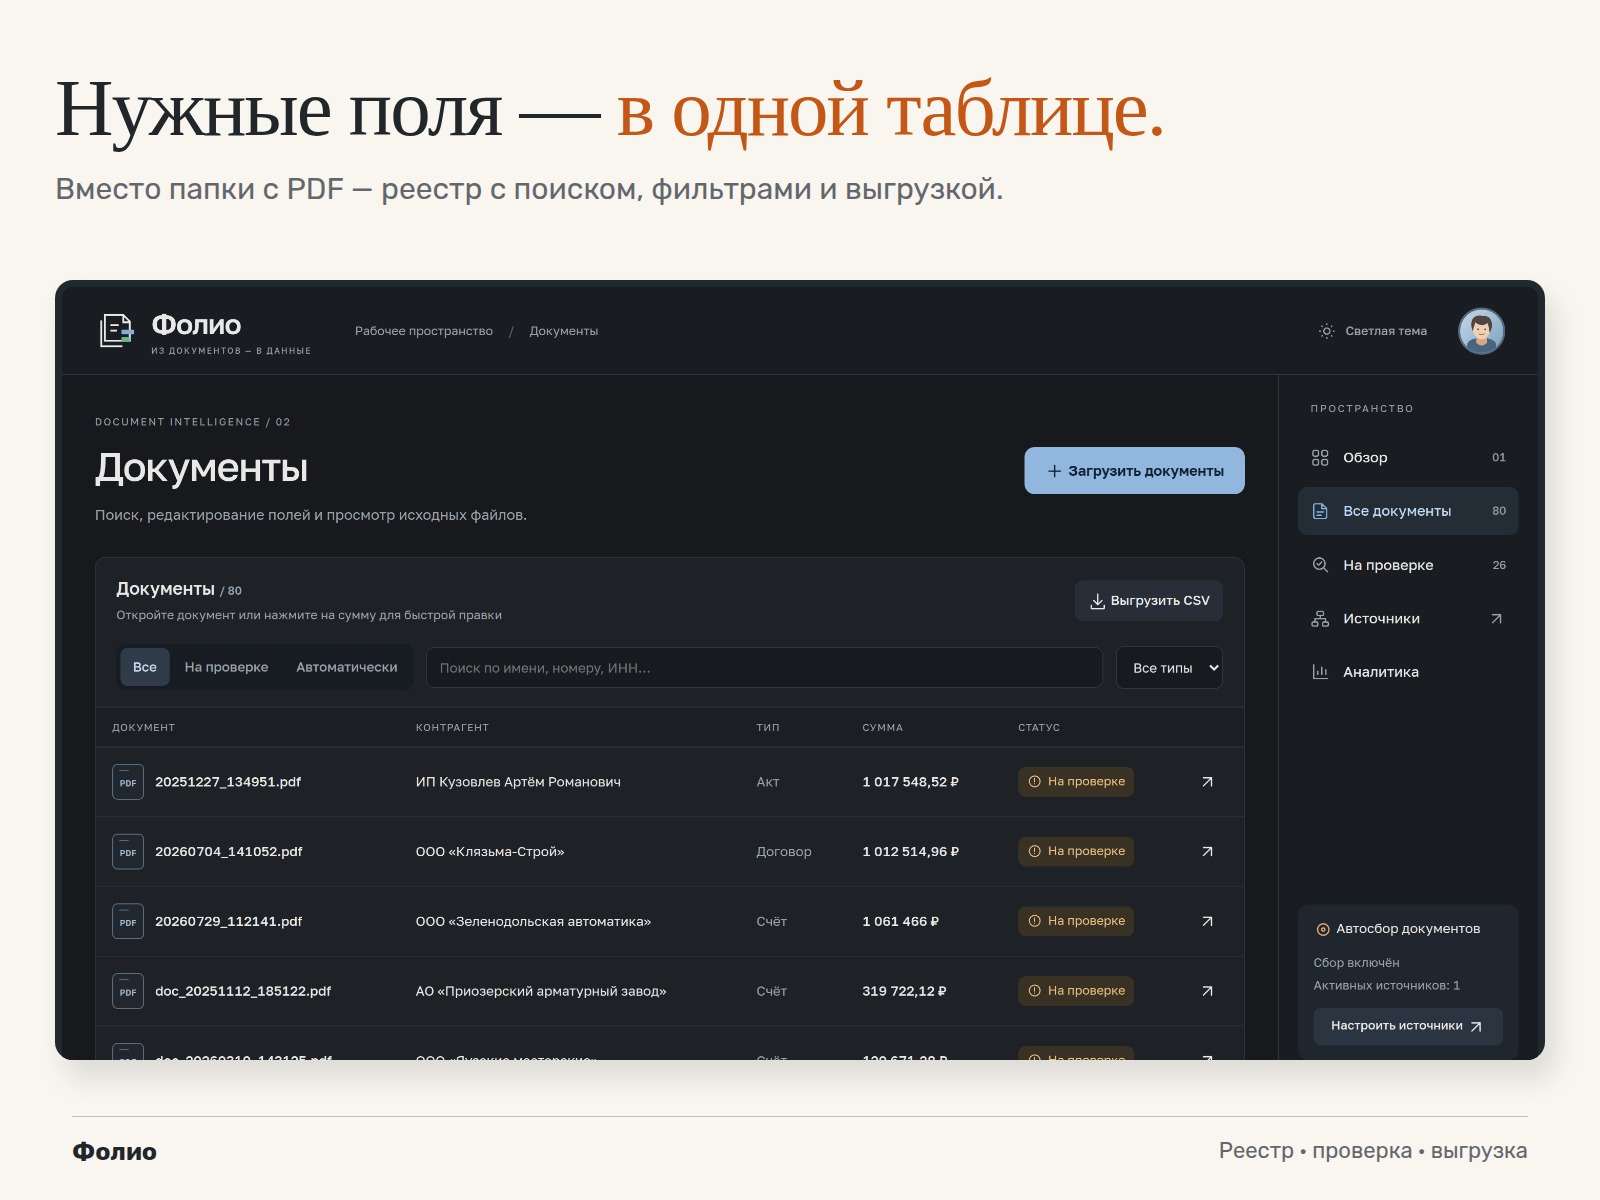
Дальше извлекаются поля, проверяются реквизиты и суммы, формируется реестр с выгрузкой в CSV. Значение от языковой модели принимается, только если оно найдено в тексте документа. Документы с замечаниями попадают в очередь проверки: исходная страница рядом с извлечёнными полями, замечание сформулировано словами, решение принимает человек. Если модель недоступна, работает запасной режим на правилах.
Стек: Python, FastAPI, OCR, языковая модель через API.
На потоке из 140 документов вид определён верно у всех, на трудном наборе из 120 — у 115. В тестовом прогоне по счетам, актам и договорам верно извлечены 807 из 820 полей — 98,4 %, а из 15 намеренно испорченных документов поймано 14. Сервис открыт по ссылке.
Собственная разработка: виды документов, состав полей и правила проверки настраиваются под бумаги заказчика; папки, почта и облако на входе, Excel или 1С на выходе подключаются под задачу. Сопровождаю, когда меняются форматы.
В оформлении обложки использованы изображения, созданные нейросетью; экраны на снимках — из самих проектов.