- Город
- Таганрог
- Опыт работы
- 6 лет
- На сайте с
- 2024 года
- Юридический статус
- Самозанятый
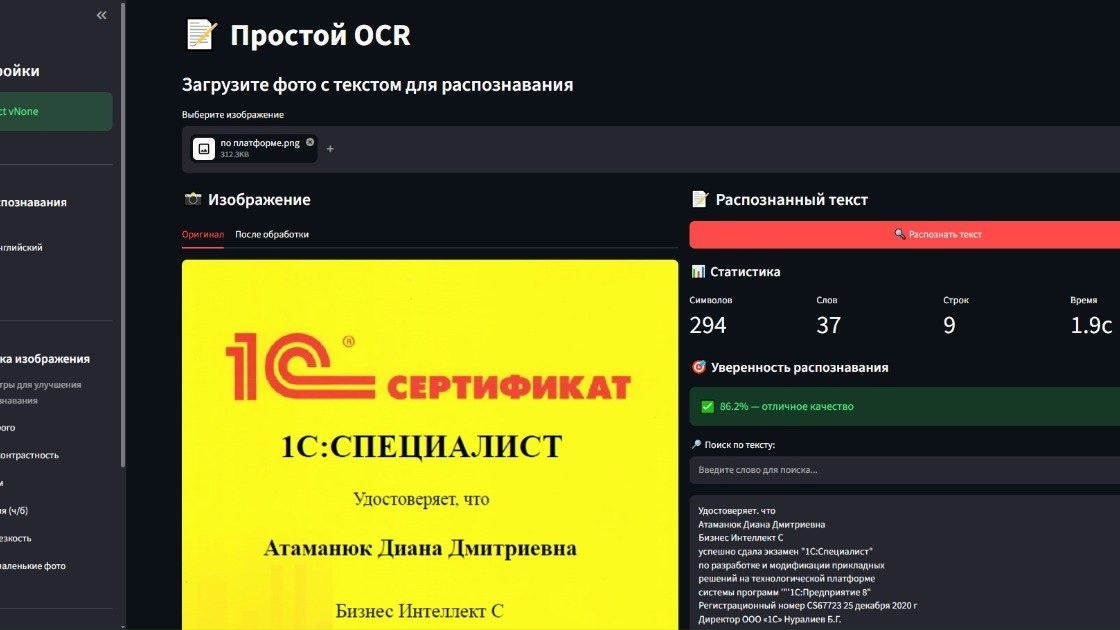
"Простой OCR" — десктопное приложение для распознавания текста на фото.
💡 Но есть нюанс: я сделала его БЕЗ нейросетей.
В мире, где все бегут за LLM и GPT, я решила вернуться к корням и показать, что классические алгоритмы Computer Vision всё ещё актуальны.
🔥 Что получилось:
✅ Tesseract OCR 5 — классический движок распознавания
✅ OpenCV — предобработка изображений (контраст, шум, бинаризация, резкость)
✅ Streamlit — веб-интерфейс
✅ pywebview — десктопная обёртка (настоящее окно, не браузер!)
✅ Regex — извлечение email, телефонов, URL, дат из текста
🎯 Почему это круто:
1️⃣ 100% локально — данные не покидают компьютер
2️⃣ Без API-ключей и подписок
3️⃣ Без интернета — работает оффлайн
4️⃣ Показывает знание классических алгоритмов, а не только нейросетей
💪 Что я прокачала:
• Работа с OpenCV (фильтры, бинаризация, морфология)
• Регулярные выражения для извлечения структурированных данных
• Упаковка Python-приложения в десктопное окно через pywebview
• Сборка в .exe через PyInstaller
• Prompt engineering... шучу, тут промптов нет 😄 Зато есть PSM-режимы Tesseract
🛠️ Стек:
Python 3.10+ • Tesseract OCR • OpenCV • Streamlit • pywebview • PyInstaller
🔗 Код на GitHub: github.com/1CRazrabot...
#Python #OpenCV #Tesseract #ComputerVision #Streamlit #OCR #PetProject #Portfolio #NoNeuralNetworks