- Город
- Минск
- Опыт работы
- 10 месяцев
- На сайте с
- 2019 года
- Юридический статус
- Частное лицо
Клиенту нужно было автоматизировать извлечение данных из PDF-документов фиксированного формата и собирать результат в структурированный Excel-файл. Ручной перенос данных из закупочных документов занимал много времени и был неудобен при большом количестве файлов.
Цель проекта состояла в том, чтобы автоматически считывать данные из набора PDF-документов, выделять как общую информацию по заказу, так и товарные позиции, а затем формировать единый Excel-отчёт с дополнительной аналитикой и проверкой данных.
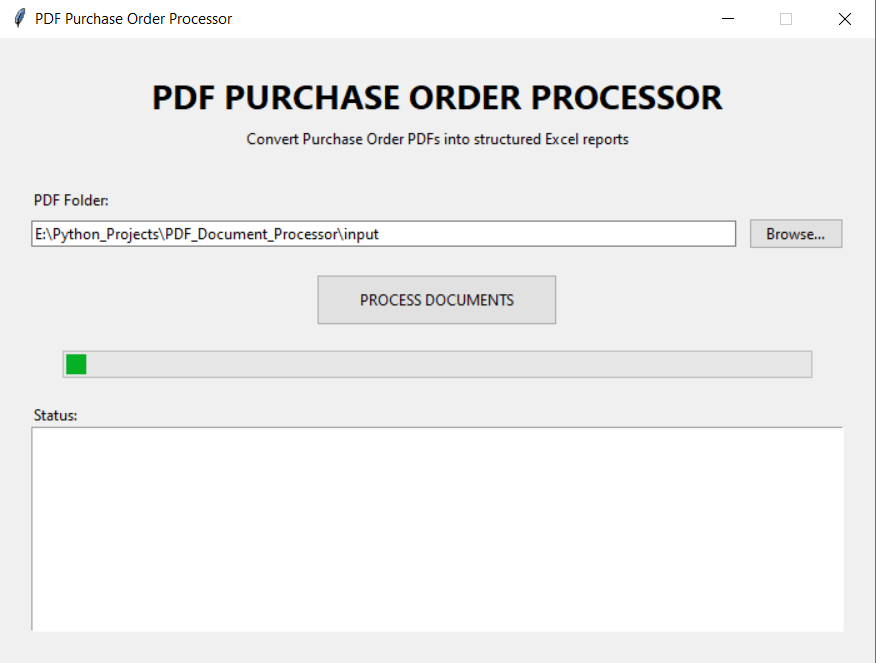
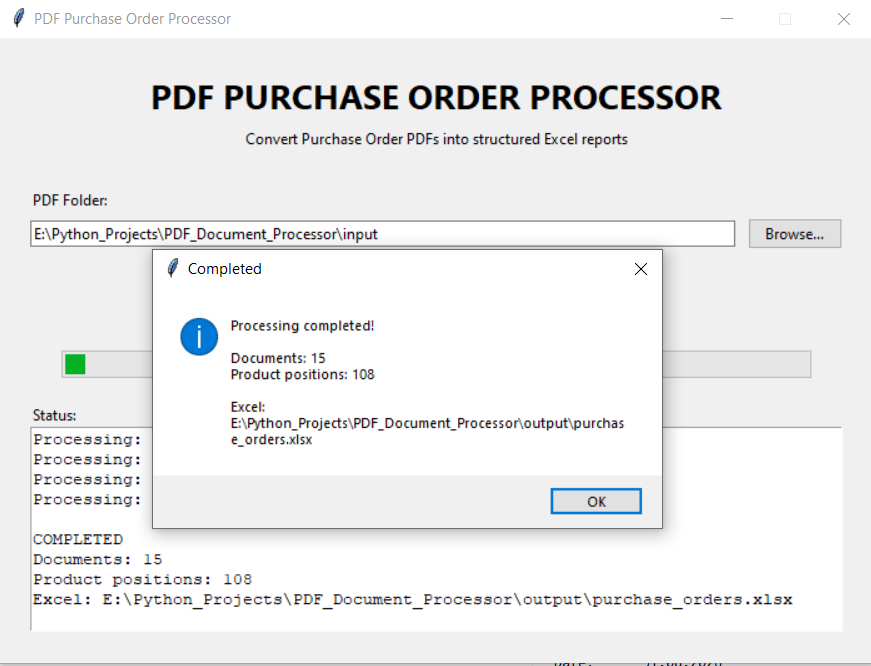
Разработал приложение на Python с графическим интерфейсом, которое:
- обрабатывает папку с PDF-документами;
- извлекает данные по заказам и позициям;
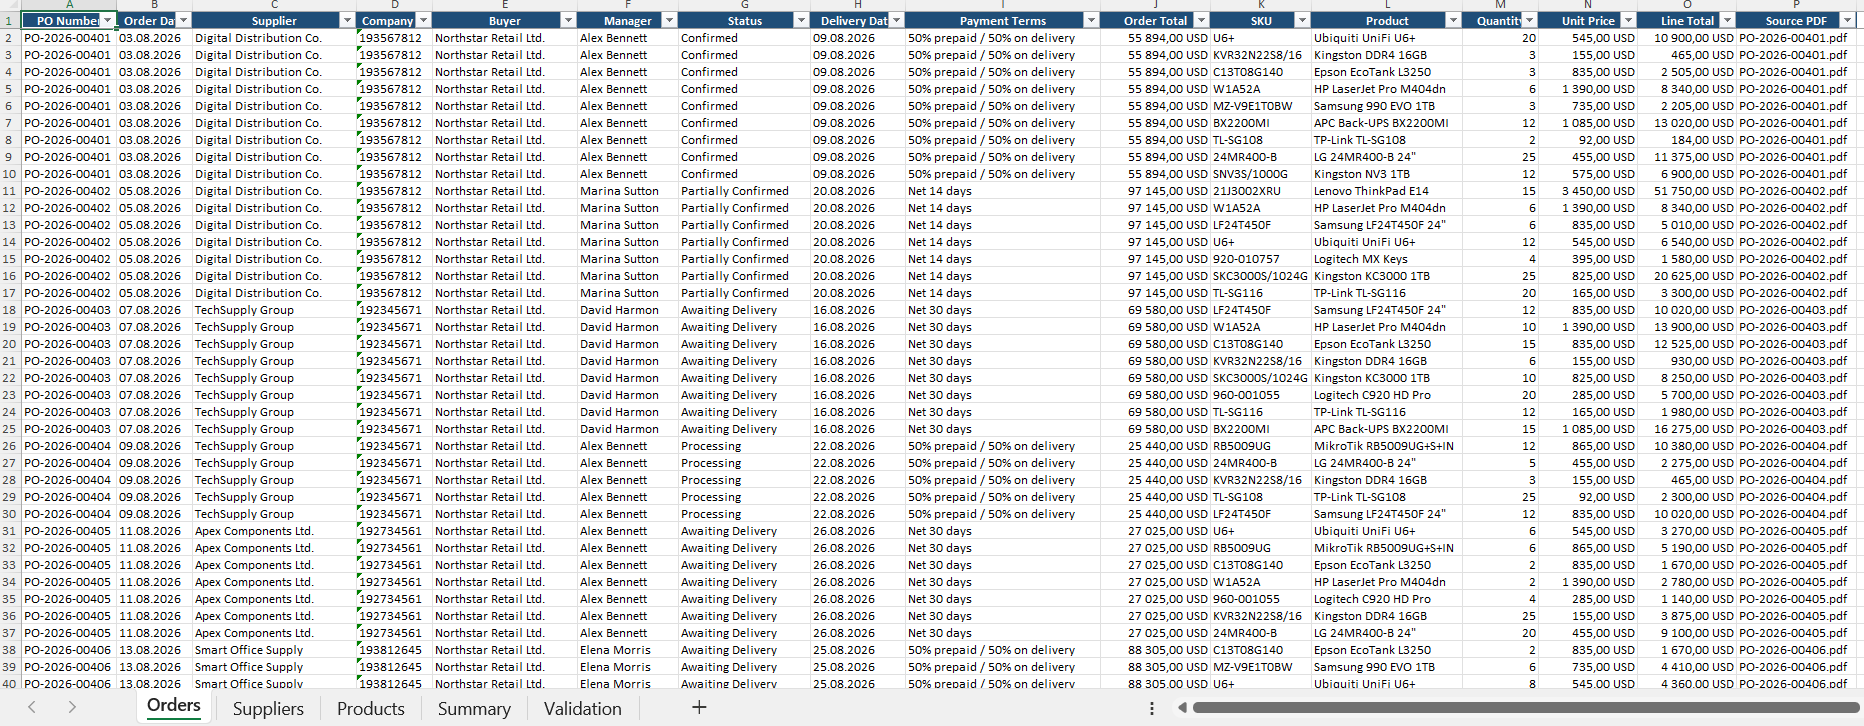
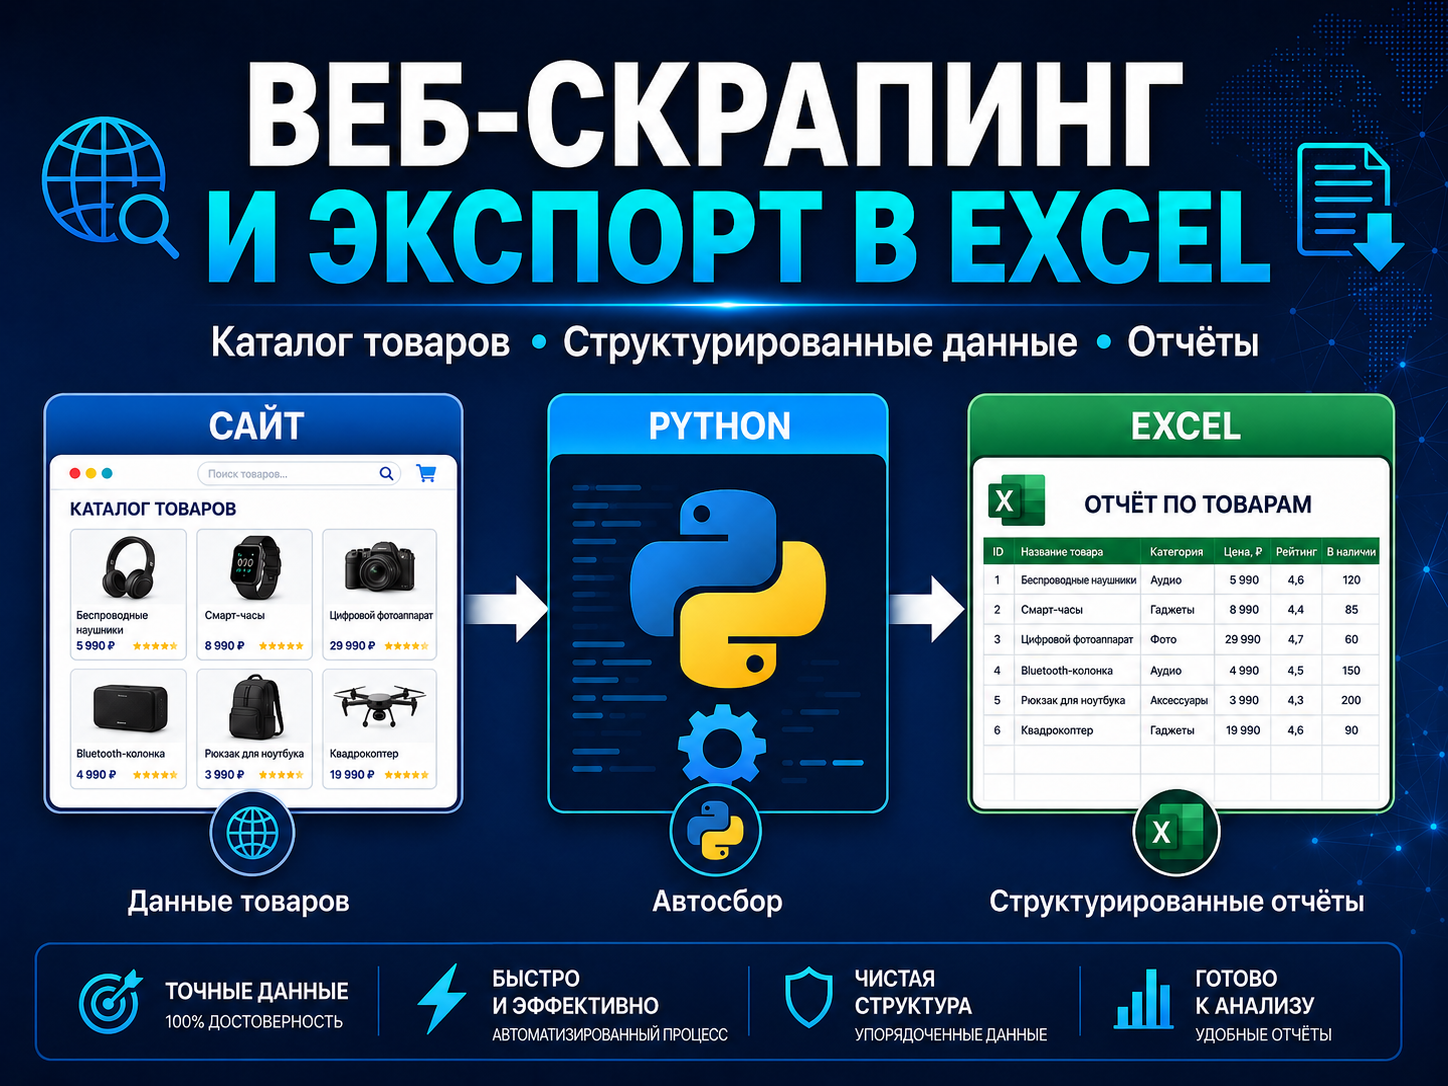
- собирает их в структурированную таблицу;
- формирует Excel-файл с несколькими листами;
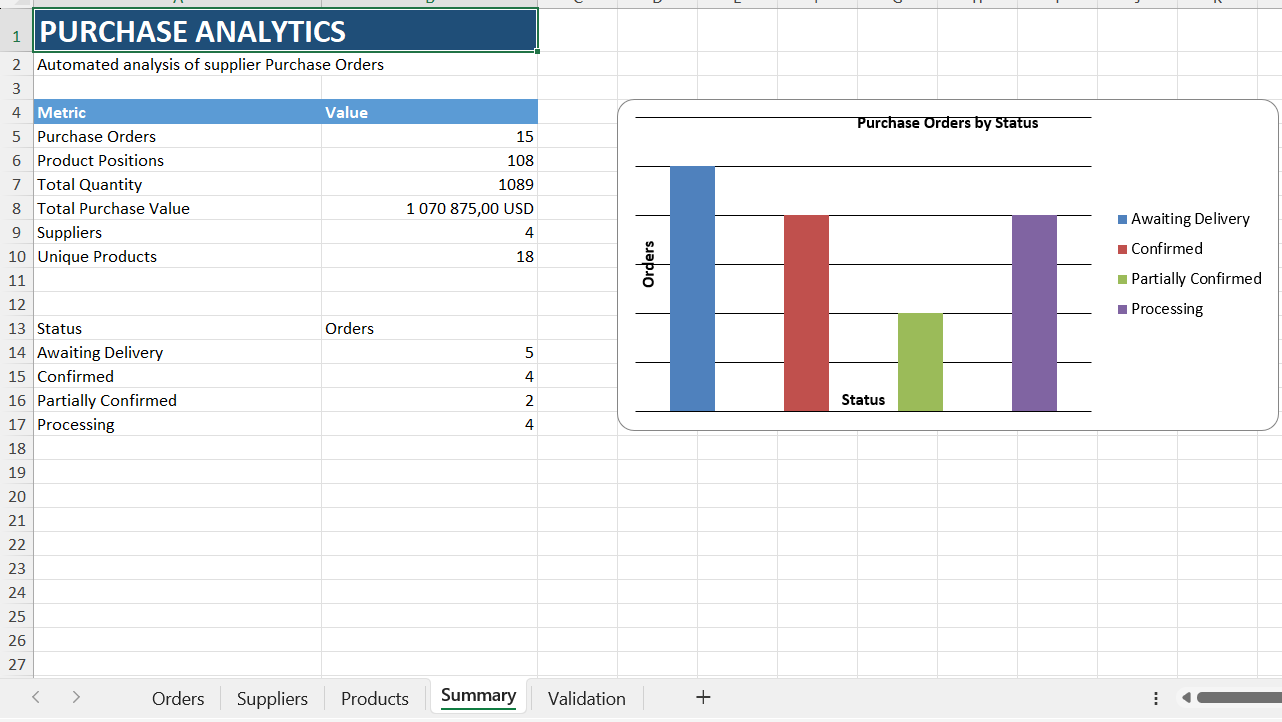
- добавляет сводные данные по поставщикам и товарам;
- создаёт summary-страницу;
- выполняет валидацию итоговых сумм.
На выходе получается не просто таблица, а полноценный Excel-отчёт, где можно быстро увидеть детали заказов, агрегированные данные и результаты проверки.
В результате получился практический инструмент для автоматизации обработки PDF-документов. Он уменьшает количество ручной работы, ускоряет перенос данных в Excel и помогает быстрее анализировать закупочные документы.
Такое решение особенно удобно для задач документооборота, закупок, работы с заказами и внутренней отчётности, где важно быстро превращать PDF в структурированные данные.