- Город
- Минск
- Опыт работы
- 10 месяцев
- На сайте с
- 2019 года
- Юридический статус
- Частное лицо
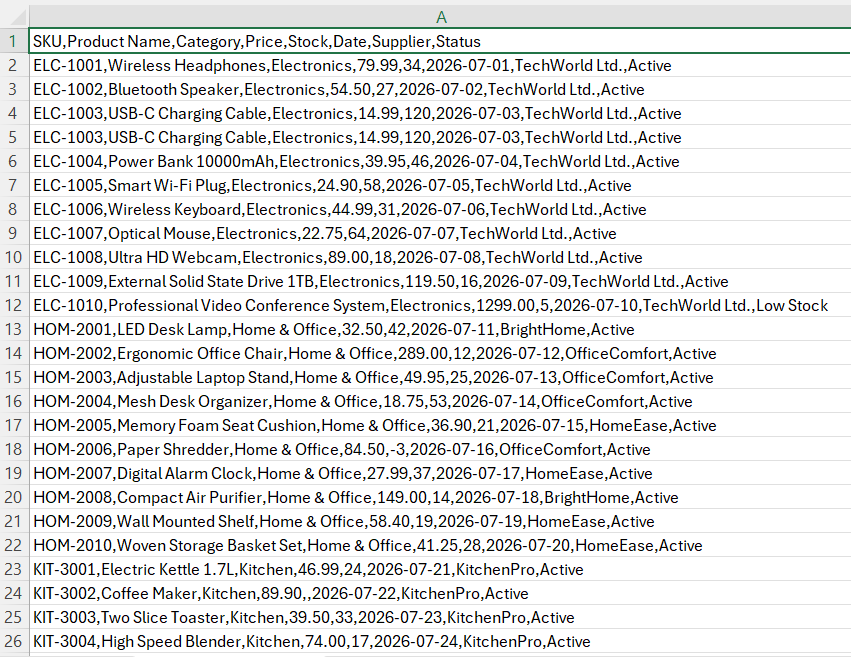
Клиенту нужно было автоматизировать обработку товарного каталога из CSV-файла. Исходные данные содержали дубликаты, пропуски, некорректные остатки, неоднородный формат цен и дат, из-за чего было неудобно использовать их для дальнейшей работы и анализа.
Задача состояла в том, чтобы превратить “сырой” CSV в аккуратный и понятный Excel-файл, где данные уже очищены, приведены к единому формату и готовы для использования. Дополнительно было важно добавить базовую валидацию, чтобы сразу видеть проблемные позиции и не проверять всё вручную.
Проект ориентирован на автоматизацию рутинной обработки данных и может применяться для интернет-магазинов, поставщиков, внутренних каталогов и других задач, связанных с Excel/CSV.
Разработал Python-скрипт, который автоматически:
- загружает исходный CSV-файл;
- очищает и нормализует текстовые поля;
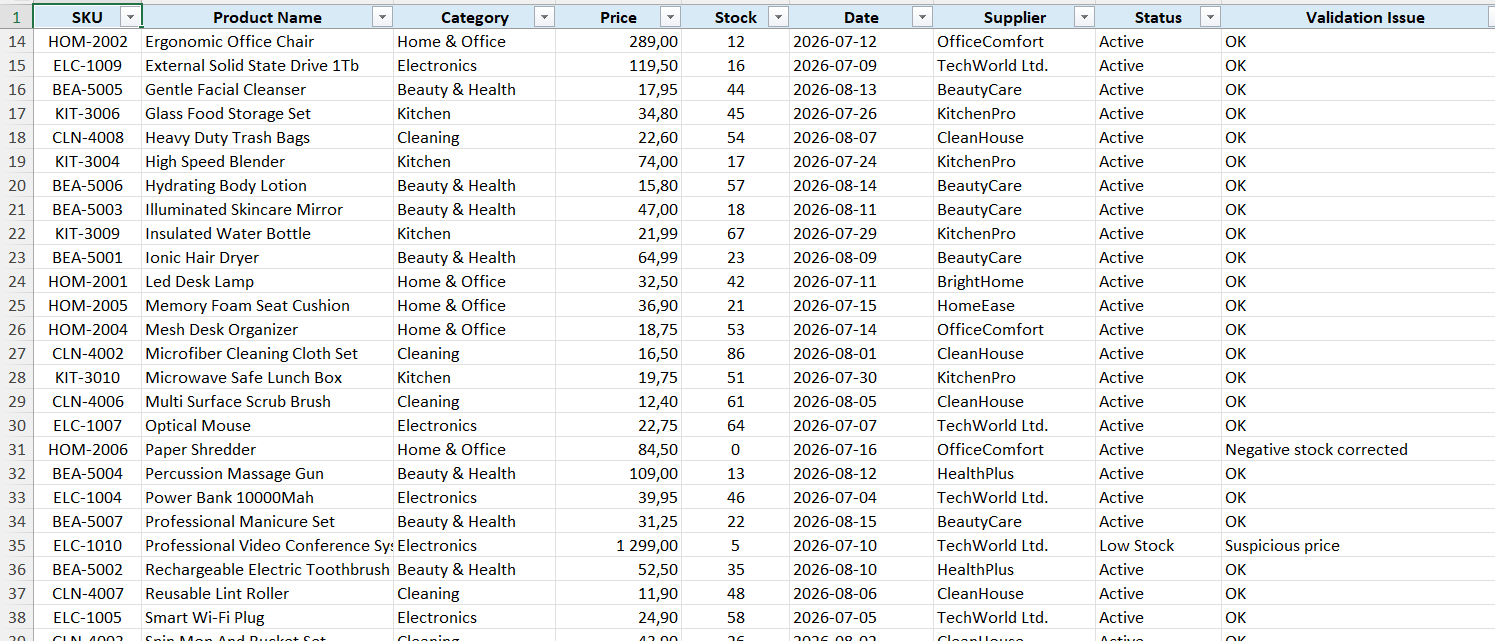
- приводит цены, даты и остатки к единому формату;
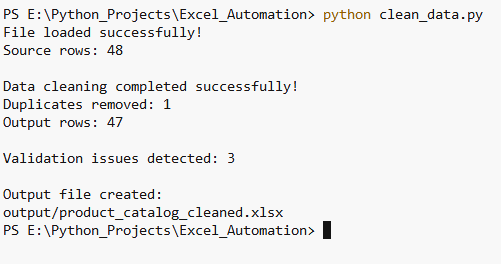
- удаляет дубликаты по SKU;
- добавляет проверки качества данных и помечает проблемные строки;
- формирует итоговый Excel-файл с удобной структурой и форматированием.
Также был подготовлен более наглядный выходной файл с понятным названием листа, структурой колонок и итоговым отчётом по обработке.
В результате получился инструмент, который заметно сокращает время ручной обработки товарных данных и уменьшает количество ошибок. Вместо ручной чистки таблиц пользователь получает готовый Excel-файл с уже обработанными и проверенными данными.
Такой подход особенно полезен для задач, где регулярно поступают новые CSV-файлы от поставщиков и нужно быстро превращать их в чистый, удобный и пригодный для работы формат.