- Опыт работы
- 3 года
- На сайте с
- 2026 года
- Юридический статус
- Самозанятый
Задача выросла из очень частого запроса, который звучит примерно как "прикрутите нам нейросеть". Когда начинаешь разбираться, за этой фразой почти всегда стоит одно и то же. Люди попробовали ChatGPT в браузере, им понравилось, но в рабочий процесс это никак не встраивается.
Что именно нужно было решить.
- Текст генерируется, но нигде не сохраняется, история теряется, версии сравнить нельзя
- Каждый сотрудник пишет промпт как умеет, и результат каждый раз в разной тональности
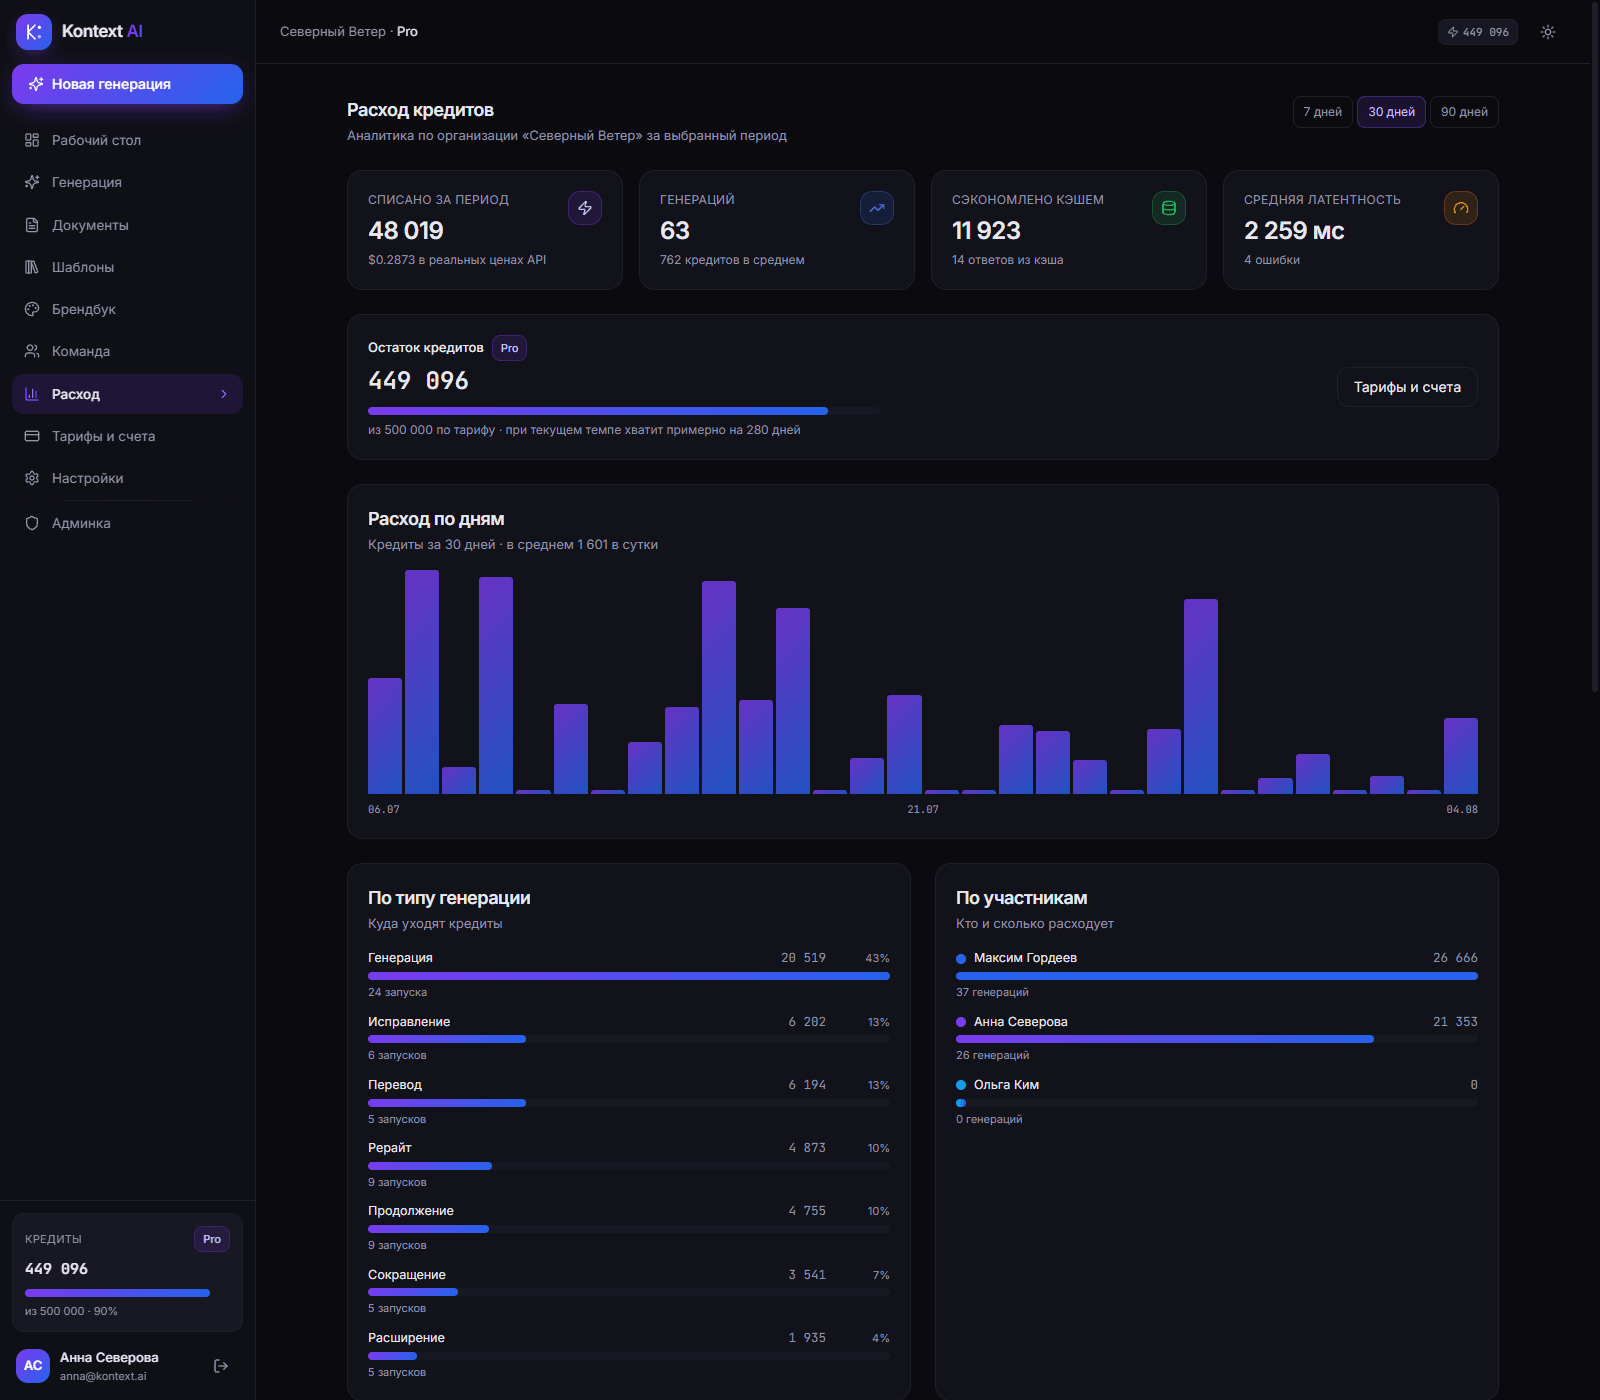
- Нет учёта, сколько это стоит компании и кто сколько потратил
- Если внешний провайдер лёг или упёрся в лимит, всё просто перестаёт работать, и пользователь видит красную ошибку
- Ждать двадцать секунд молчания перед появлением текста никто не готов
Отсюда цель. Не обёртка над чужим API, а рабочий инструмент. Текст печатается в реальном времени, как в ChatGPT. Шаблоны и тональность бренда задаются один раз и применяются ко всем. Расход считается в понятных единицах и упирается в лимиты тарифа. При падении одного провайдера система переключается на другой, а не падает вместе с ним.
Открыть можно здесь.
https://kontext.guskovdev.ru
Вход anna@kontext.ai, пароль demo1234
Стек - Next.js 15, React 19, TypeScript в строгом режиме, Tailwind, Prisma. Авторизация своя, сессии в базе.
Ядро проекта - слой работы с языковыми моделями.
- Отдельные провайдеры для Anthropic Claude API и OpenAI API, у каждого свой формат потокового ответа и свои особенности, которые пришлось разбирать по документации
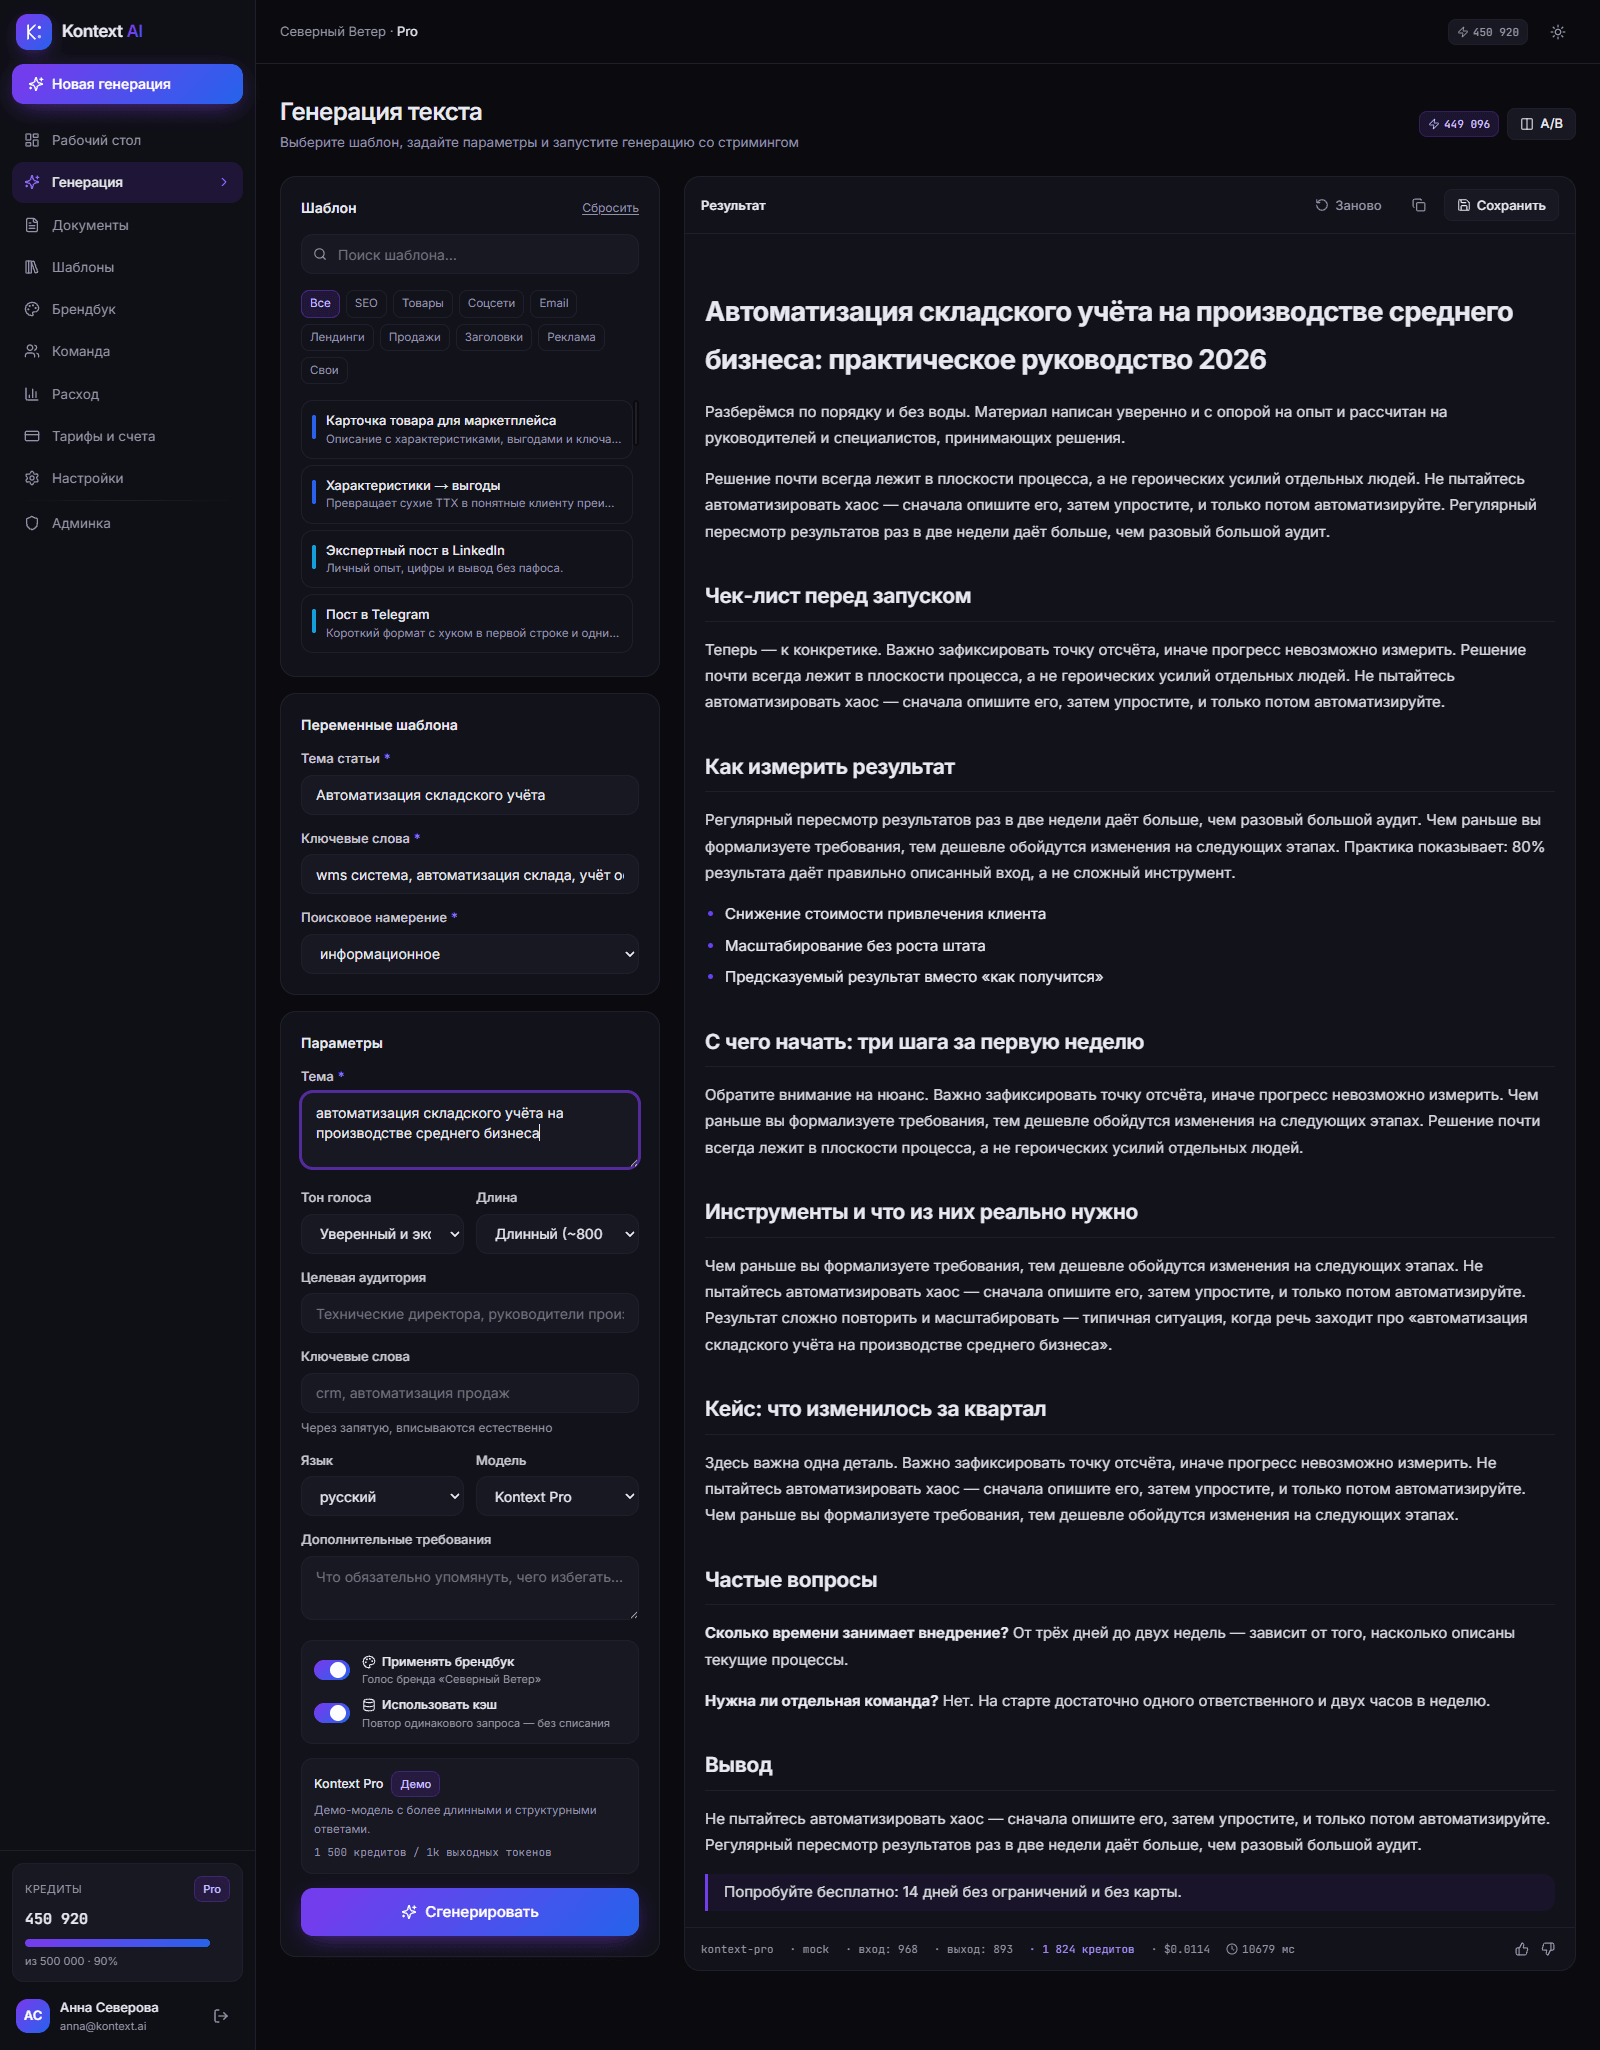
- Потоковая выдача через SSE, текст появляется посимвольно, с корректной остановкой по кнопке
- Каскад запасных вариантов. При ошибке или таймауте запрос уходит следующему провайдеру, а пользователь видит понятное сообщение вместо стектрейса
- Подсчёт токенов и пересчёт в кредиты, с проверкой лимитов до начала генерации, а не после
- Кэш по хешу промпта, повторный одинаковый запрос не тратит деньги
- Модерация ввода и проверка результата на соответствие правилам бренда
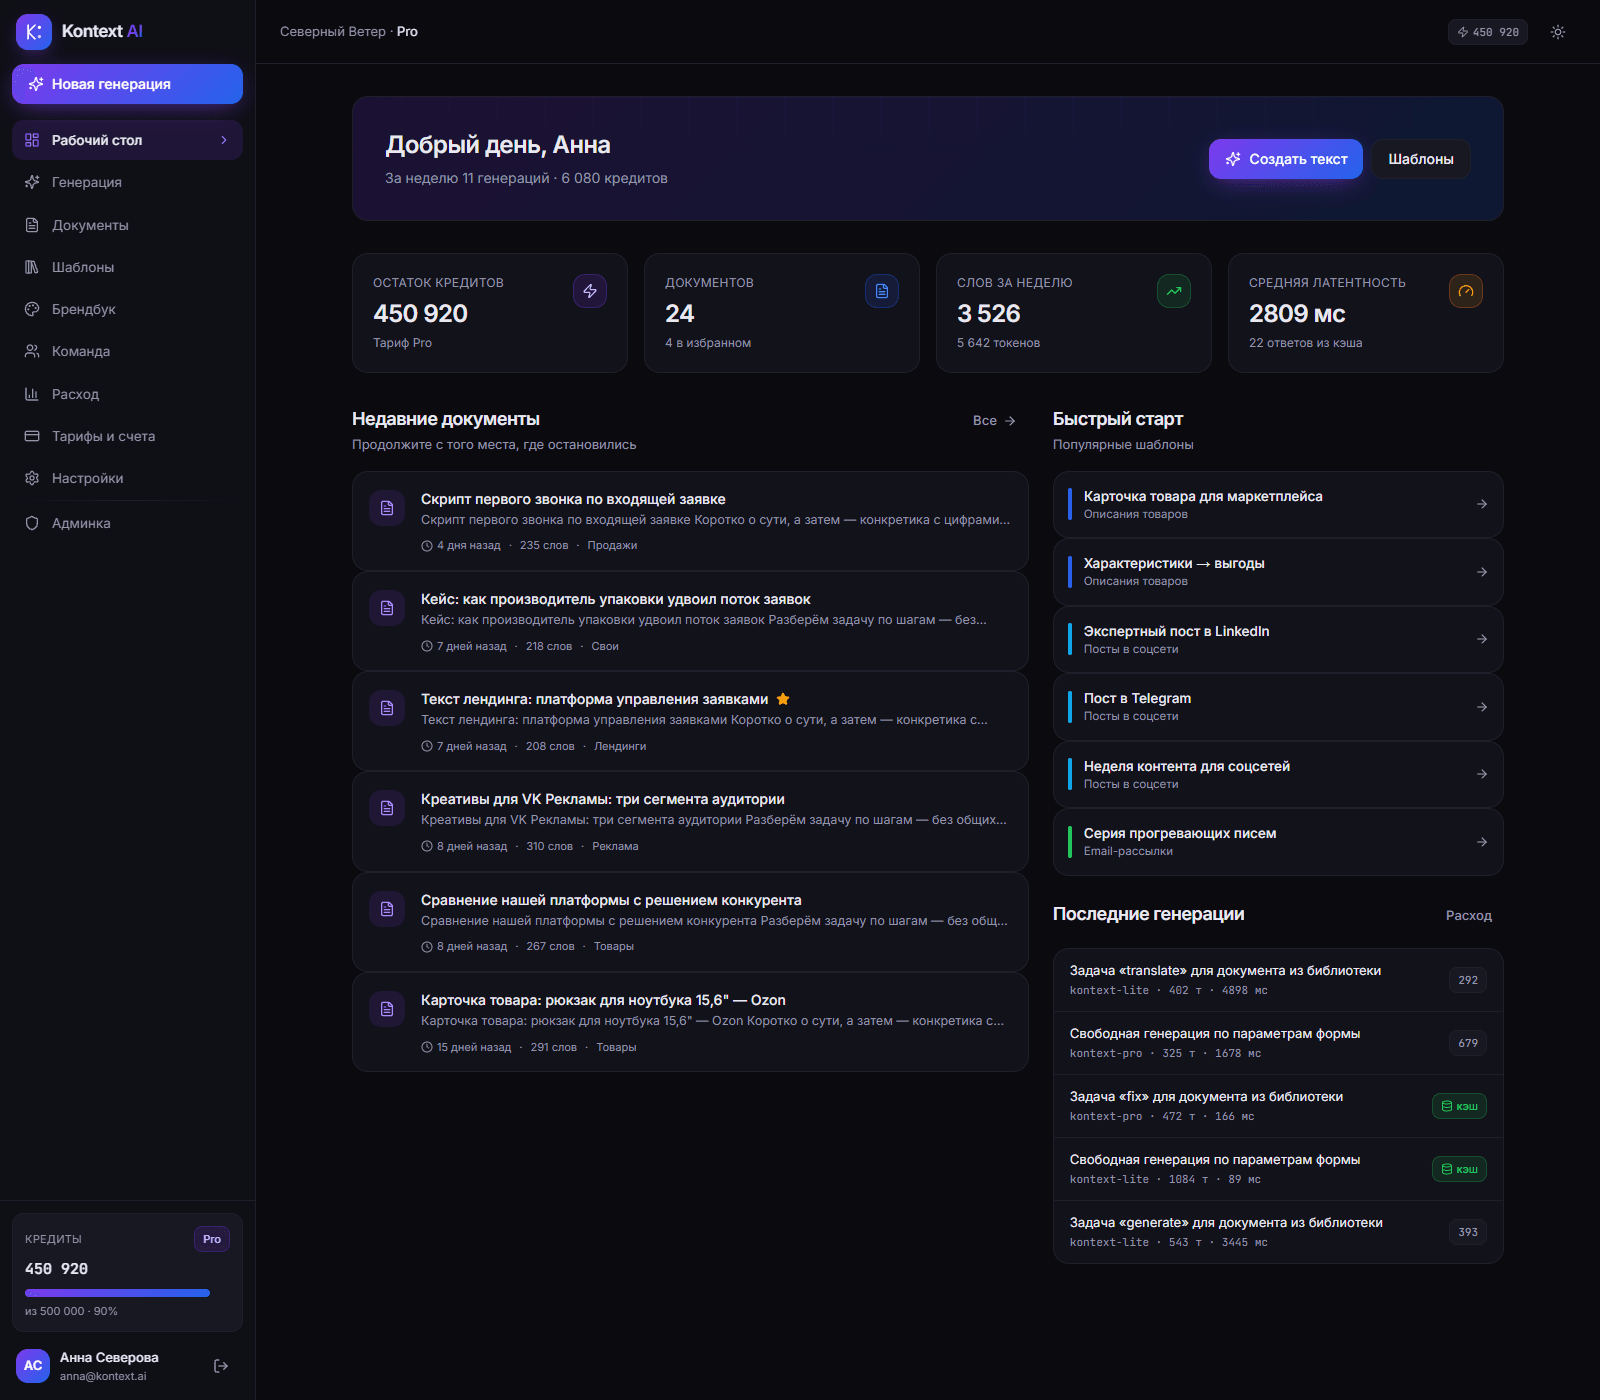
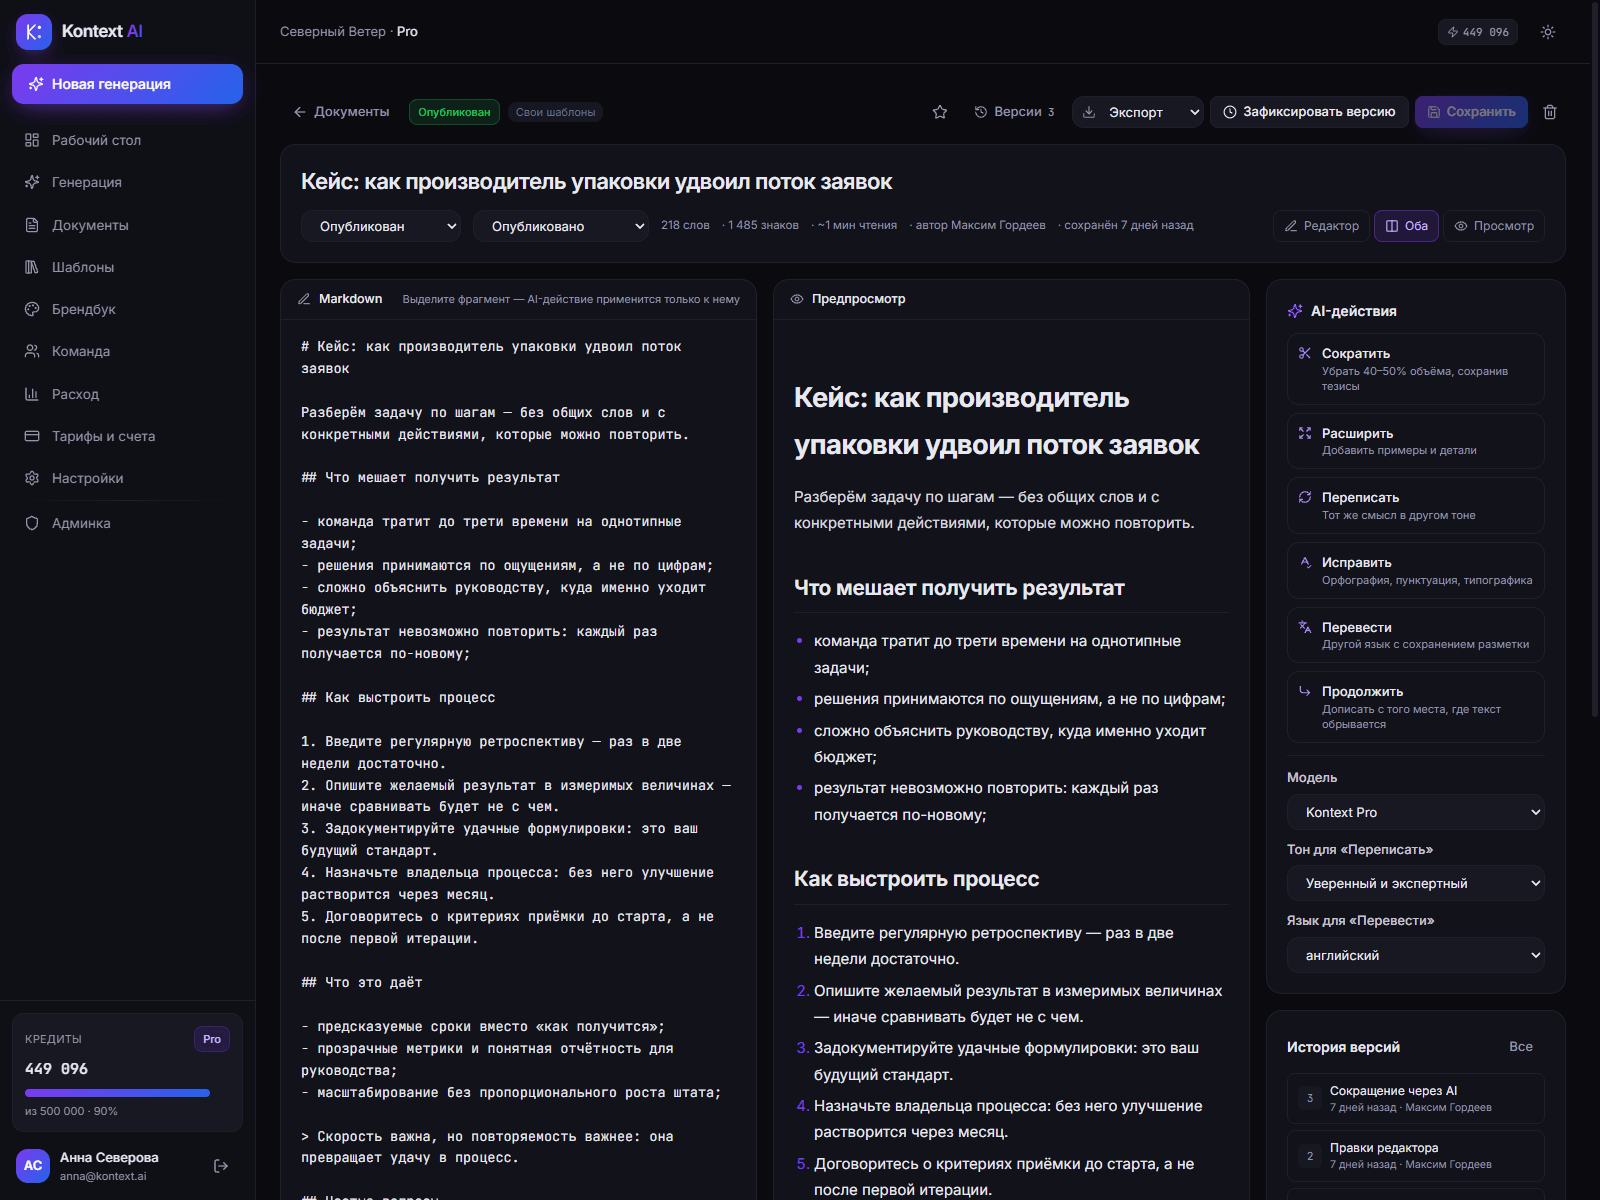
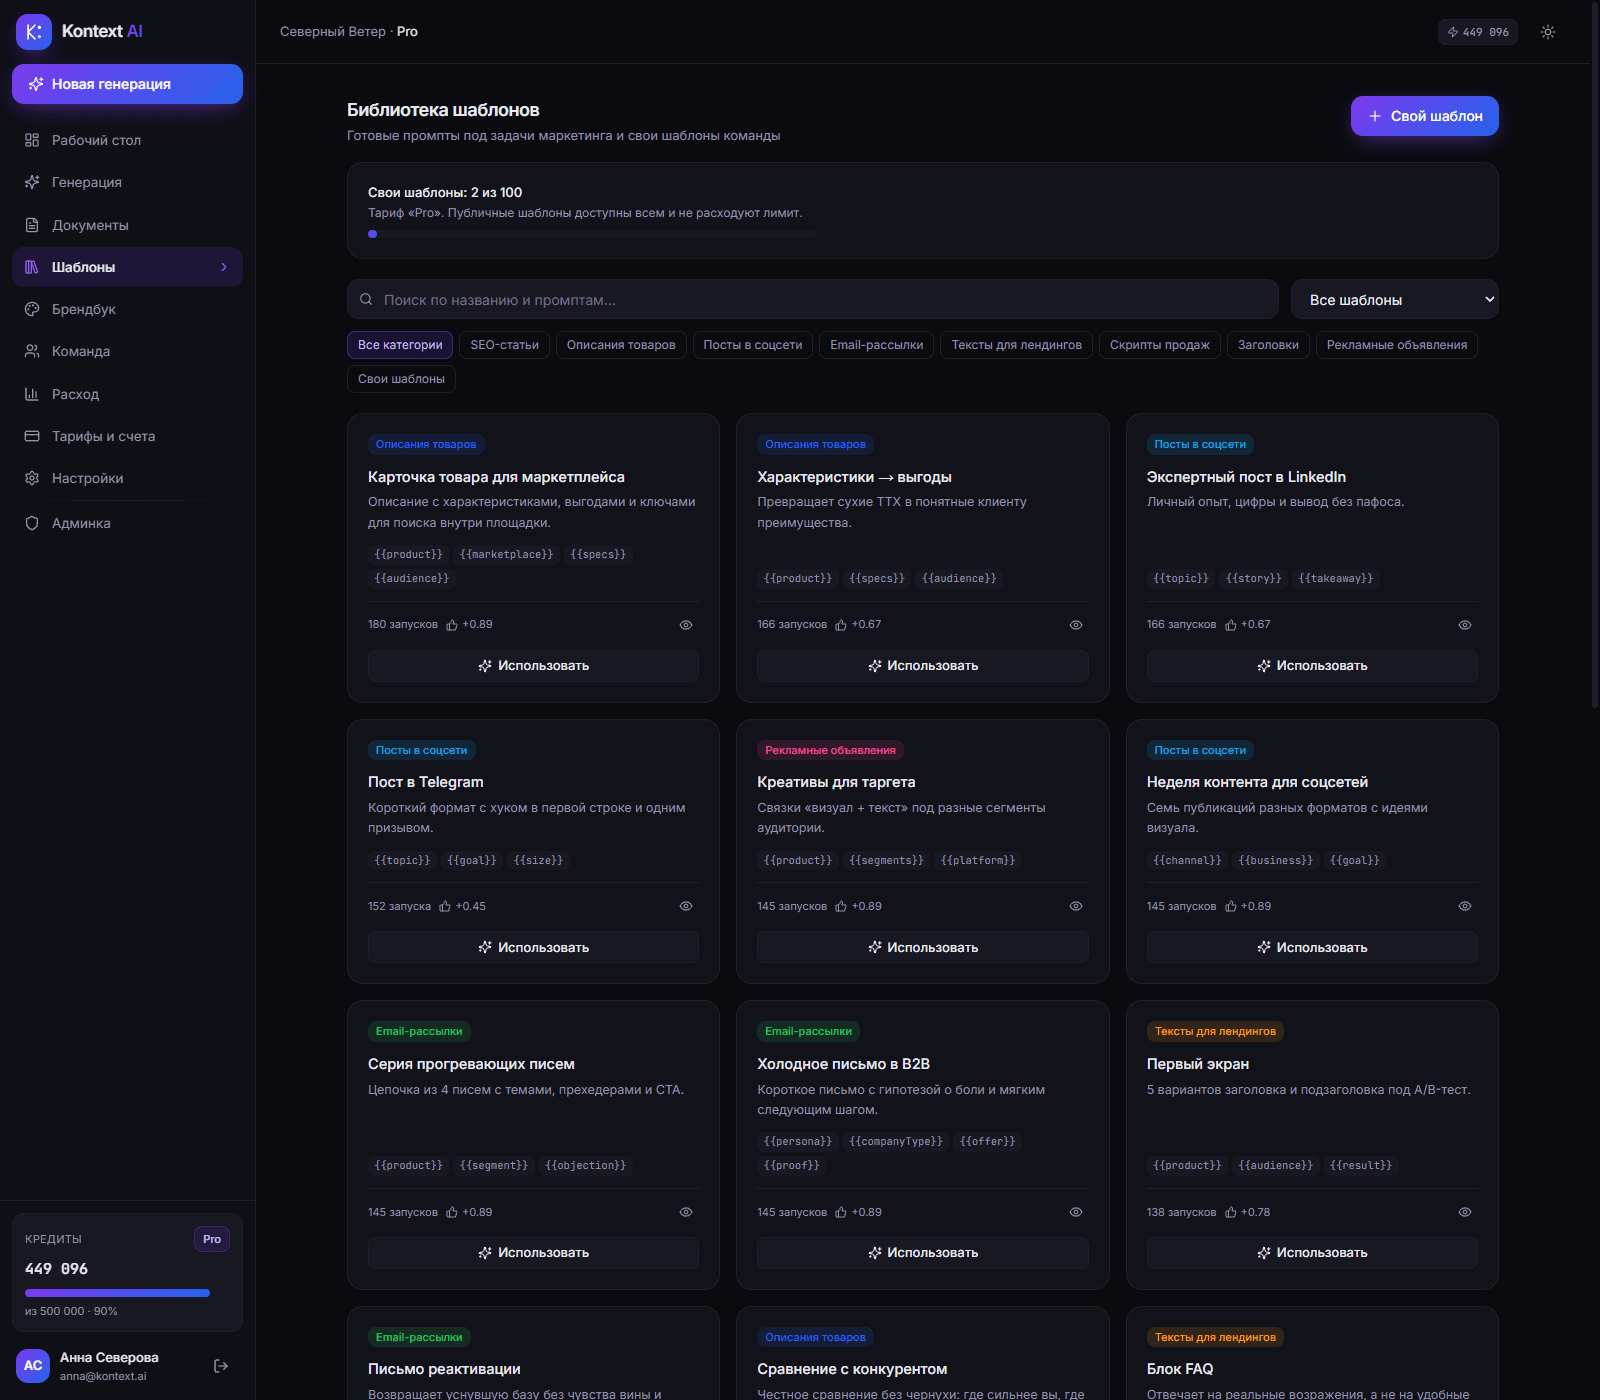
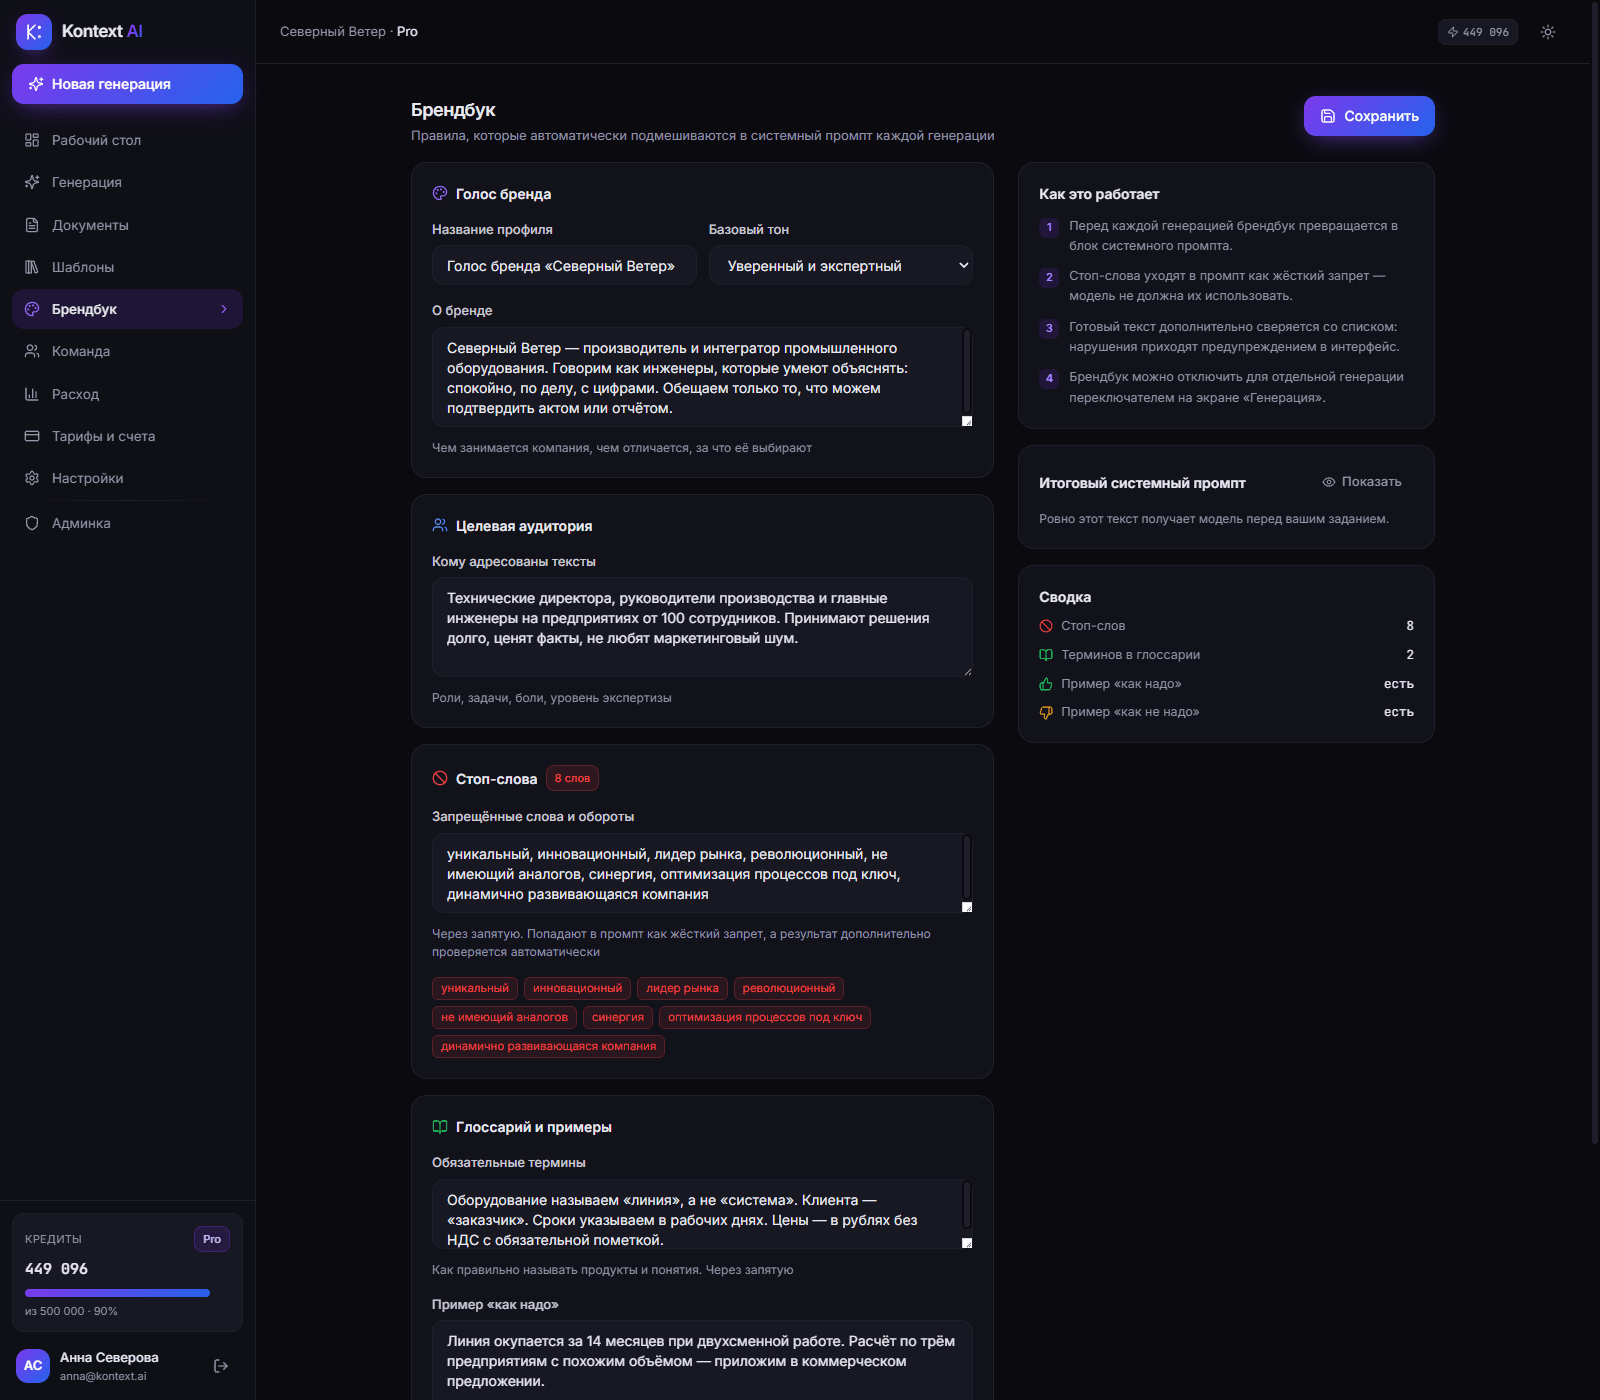
- Шаблоны, брендбук с тональностью, история документов с версиями и экспортом
- Журнал действий и аналитика расхода по пользователям
Отдельно про то, как устроен сам стенд, потому что это тоже инженерное решение.
Провайдер выбирается одной переменной окружения, а публичный стенд запущен в режиме без боевых ключей. Иначе любой посетитель тратил бы деньги на токены, а страница с открытым API-ключом в интернете - это просто вопрос времени до счёта на несколько десятков тысяч.
При этом поток настоящий. Стенд отдаёт полноценный SSE чанками переменной длины, с задержкой до первого токена, с разбросом задержек, с поддержкой отмены и с отчётом по токенам. То есть клиентский код, код стриминга, учёт кредитов и все состояния интерфейса работают ровно так же, как с боевым ключом. На проекте заказчика ключ подставляется в переменные окружения, и система идёт в Claude или OpenAI без единой правки в коде.
https://kontext.guskovdev.ru
Вход anna@kontext.ai, пароль demo1234
Замеры Lighthouse по публичной странице от 6 августа 2026 года, медиана из трёх прогонов.
- Производительность на десктопе 100 из 100
- Производительность на мобильной эмуляции 78 из 100
- Доступность 98, лучший показатель среди моих проектов
- Лучшие практики 100
- SEO 100
- Сдвиг макета CLS ровно 0
Именно на этом проекте одиночные прогоны подряд дали 100, потом 59, потом 96 - при том что все запросы возвращали код 200, а время ответа сервера держалось в пределах 20-30 миллисекунд. Просто машина была занята. Поэтому я меряю тремя прогонами на свободной машине и беру медиану, а не публикую самый красивый результат.
Мобильные 78 упираются в один общий чанк скриптов, который публичная страница подтягивает вместе с кодом приложения. Причина названа в отчёте, лечится разделением бандла, это работа примерно на день и она заложена в план.
Как применяется на практике.
Это заготовка для встраивания языковой модели в чужой продукт. Типичный запрос звучит как "нам нужен AI-помощник внутри нашего сервиса", и дальше выясняется, что сложность вовсе не в вызове API, а во всём, что вокруг него. Потоковый вывод, отмена, повторы, фолбэки, учёт расхода, лимиты по тарифам, история, права доступа. Всё это здесь уже написано и работает, поэтому на проекте заказчика оплаченное время уходит на его продукт, а не на инфраструктуру вокруг нейросети.