Парсер сайтов и сбор данных на Python
Разработаю парсер на Python для сбора и обработки данных с сайтов.
Можно собирать:
— товары и цены;
— характеристики товаров;
— наличие и остатки;
— объявления;
— публикации;
— ссылки;
— каталоги;
— другие структурированные данные.
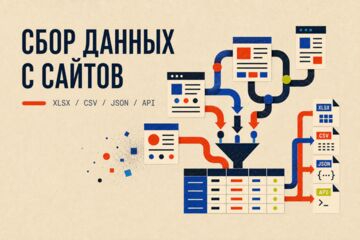
Результат можно сохранять в XLSX, CSV, JSON или PostgreSQL.
При необходимости добавлю:
— обход страниц и пагинацию;
— фильтрацию и очистку данных;
— удаление дублей;
— сбор данных из нескольких разделов сайта;
— сравнение с результатами предыдущего запуска;
— отслеживание изменений цен, наличия и других значений;
— уведомления в Telegram;
— автоматический запуск по расписанию.
Для динамических сайтов использую Playwright. Если нужные данные доступны через API сайта, могу получать их напрямую.
Также могу добавить обработку собранных данных с помощью AI: классификацию текстов, извлечение нужной информации, создание кратких описаний, распределение данных по категориям и другие сценарии.
Работаю с общедоступными данными. В услугу не входит взлом авторизации, получение закрытой информации и обход CAPTCHA.
Результат: исходный код Python-парсера, данные в XLSX, CSV, JSON или PostgreSQL и README.md с инструкцией запуска.
Для начала работы понадобится ссылка на сайт и пример страниц, с которых нужно получать данные. Укажите перечень необходимых полей и желаемый формат результата. Если есть пример итоговой таблицы или файла — приложите его.
- Ключевые слова:
- rest
- api
- llm
- docker
- postgresql
- httpx
- playwright
- python
- pandas
- beautifulsoup
- openpyxl
